LFM2.5-24B-A2B 本地部署:Mac 内存需求与 GGUF、MLX 选择
LFM2.5-24B-A2B 能在 Mac 上运行吗?梳理 24B MoE 与激活参数、4/5/8-bit 文件体积、GGUF 和 MLX 选型、许可边界与可复现测试清单,不冒充实测。
Evidence 4 条资料来源
本文目录
LFM2.5-24B-A2B 部署资料说明(2026-10-18):本文依据官方来源并附可复核的 Mac 内存容量预检工具,但没有下载或运行 LFM 模型,因此不提供 XBSTACK 推理速度或准确率实测。
直接回答: LFM2.5-24B-A2B 是 Liquid AI 2026 年 10 月 13 日发布的 24B 总参数、约 2.45B 激活参数的 MoE 模型。能否在 Mac 上运行,不能只看“2B 激活”:它仍需要加载约 24B 参数的模型权重。官方 MLX 4-bit 模型文件约 13.6GB,5-bit 约 16.5GB,8-bit 约 25.5GB。文件大小不是统一内存门槛;上下文缓存、框架开销、macOS 和其他 App 都要占内存。16GB 统一内存不宜被宣传为稳定可用的配置;32GB Mac 更值得作为量化版本的测试起点,但具体能否稳定运行仍以设备实测为准。
先确认是否真的是适合你的模型
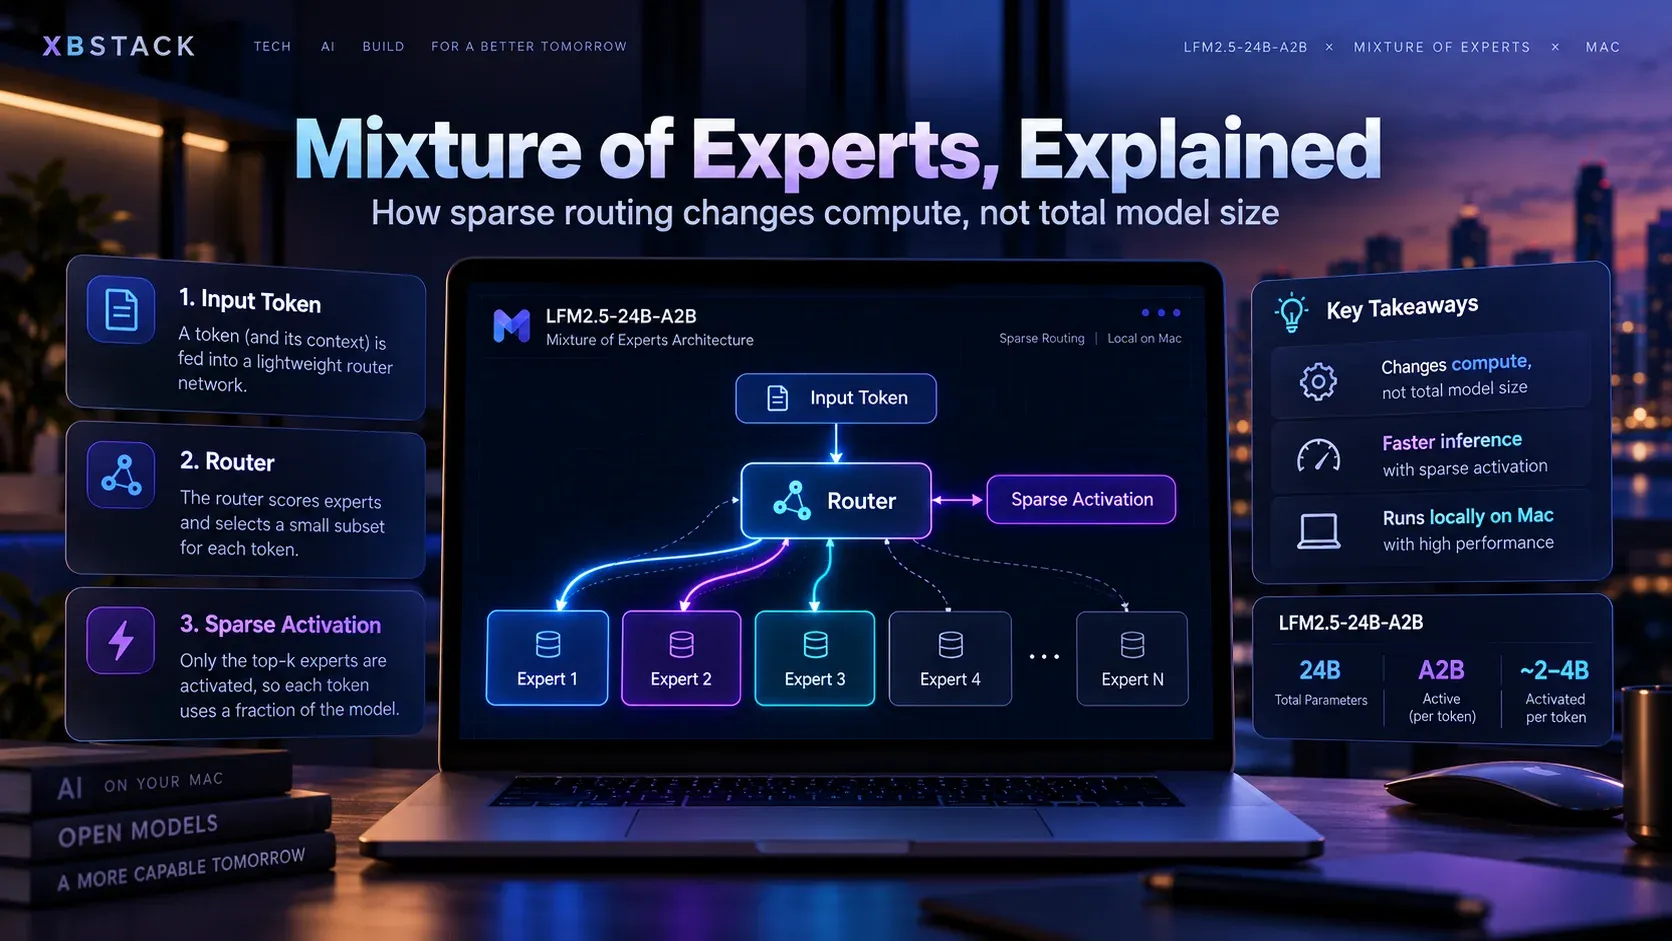
Liquid AI 发布的是 LFM2.5 系列中的大规模 MoE 指令模型,官方描述为 24B 总参数、约 2.45B 激活参数,面向本地 Agent、工具调用与推理任务。它不是仅占 2B 参数内存的小模型。稀疏专家结构主要影响每一步计算量,不会把已加载的全部专家权重自动变成 2B。
官方发布文章称其在部分 Agent 和 Tool Use 基准上与其他 MoE 模型有竞争力,并报告 Apple M5 Max 上约 184 tokens/s 的特定成绩。这是厂商公开结果,不是 XBSTACK 在 Mac 上测出的速度。具体配置、量化、提示长度、并发、预填充速度和生成速度应分别核验。
官方参考:
Mac 的内存怎么估算
| 选择 | 官方模型仓库展示的文件体积 | 对设备的意义 |
|---|---|---|
| MLX 4-bit | 约 13.6 GB | 较低权重占用;需额外留系统与 KV Cache 空间 |
| MLX 5-bit | 约 16.5 GB | 权重更大;可能减少部分量化损失,但需实际比较 |
| MLX 8-bit | 约 25.5 GB | 权重占用进一步增加;更不适合紧张的统一内存 |
上述数字源自模型托管页,截至 2026-10-18。它们既不是一次任务的总内存峰值,也不是 Apple 官方设备兼容性认证。尤其长上下文、较大批处理与较多并发请求会增加缓存与运行时内存。
实用判断: 如果只有 16GB 统一内存,不建议直接下载 13.6GB 权重后假设可以正常运行;可以优先考虑更小的模型。32GB 是量化模型可进行本地验证的合理起点,但不是“保证顺畅”的最低配置。如果你需要长上下文、后台其他进程常驻或稳定 Agent 服务,更大的统一内存更有弹性。不要把这个建议当成已测最低规格表。
选择 GGUF 还是 MLX
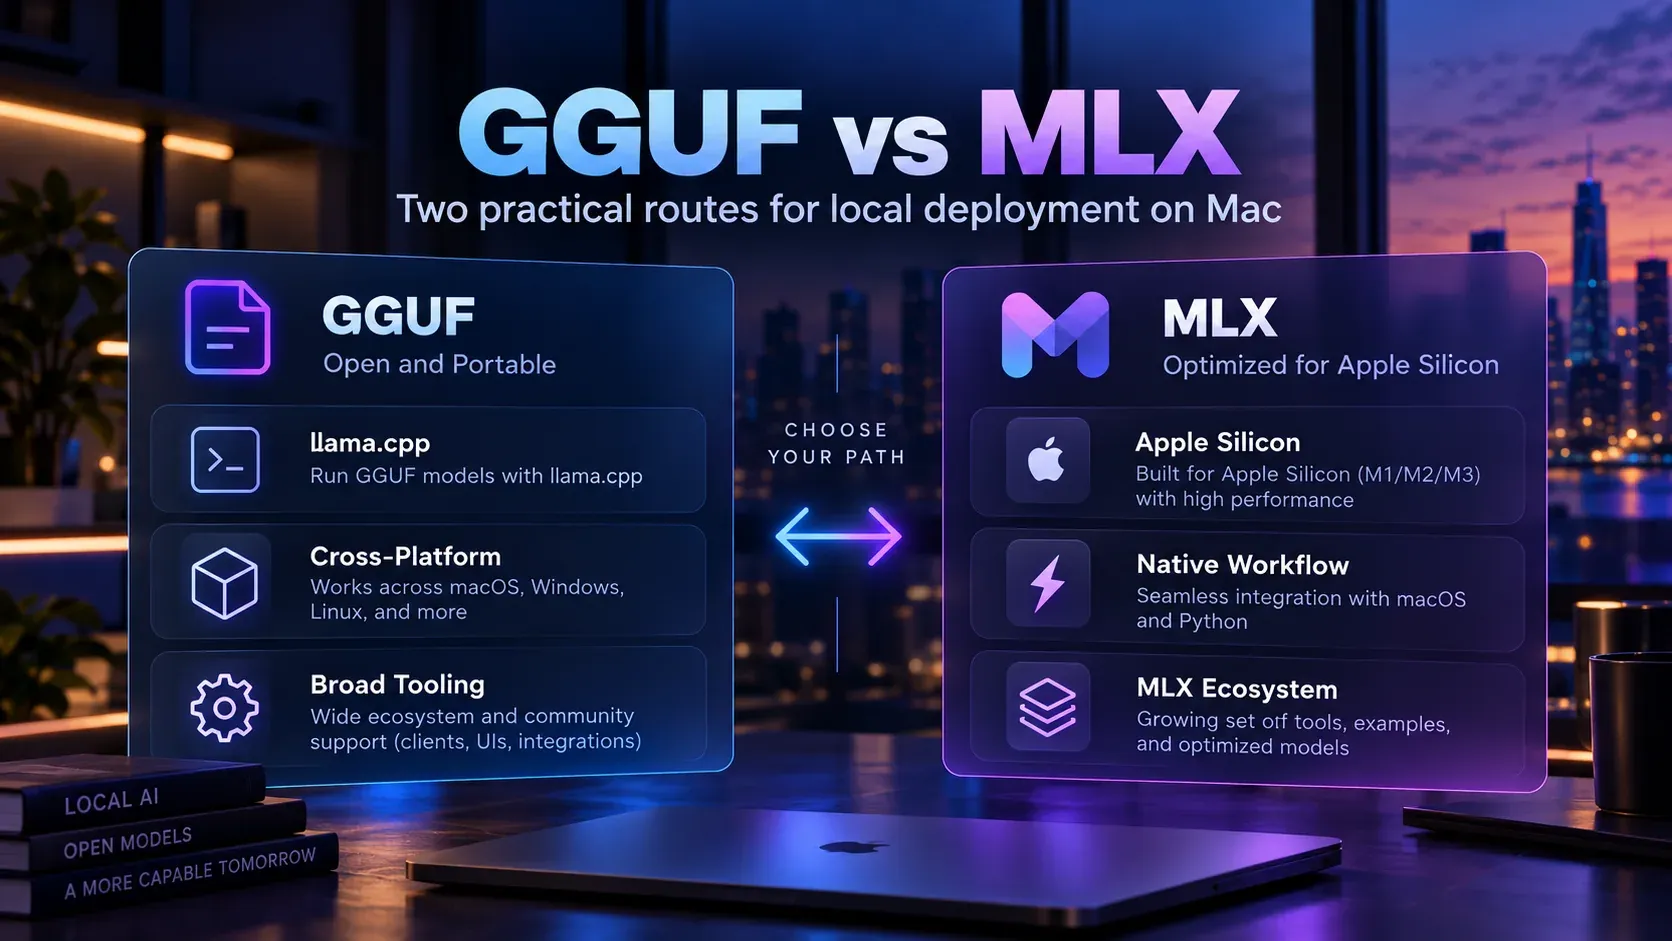
GGUF + llama.cpp 适合希望跨 macOS、Linux、Windows 复用同一种部署方式、快速用本地 HTTP 接口连接 Agent 的开发者。Liquid AI 官方 GGUF 仓库给出以下形式的运行入口:
# 安装好与你的系统兼容的 llama.cpp / llama CLI 后运行
llama cli -hf ggml-org/LFM2.5-24B-A2B-GGUF:Q4_K_M

# 需要本地 OpenAI-compatible 服务时
llama serve -hf ggml-org/LFM2.5-24B-A2B-GGUF:Q4_K_M
命令写法取自官方模型仓库,尚未在 XBSTACK 机器上复核运行;请先确认当前 CLI 子命令与运行时是否支持对应 MoE 模型。首次执行会下载大文件,建议检查磁盘剩余空间、模型校验、进程内存和许可证。
MLX 更适合 Apple Silicon 上的原生模型测试,但不是“下载一个 MLX 文件就一定能运行”。应对照发布方 README 采用兼容的 MLX / mlx-lm 版本和加载方法,确保该版本已支持 LFM2 MoE 架构与模型聊天模板。选择 4-bit 起步,完成正确性测试后,再比较 5-bit 和其他精度配置。请注意 MLX 量化模型可能与 GGUF 的量化方法不同,不能仅用体积作质量结论。
下载可复核的 Mac 内存预检工具
与未经实测的“16GB 最低配置表”不同,XBSTACK 提供一个原创、可查看源码的 Python 预检脚本:读取 Mac 的真实物理内存(sysctl hw.memsize),再把官方模型文件体积和用户自行设定的系统/运行时预留量做预算比较。它不会下载或加载模型。即使显示容量有余量,也不保证实际推理框架兼容、模型加载成功或达到指定上下文长度。
下载 Mac 内存预检脚本(仅 Python 标准库,无第三方依赖)。
python3 lfm25-mac-preflight.py --variant mlx-4bit
python3 lfm25-mac-preflight.py --memory-gib 32 --variant mlx-5bit --reserve-gib 8
本站可复现证据(2026-10-18): 已在当前 Mac 上执行预检,系统报告物理内存 16 GiB。按 MLX 4-bit 模型文件约 13.6 GB、另假设系统与运行时占用 6 GiB,预算余量为 -2.67 GiB。这是容量估算,不是模型推理失败记录:没有下载、加载或执行模型。即使在更大内存设备上得到正余量,也不能保证实际模型兼容、性能或可靠性。
LFM Open License v1.0 的商业使用限制
Liquid AI 的官方许可证允许在许可条件下使用、修改与再分发模型,也允许符合门槛的商业使用;重新分发时应保留版权和许可证声明。按照第 5 条,实体年营收达到或超过 1,000 万美元 时,商业使用需另行取得商业许可。最终应以完整的当前许可文本和具体模型条款为准,本文不是法律意见。
可复现的最小验收流程
不要上来就声称测出“最快”或“能跑 128K 上下文”。建议先按下面的标准记录:
- 环境快照: 设备型号、Apple 芯片、统一内存、macOS 版本、推理框架版本、模型仓库及具体 revision、量化类型。
- 冷启动: 模型下载体积、首次加载时间、加载阶段峰值内存、是否触发 swap 或被系统终止。
- 单轮推理: 固定简短提示词,重复 3 次;分别记录首 token 延迟、生成 token/s、实际产生的 token 数。
- 长上下文: 以小步增长方式试 4K、8K、16K;分别记录上下文处理耗时、输出准确性和内存变化。模型支持的理论上下文长度不代表所有量化及硬件组合都能跑满。
- Agent 验证: 固定工具清单、结构化工具调用参数、错误工具输出与重复调用;检查 JSON Schema、工具选择、失败恢复和结果复核。
- 长期运行: 在相同任务下连续调用并检查是否发生内存增长、超时、崩溃或明显速度衰减。
如果没有这些数据,最多可称为部署方法及硬件估算指南,不能写成 Mac 实测排行榜。
本地与云端怎样选
| 决策因素 | 本地部署更可能合适 | 云端托管更可能合适 |
|---|---|---|
| 数据处理 | 敏感资料不宜外传,且本地隔离条件可控 | 允许上传、企业已有合规的数据处理协议 |
| 初始成本 | 已有可用设备,使用频率足够高 | 不想预先采购高内存电脑或 GPU |
| 稳定服务 | 少量个人任务,能够接受本机离线和睡眠 | 需要跨设备访问、弹性扩缩和服务监控 |
| 运维能力 | 有时间维护模型、量化、补丁和运行时 | 希望将可用性与伸缩交给服务商 |
| 模型更新 | 接受手动下载、兼容性验证 | 接受 API 计费及供应商版本策略 |
不要将本地部署简化为“零成本”:设备折旧、电费、持续运行、备份和工程维护都是真实成本。也不要假设“开源权重”等于任何商业用途都无需审查。Hugging Face 模型卡标注 lfm1.0,采用 LFM Open License v1.0;在分发产品、提供模型服务或用于商业 App 前,必须逐条阅读完整许可证及附带条款,本稿不提供法律许可结论。
和较小模型的边界
对于手机端、16GB 笔记本和只需做轻量意图分类/格式提取的 Agent,24B 总参数模型可能不是效率最高的部署点。应先问:是不是需要复杂多步工具调用、长推理、多轮规划,还是本来只需小模型做路由?如果只是一个高频、低复杂度分类器,大模型可能在加载和内存成本上得不偿失。
对于 Personal AI / RAG,本地 LLM 也不是唯一瓶颈。FTS + 向量检索、证据筛选、Token Budget、召回准确率和引用校验通常需要独立评估。不能因为换成 24B 模型就假定检索结果或引用准确率自动提高。
相关技术实践
如果你正在构建本地知识库,而不是仅运行聊天模型,可参考 EmbeddingGemma 2 Mac 本地检索实测 区分嵌入模型、检索质量和生成模型的职责。若需要决定端侧模型如何接入跨设备 Agent,可进一步阅读 Personal AI Agent 架构设计,理解本地与云端分工、工具权限和记忆生命周期。更多运行时与端侧选型相关内容可从 Local AI 专题 继续查找。
关键结论
LFM2.5-24B-A2B 值得关注的是以较低每 token 激活计算量承载较大总参数规模,以及官方同时提供 GGUF 和 MLX 路线。真正的部署判断仍然取决于运行时支持、量化质量、系统总内存、任务可靠性和长期运维成本。
本稿没有做真实 Mac 测试,因此不提供独立生成速度、最低内存定论、云端 API 成本排名或模型胜负表。正式发布前,应补齐许可证复核、最小成功启动证据、关键版本与中英文搜索竞争审计。
参考来源与事实边界
- Liquid AI,2026-10-13:https://www.liquid.ai/blog/lfm2-5-24b-a2b (模型发布与厂商 Benchmarks)
- Hugging Face 原始模型卡:https://huggingface.co/LiquidAI/LFM2.5-24B-A2B (参数、变体、许可证标签)
- Hugging Face GGUF:https://huggingface.co/ggml-org/LFM2.5-24B-A2B-GGUF (官方运行入口)
- Hugging Face MLX 4-bit:https://huggingface.co/LiquidAI/LFM2.5-24B-A2B-MLX-4bit (13.6GB)
- Hugging Face MLX 5-bit:https://huggingface.co/LiquidAI/LFM2.5-24B-A2B-MLX-5bit (16.5GB)
- Hugging Face MLX 8-bit:https://huggingface.co/LiquidAI/LFM2.5-24B-A2B-MLX-8bit (25.5GB)
事实标签: 上述模型参数、发布日、文件大小与命令为官方公开资料;设备选择为工程判断;运行速度和质量未在 XBSTACK 本地复现。
下一步:继续搭建 Agent 系统
完整专题路径 →沿着架构、工具、Memory、评测、安全或生产治理继续推进,不必重新从头找资料。
参与讨论
问题、验证与勘误
登录后可发表评论。所有新评论先进入审核;审核期间仅评论者本人和管理员可见,通过后才公开。