小白 / Xiaobai
开发者 · 产品构建者
持续构建 AI 工程系统、开发者工具与长期数字资产。
关于作者与 XBSTACK →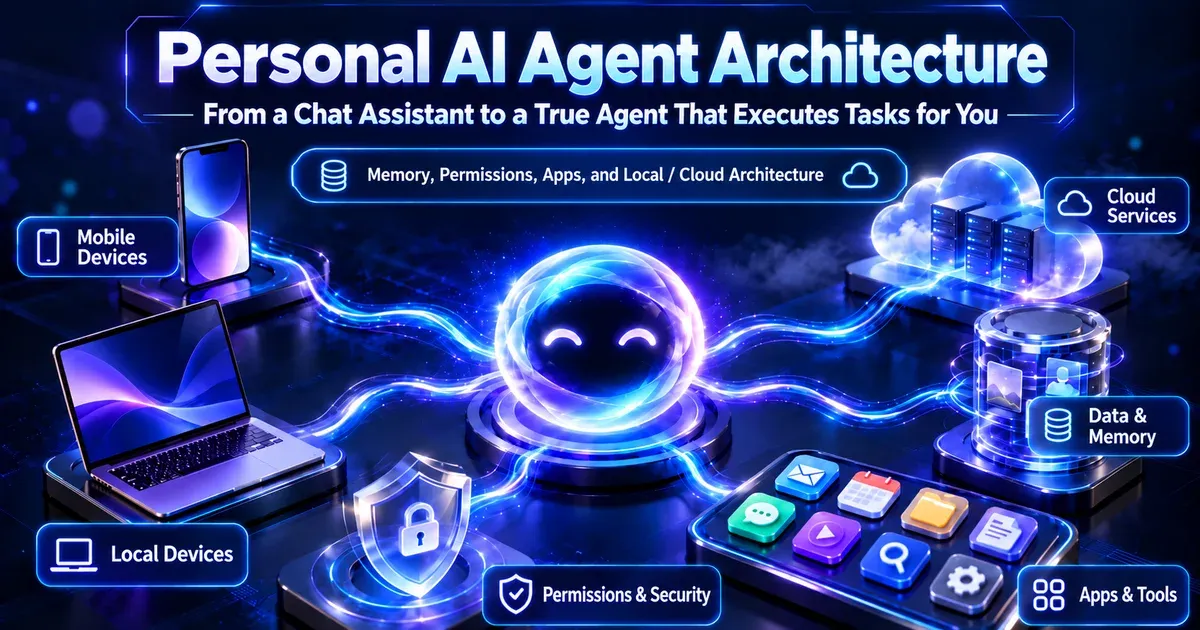
Personal AI Agent 架构:从聊天助手到真正替你执行任务,Memory、权限、App 与本地/云端怎么设计?
OpenAI Dot、Meta Muse、Apple Siri AI 正在把个人 AI 从“回答问题”推向“长期记住、持续工作、跨 App 执行”。本文给出 Personal AI Agent 的生产架构:Identity、Memory、State、RAG、Tools、权限、Credential、Approval、Local/Cloud Runtime 与 Audit,并结合 RecalAI 的本地优先实现说明哪些能力应留在设备端。
Personal AI Agent 架构:从聊天助手到真正替你执行任务,Memory、权限、App 与本地/云端怎么设计?
直接答案:Personal AI Agent 不是“更会聊天的 Chatbot”,而是一个长期存在、了解个人上下文、能连接真实工具并在权限边界内持续完成任务的软件主体。 真正的分水岭不是模型参数,而是系统是否拥有稳定 Identity、Long-term Memory、Current Task State、知识检索、执行环境、App/Tool 连接、Credential、Authorization、Approval、Audit 和 Recovery。
2026 年 9 月出现了一个很值得提前布局的信号:OpenAI、Meta、Apple 三家几乎同时把个人 AI 往“持续存在的执行者”推进。
- OpenAI Dot 拥有独立云端电脑,可长期从反馈中学习,通过插件连接 4,000 多款应用,并把访问、权限、操作审核和批准做成产品原语。
- Meta Muse 直接把自己定义为 Personal AI Agent:运行在专用 Secure VM 中,可以后台持续推进任务、操作浏览器和连接服务,并在发送邮件、购买等敏感动作前请求批准。
- Apple Siri AI 则从系统侧强化 Personal Context、Onscreen Awareness 和 Systemwide App Actions,让 AI 能把消息、邮件、照片、屏幕内容与系统 App 动作连起来。
三家的实现路径并不相同,但它们同时回答了一个问题:个人 AI 的下一阶段,不再只是“问我什么,我回答什么”,而是“我了解你的长期目标和上下文,并能在你允许的范围内持续帮你把事情做完”。
这也是为什么今天更值得提前占据的搜索入口,不是某个 SDK 的短期 Bug,而是 Personal AI Agent Architecture 本身。
Personal AI Agent 和普通 AI Assistant 到底差在哪?
可以把差异压缩成五层:
| 能力 | 普通 AI Assistant | Personal AI Agent |
|---|---|---|
| 交互 | 以当前对话为主 | 跨会话、跨设备、跨渠道持续 |
| 上下文 | 当前 Prompt / Context Window | Personal Context + Memory + Current State |
| 执行 | 主要输出文本 | 调用 App、API、Browser、Computer、Workflow |
| 时间 | 用户问一次、执行一次 | 可后台持续、事件触发、定时推进 |
| 权限 | 通常只控制“能不能用功能” | 每次高风险动作还要做 Authorization / Approval / Audit |
所以 Personal AI Agent 的产品主对象不应该只是 Chat。
更合理的抽象是:
User
  ↓
Personal Agent Identity
  ↓
Memory + Current State + Knowledge
  ↓
Planner / Reasoner
  ↓
Policy / Authorization / Approval
  ↓
Tools / Apps / Computer
  ↓
Artifacts / External Systems
  ↓
Audit / Recovery / Feedback
Chat、Voice、Slack、系统入口、穿戴设备,都只是进入这个长期 Agent 的不同界面。
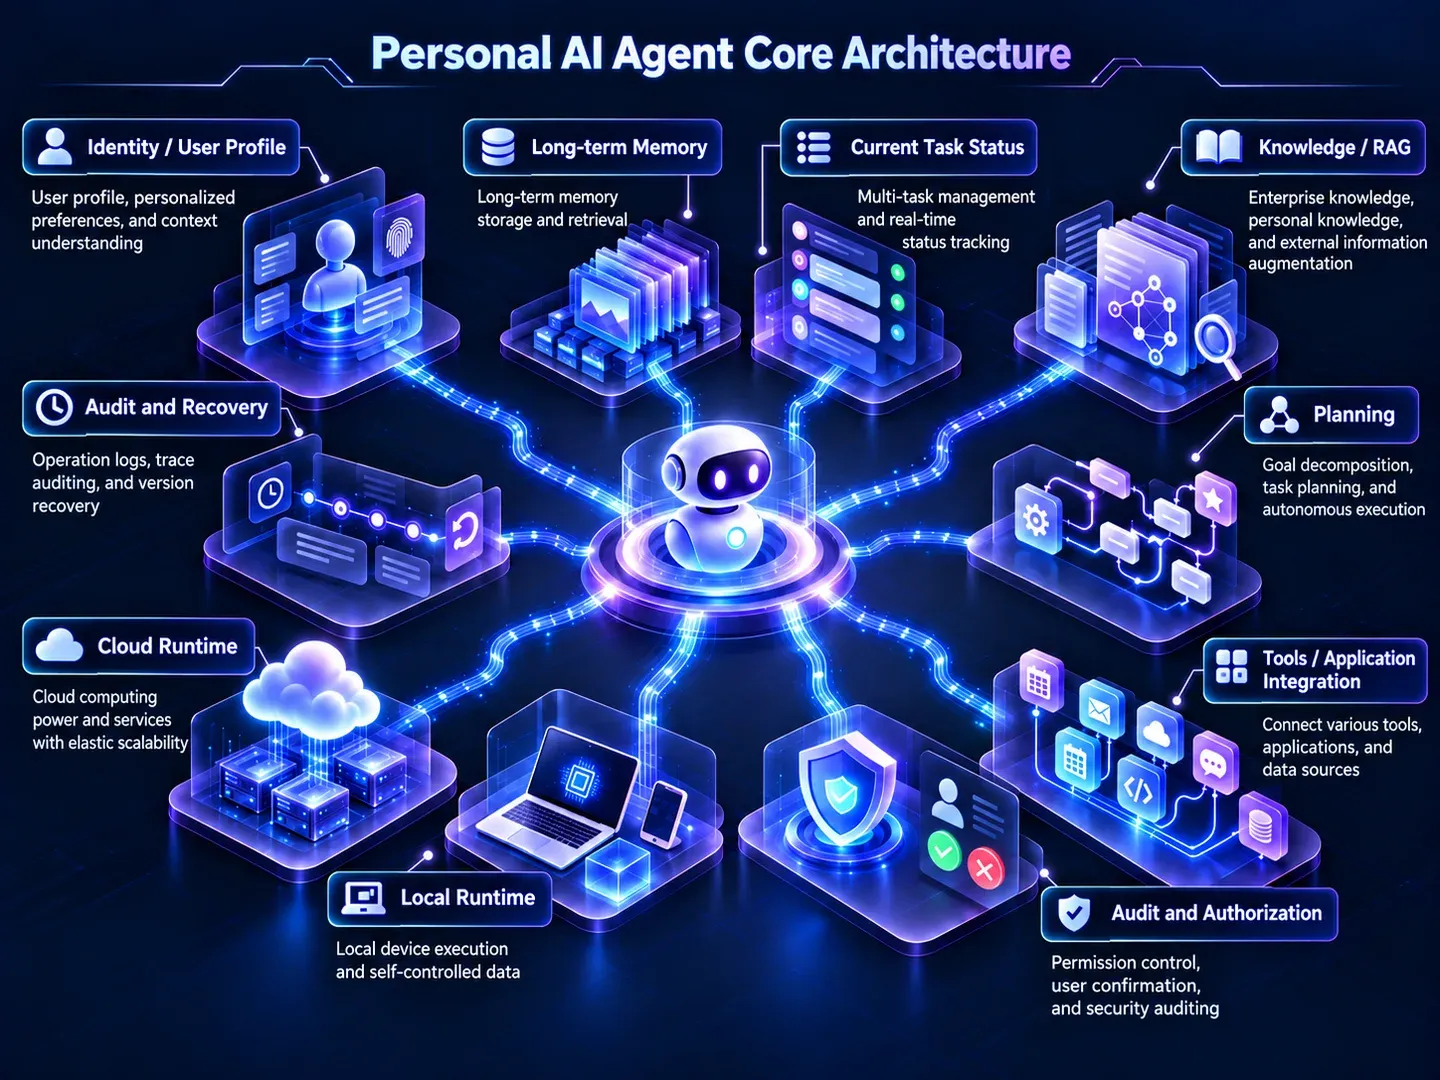
图 1:Personal AI Agent 不是单一模型,而是由身份、Memory、State、Knowledge、Planning、Tools、Runtime、Authorization 与 Audit 共同组成的长期执行系统。
一套生产级 Personal AI Agent,至少需要九层
1. Identity:先回答“它是谁、代表谁”
Personal Agent 不是匿名函数。
系统至少要知道:
- 当前用户是谁;
- Agent 是用户本人代理,还是家庭/组织中的一个角色;
- 它当前代表谁执行;
- 当前 Device / Session / Workspace 属于谁;
- 哪些权限是 Agent 自身拥有,哪些是临时委托。
OpenAI Dot 已经公开把“独立身份”放进产品设计;Microsoft 也在 2026 年 9 月把本地 AI Agent 的发现、治理和 Zero Trust 流量控制放进安全体系。
这意味着未来个人 Agent 的权限模型会越来越像“非人类身份 + 用户委托”,而不是“模型拿到一个 API Key 就开始工作”。
2. Current Task State:当前任务进行到哪
当前状态回答的是:
- 现在正在做哪个任务;
- 做到哪一步;
- 哪些 Action 已经执行;
- 哪些在等待用户批准;
- 哪些失败了,需要重试或回滚;
- 当前预算、Deadline、依赖是什么。
它不应该被塞进长期 Memory。
如果用户让 Agent “帮我找酒店、对比价格、确认时间、最后预订”,当前候选酒店、报价、支付步骤、Pending Approval 都属于 Task State。任务结束后,大部分内容应该归档或失效,而不是永久成为“用户记忆”。
3. Long-term Memory:什么信息以后仍然应该影响 Agent
真正值得长期保存的是:
- 稳定偏好;
- 长期目标;
- 项目约束;
- 已确认决策;
- 反复出现的工作方式;
- 能避免未来重复失败的经验。
这和“聊天记录全量保存”完全不同。
XBSTACK 已经在 AI Agent Memory vs RAG 中把 Memory、Session State、Checkpoint 和 Knowledge Base 分开。Personal Agent 只会让这条边界更重要,因为它接触的是长期个人数据,而且会真的影响未来动作。
4. Knowledge / RAG:个人资料库不是 Memory
用户保存的 PDF、网页、邮件归档、Word、PPT、照片 OCR、项目文档,更适合进入 Knowledge Base。
它们回答的是:
“当前任务需要什么证据?”
而不是:
“以后应该默认按什么偏好替这个用户做决定?”
以 XBSTACK 的 RecalAI 为例,现有第一方链路是:
保存原件
→ OCR / 解析
→ 规范化
→ Chunk
→ FTS 立即可搜
→ 后台 Embedding / 摘要 / 标签 / 图片理解

查询
→ FTS + Query Embedding
→ Chunk 混合召回
→ RRF / 去重
→ Rerank
→ Evidence
→ 本地或云端生成
这是一套 Knowledge + RAG 数据面。未来即使 RecalAI 扩展成更完整的 Personal Agent,长期用户 Memory、当前任务 State、账户/权限状态也不应该全部混进这套索引。
5. Planner / Reasoner:模型负责“建议怎么做”,不是决定“有没有权做”
这一层可以是一个大模型,也可以是多模型路由、规则系统、小模型分类器或专门的 Planner。
它负责:
- 理解目标;
- 分解任务;
- 选择工具;
- 判断缺什么信息;
- 规划下一步;
- 根据反馈调整计划。
但这里必须划清一条生产边界:
模型可以提出 Action,但模型不能因为自己提出了 Action,就自动获得执行权限。
这条原则同样适用于本地模型和云端模型。
6. App / Tool Connector:跨 App 不等于“模拟点击一切”
Personal Agent 最容易被宣传成“它能操作所有 App”。
工程上更合理的优先级应该是:
- 官方 API;
- OS 级 Intent / App Action;
- Plugin / MCP / Connector;
- 受控 Workflow;
- Browser / Computer Use;
- 最后才是高脆弱性的视觉点击自动化。
原因很简单:越靠前,参数、权限、结果和失败状态越容易结构化;越靠后,页面变化、登录状态、弹窗和视觉误判越容易让动作失控。
Apple Siri AI 的 Systemwide App Actions 更接近系统能力层;Dot 的插件生态属于 Connector 层;Muse 的 Secure VM + Browser 则证明远程 Computer 也会成为重要执行方式。
未来 Personal Agent 很可能不是只选一种,而是按任务动态选择最可靠的执行通道。
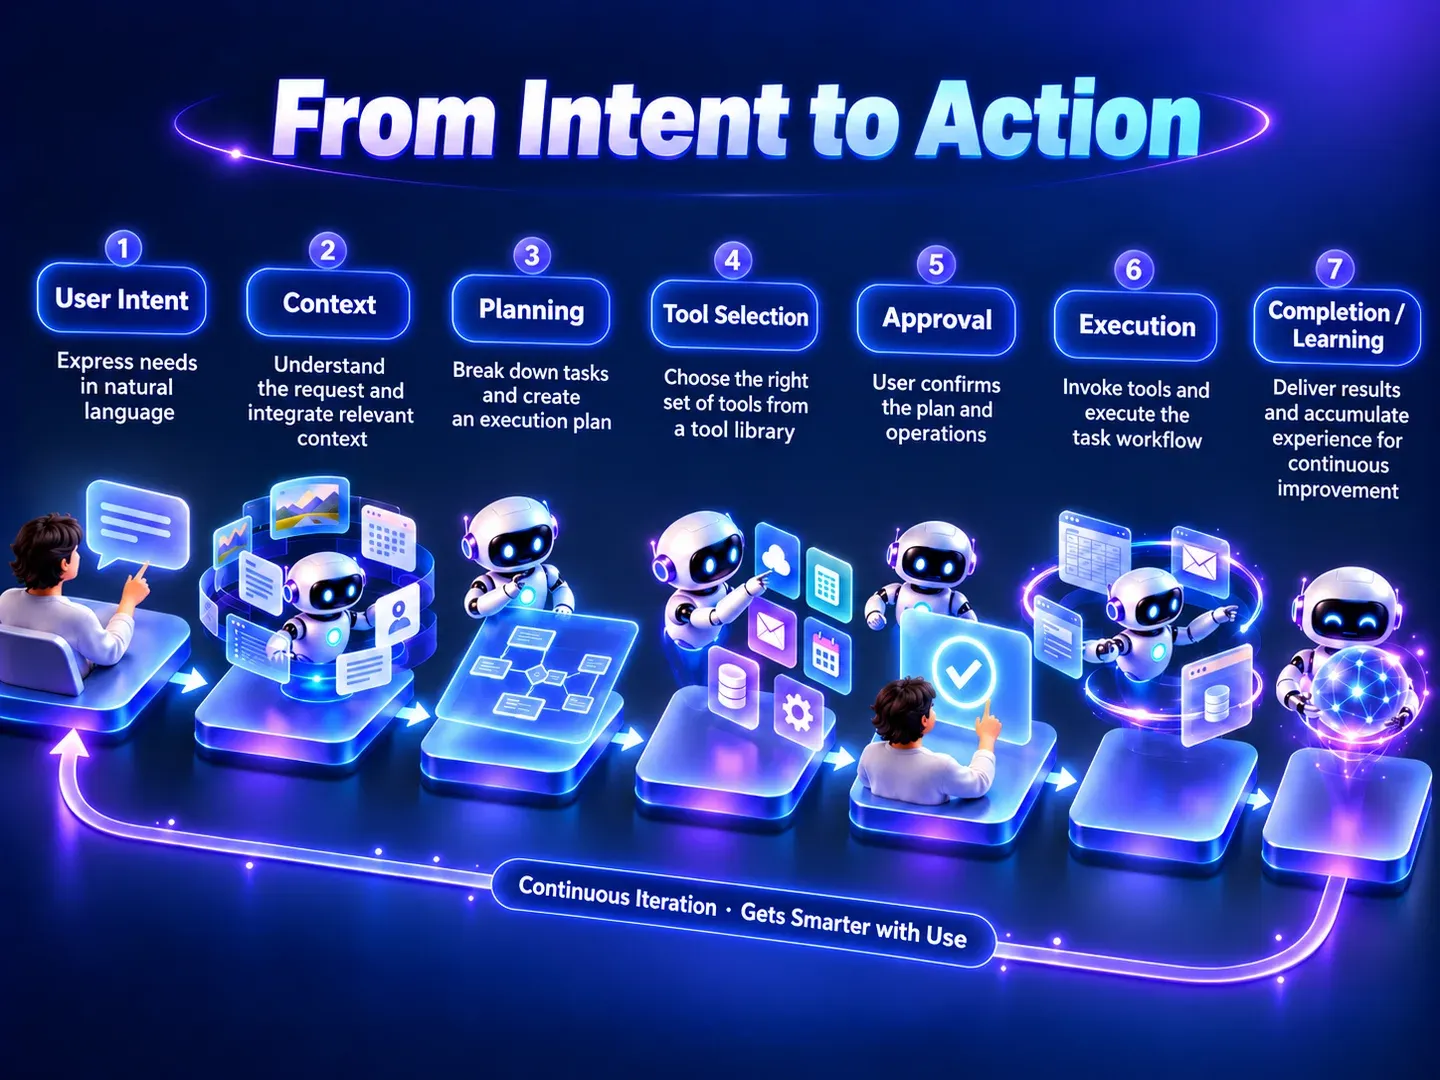
图 2:从“用户说一句话”到“真实系统发生变化”,中间至少要经过上下文、规划、工具选择、审批与执行;完成后的结果再进入反馈和学习闭环。
7. Credential + Authorization + Approval:这是个人 Agent 真正的控制面
连接 App 之后,至少还要分三件事。
Credential
“怎么证明我能登录这个服务?”
密码、OAuth Token、Session、Passkey、一次性支付 Token,都属于 Credential 问题。
Credential 应进入专门 Secret/Vault,而不是直接写入 Prompt 或 Memory。
Authorization
“这一次 Action 到底被允许吗?”
例如:
agent wants:
send_email(
  to="[email protected]",
  attachment="contract.pdf"
)
执行前应该重新检查:
- 谁在发;
- 发给谁;
- 附件是否允许外发;
- 这次 Agent 的 Scope;
- 用户是否允许自动发送;
- 是否跨组织/跨租户;
- 是否命中高风险策略。
XBSTACK 已有 AI Agent Tool Authorization / Policy Gate 专门讨论这层。
Approval
“即使策略允许,这个动作是否还必须让用户最后确认?”
购买、转账、发邮件、删除、公开发布、权限变更等不可逆或高影响动作,应该绑定具体 Action 和参数审批。
Meta Muse 和 OpenAI Dot 都已经把“什么时候自主执行,什么时候请求批准”放进产品控制面。这不是 UI 细节,而是未来 Personal Agent 能否真正被信任的基础。
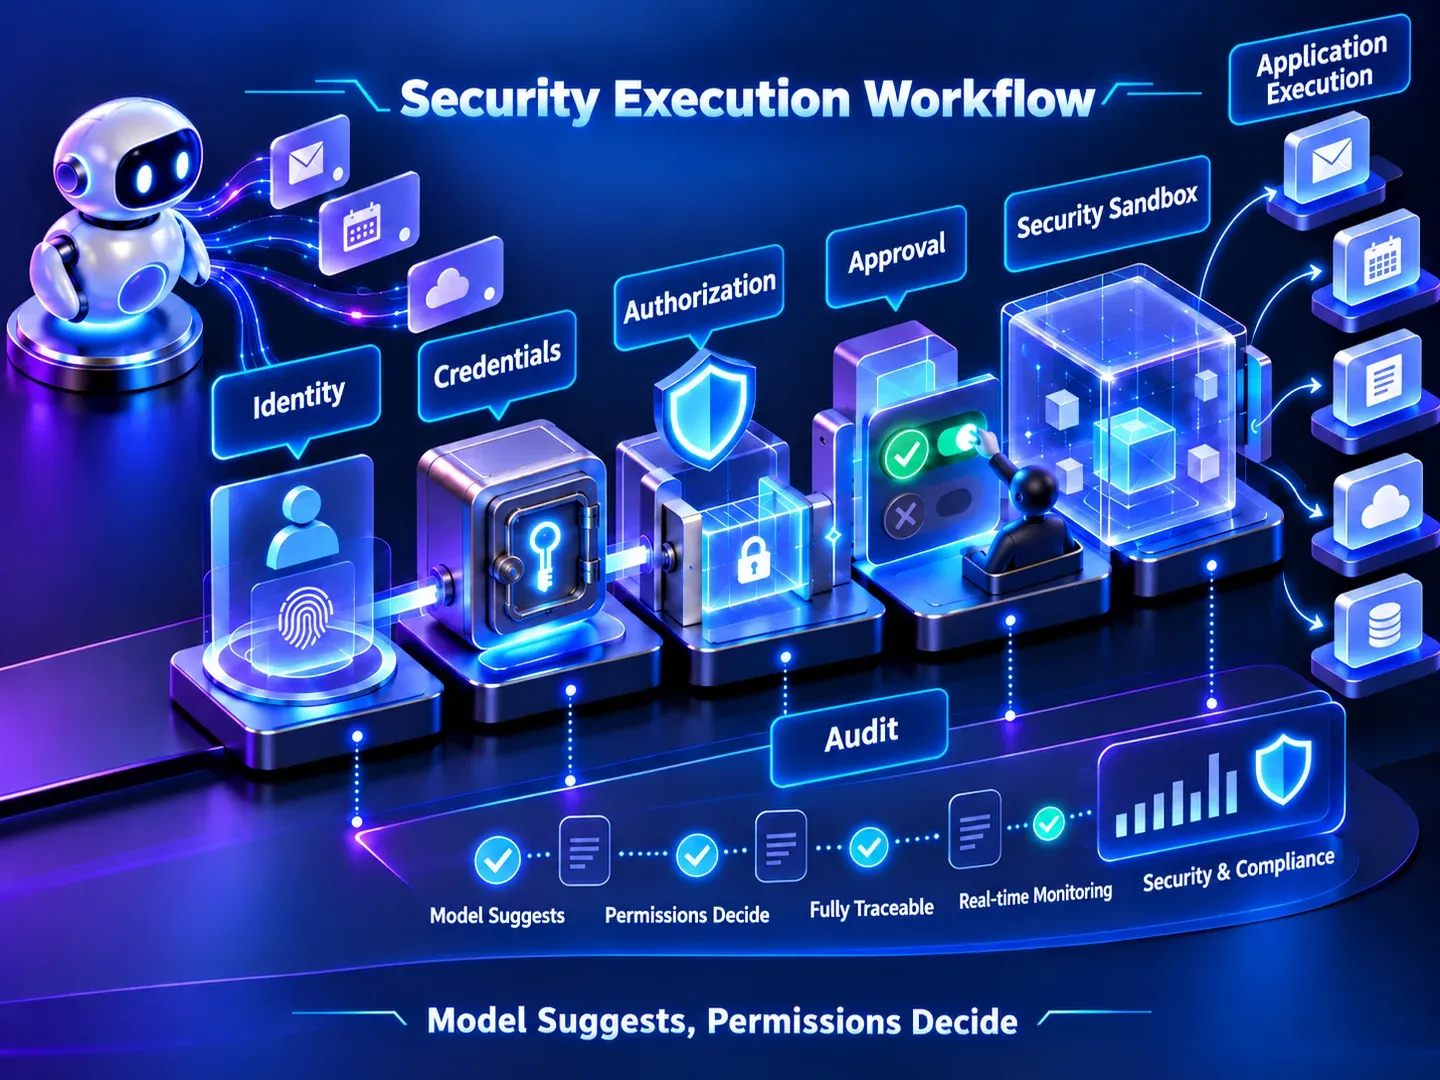
图 3:安全执行链路的关键不是让模型“更谨慎”,而是把 Identity、Credentials、Authorization、Approval、Sandbox 和 Audit 放在模型之外。
8. Local / Cloud Runtime:个人 AI 最终大概率不是二选一
“个人数据放本地,所以 Agent 必须 100% 本地”听起来最安全,但现实任务不一定适合全部在手机上跑。
反过来,全部放云端也会把个人知识、长期偏好、凭据和高频上下文暴露到更大的数据边界。
更实用的是 Hybrid:
| 层 | 更适合本地 | 更适合云端 |
|---|---|---|
| 用户私有资料索引 | ✓ | 仅必要同步 |
| 稳定偏好 / Personal Memory | ✓ 优先 | 加密/受控同步 |
| 轻量 Query Understanding | ✓ | 可选 |
| 大模型深推理 | 取决于设备 | ✓ |
| 长时间后台任务 | 受系统限制 | ✓ |
| 浏览器 / Computer Use | 有限 | ✓ |
| 跨设备持续工作 | 部分 | ✓ |
| 本地 App / 文件动作 | ✓ | 需远程桥接 |
| Credential | 本地 Keychain/Vault | 专用 Secret Store |
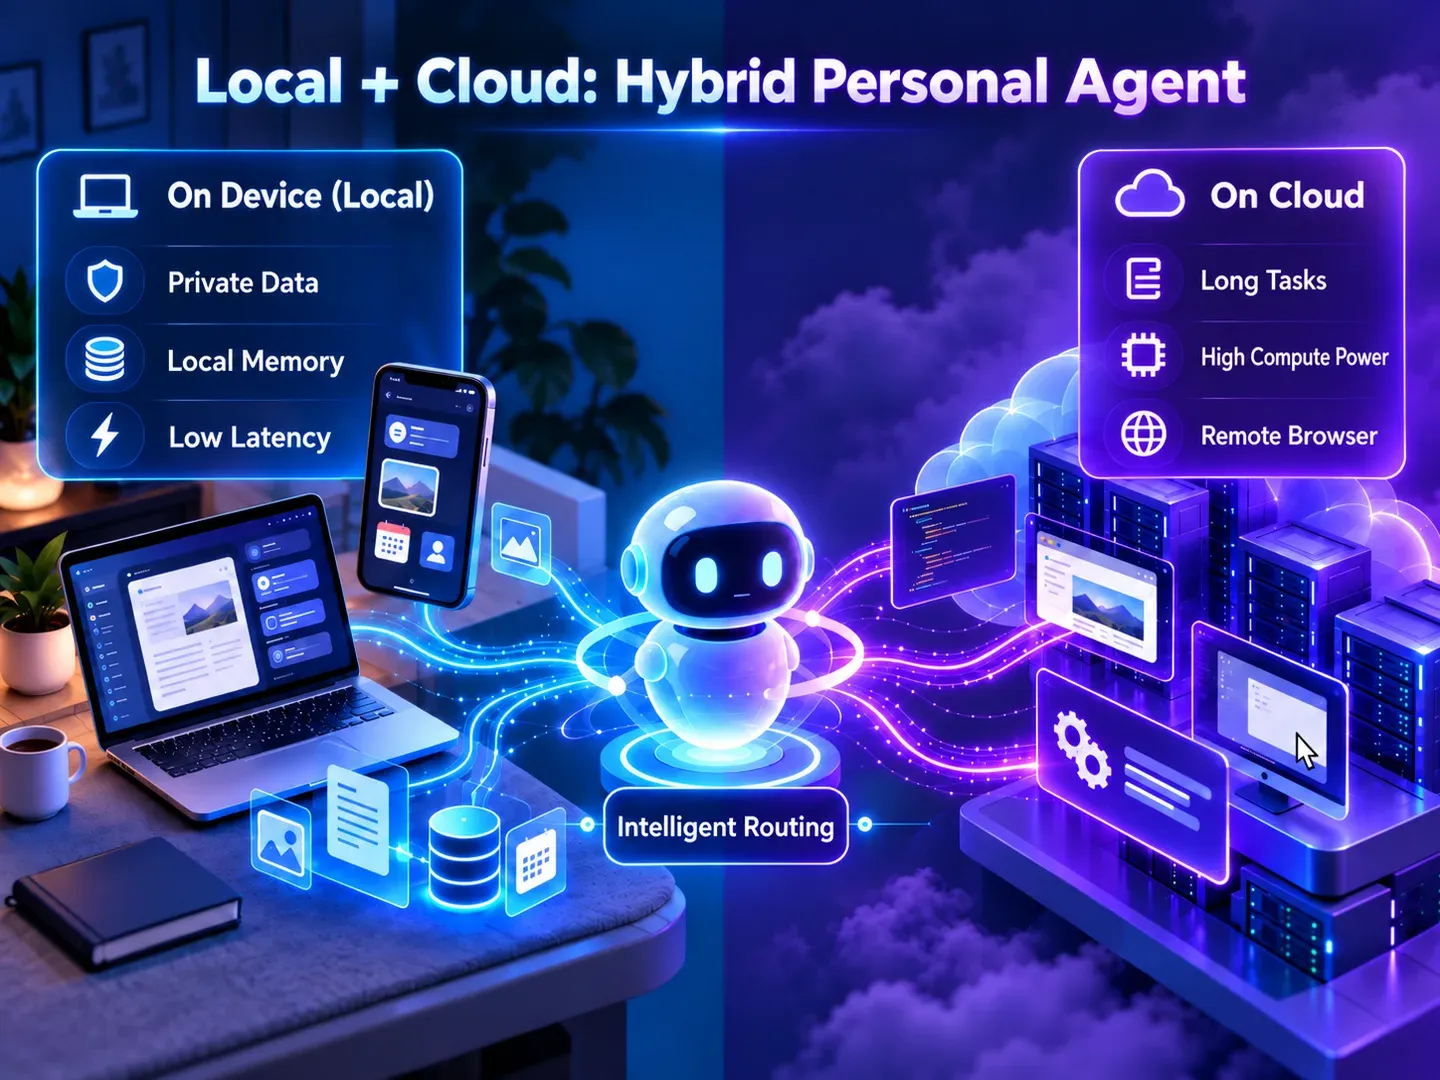
图 4:Hybrid 不是把所有数据同步到云端,而是按隐私、时延、算力、后台持续时间和系统能力,把不同任务路由到最合适的执行环境。
RecalAI 现在已经具备一个很典型的 Hybrid 基础:本地资料检索和本地模型可以独立工作,同时允许把生成层切换到自定义云端 API。
这并不等于 RecalAI 已经是完整的跨 App Personal Agent。相反,它说明一条更稳妥的演进路径:先把个人数据、检索和 Memory 边界做稳,再把高权限执行层独立加入,而不是一开始就让一个云端 Agent 拿走所有数据和所有操作权限。
9. Audit / Recovery:Agent 做过什么必须能还原
一旦 Agent 可以后台工作,普通“聊天记录”不够做审计。
至少要记录:
who
→ asked what
→ agent planned what
→ which evidence was used
→ which policy matched
→ which tool was called
→ with which arguments
→ whether approval was required
→ what actually changed
→ whether it succeeded
→ how to undo / recover
Meta Muse 提供完整 Audit Trail;OpenAI Dot 提供 Activity View、权限规则、自动审核和批准机制;Microsoft 则开始把 Agent Traffic 纳入 Zero Trust 和数据流控制。
这意味着 Observability 以后不会只是“看 Token 和 latency”,还要回答:这个 Agent 为什么做了这件事,它代表谁,它用了什么权限,影响了什么真实系统。
如果你在做高权限 Agent,可以继续看 AI Agent Security。
Personal AI Agent 最容易做错的五件事
把整个聊天历史当 Memory
结果是旧信息、临时信息和错误推断永久污染未来行为。
让模型自己判断自己有没有权限
“模型觉得这个动作合理”不是 Authorization。
所有工具都永久开放
今天批准访问邮箱,不代表以后任何任务都能读写全部邮箱。
为了“自动化”强行走 Browser 点击
如果正式 API / Intent / Connector 能完成任务,优先使用结构化接口。
本地或云端二选一
真正的系统会根据数据敏感度、延迟、能耗、持续运行时间和 Tool 所在位置动态路由。
如果今天从零设计一个 Personal AI Agent,我会这样拆
                ┌──────────────────────┐
                │ User / Device Identity│
                └──────────┬───────────┘
                           ↓
      ┌──────────────── Personal Context ────────────────┐
      │ Task State │ Long-term Memory │ Knowledge / RAG │
      └───────────────┬─────────────────────────────────┘
                      ↓
              Planner / Reasoner
                      ↓
              Action Proposal
                      ↓
          Policy / Authorization
                ↓           ↓
          Auto Allowed    Approval
                └──────┬──────┘
                       ↓
           Connector / MCP / Intent
             / Browser / Computer
                       ↓
             External Apps / OS
                       ↓
             Audit + Recovery
Runtime 再单独做 Local / Cloud Router:
Sensitive data / local files / low-latency
→ Local Runtime

Long-running / high-compute / remote browser
→ Cloud Runtime

Mixed task
→ Split execution + minimal necessary context transfer
这比“选一个最强模型,然后给它所有工具”复杂得多,但真正决定 Personal Agent 是否可用的,恰恰是这些模型之外的层。
未来 6—24 个月,真正值得提前建设的不是“万能 Agent”,而是这四个基础设施
下面是基于当前多厂商产品方向的 XBSTACK 工程判断,不是厂商承诺。
Personal Memory Infrastructure
如何写入、更新、冲突、过期、删除和同步长期个人 Memory,会成为独立基础设施。
Agent Identity & Delegation
Agent 代表谁、能拿到什么权限、委托多久、如何撤销,会从 App 配置变成身份系统问题。
Action / Approval Control Plane
真正的个人 Agent 会连接越来越多 App。风险不会因为模型更聪明而消失,反而需要更明确的 Policy、Approval、Audit。
Local-Cloud Personal AI Runtime
手机、PC、本地 NAS、云端 Computer 和 SaaS Connector 会共同组成执行环境。谁保存数据、谁做推理、谁真正执行动作,将成为架构核心。
这四个方向都比任何一个短期 SDK Bug 更值得建立长期搜索资产。
上线前检查清单
如果你正在做自己的 Personal AI Agent,至少确认:
- Identity 与普通 Session ID 分开;
- Task State、Long-term Memory、Knowledge/RAG 分开;
- Memory 有来源、作用域、生命周期、删除和冲突规则;
- Credential 不进入普通 Prompt / Log / Memory;
- Tool 可见与 Tool 可执行分开;
- 高风险 Action 在执行前重新做 Authorization;
- Approval 绑定具体参数,不是笼统“允许这个 Agent”;
- Local / Cloud 有明确的数据转移边界;
- Browser / Computer Use 处于 Sandbox 与网络策略之内;
- 所有真实副作用可审计;
- 长时间任务支持暂停、恢复、重试与幂等;
- 用户可以撤销权限、删除 Memory、停止 Agent;
- App/Plugin/Connector 变化后有回归验证。
结论
OpenAI Dot、Meta Muse、Apple Siri AI 的意义,不是“又多了三个 AI 助手”。
它们共同说明,个人 AI 正从 Conversation Product 变成 Personal Execution System。
真正的 Personal AI Agent 会长期存在,理解个人上下文,拥有自己的任务状态和 Memory,连接 App 和工具,在本地与云端之间分配计算,并在权限、批准和审计边界内持续行动。
模型当然仍然重要,但决定这个系统能否真正替用户工作的,越来越不是“回答一次问题有多聪明”,而是:
它记住什么、忘掉什么;能访问什么、能执行什么;什么时候可以自主推进,什么时候必须把决定交还给用户。
如果你先从架构层解决这些问题,再去选择模型、插件和 Computer Use,Personal AI Agent 才可能从 Demo 走向真正长期使用的产品。
从单个 Agent 问题继续进入完整生产体系
AI Agent 专题统一组织架构、记忆、工具调用、评测、安全、部署和多智能体协作,让每篇文章都回到明确的主题主页面。
继续阅读
返回专题 →AI 工程周报
只发真正改变工程判断的变化、故障、实验和新资产。
参与讨论
问题、验证与勘误
登录后可发表评论。所有新评论先进入审核;审核期间仅评论者本人和管理员可见,通过后才公开。