LiteRT Tensor API:C++ 编写端侧模型图,XNNPACK、GPU 与 NPU 怎么选?
Google LiteRT Tensor API 是什么?结合官方 C++ Quick Start,解释原生计算图、XNNPACK、.tflite、ML Drift、ModelChain、设备兼容性和性能验证方法;不冒充本站实测。
本文目录
证据声明(2026-10-20): 本文根据 Google 官方发布说明、Tensor API 的公开源码文档和示例撰写。涉及的编译命令与代码接口为官方文档核查,不代表 XBSTACK 已在 Mac、iPhone、Android 或特定 NPU 运行该样例。本文没有本站性能、内存或电量实测;Google 的演示数据也不会冒充本站跑分。
直接回答:LiteRT Tensor API 是 LiteRT 中用于用 C++ 编写和组织 Tensor 计算图的接口,而不是另一个大模型。 它让开发者在源代码中定义算子和连接关系,再为不同执行路线选择后端:直接用 XNNPACK 在 CPU 上运行,把图输出为 .tflite 交给 LiteRT CompiledModel,或通过 ML Drift 走支持的 GPU 路径。选择何种后端与能否真实运行,必须由目标设备的算子覆盖、驱动、缓冲兼容性和测试结果决定。
1. Google 为什么需要新的 Tensor API?
如果已经有一个 PyTorch 模型,通常不需要先把它“手写一遍 C++”。模型转换、量化、优化后由运行时执行,仍是 Google 推荐的常规生产路线。Google 2026-10-19 官方说明
Tensor API 针对的是另一类工程问题:
- 转换器表达不了某个计算组合。 比如实验性 attention、特定图变换、图内采样或定制预处理。开发者希望明确写出操作,而不是等待训练框架和转换工具补齐。
- 推理外面还有大量工作。 摄像头帧缩放、归一化、模型调用、掩码处理、后处理与展示,若每一阶段都要把数据拷回 CPU,即使模型本身速度很快,也可能拖慢整条路径。
- 需要可控的实验边界。 某个算子、Tensor 形状、缓存或执行图更改,应该可以对照数值参考和明确的设备配置做验证。
这不是“Tensor API 自动让所有设备性能提升”的承诺。Google 的目标是把原来要为多个硬件后端重写的图逻辑整理到统一的 Tensor 表达,再分别编译、执行与验证。
2. 理清四种容易混淆的接口
| 技术 | 主职责 | 适合谁 | 不应误解为 |
|---|---|---|---|
| LiteRT Tensor API | C++ Tensor 算子、计算图、运行及流水线组织 | 自定义图与预后处理、跨后端验证 | 训练系统或通用 NPU 驱动 |
| LiteRT CompiledModel | 加载、准备并运行已有 LiteRT 模型 | 已有 .tflite / 已完成模型转换的应用 | C++ 图定义语言 |
| LiteRT-LM | 语言模型和多模态生成推理相关能力 | 本地聊天、文本流、KV Cache 等 | 与 Tensor API 一一替代 |
| ML Drift | Google 的部分 GPU 执行与算子实现路径 | 特定 GPU 工作负载、WebGPU/OpenCL/Metal 等平台 | 所有设备、所有算子的无条件 GPU 保证 |
MLX 与 llama.cpp 则是不同生态的计算或推理方案。不能因为 Tensor API 和 MLX 都会用 C++/原生计算,就推导出通用性能排序;比较必须固定模型、精度、算子、设备和测量口径。
3. 计算图到底怎么形成?
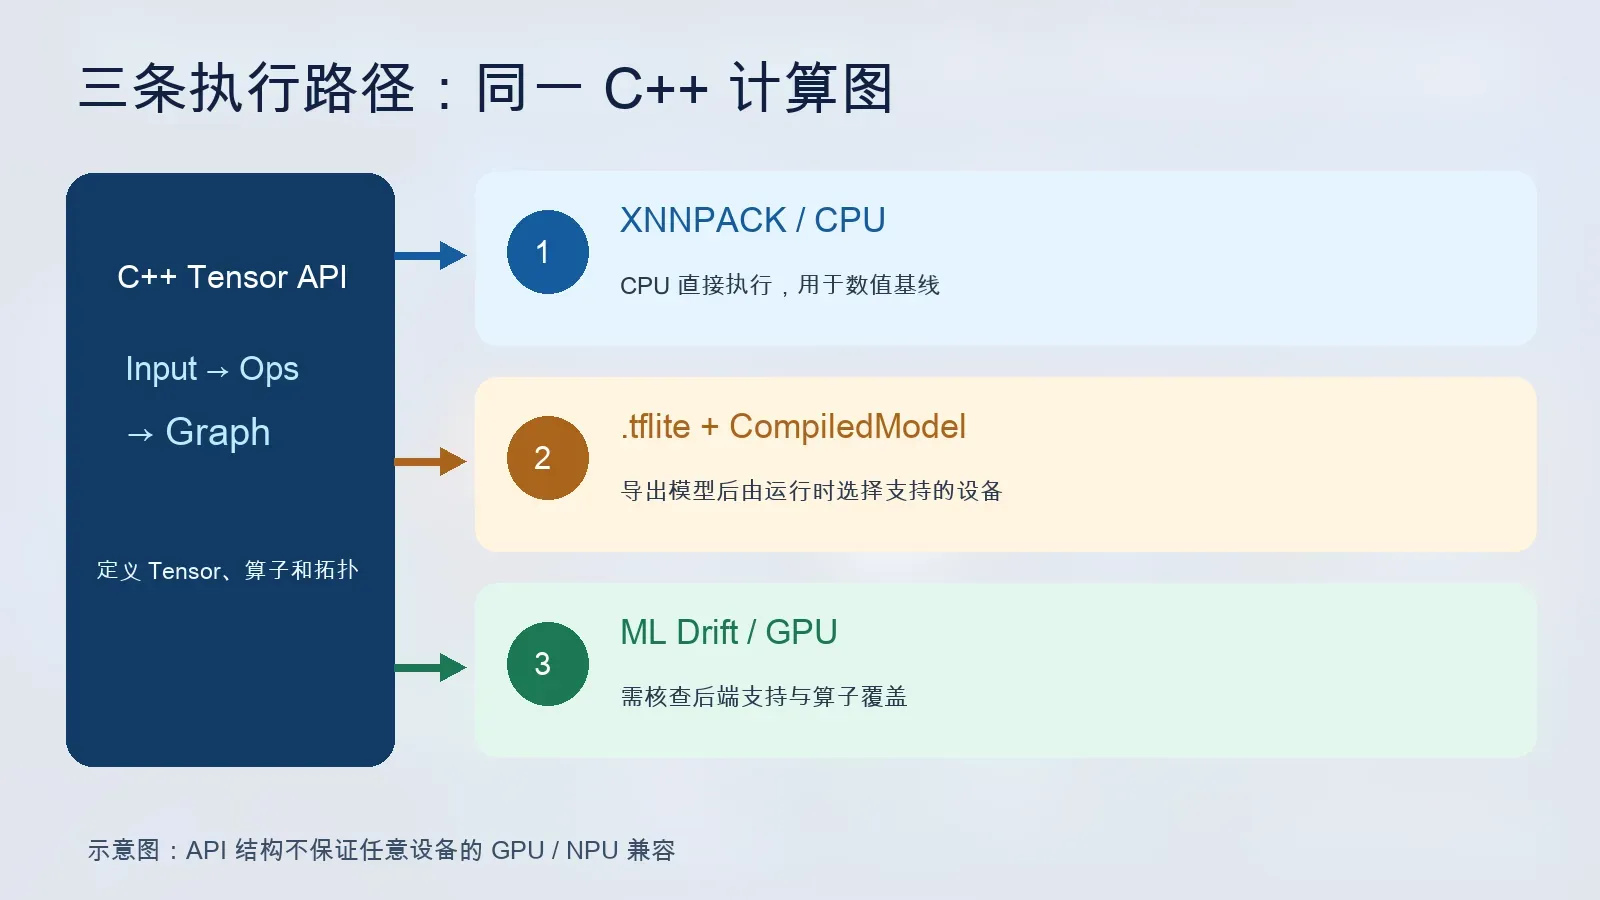
三条执行路线的编辑示意图,不代表任意设备都支持全部后端。
Tensor API 中的 Tensor 不只是内存数组。根据官方源码文档,开发者创建 Tensor、调用 Add、MatMul、Softmax 或其他算子时,通常是在记录延迟构建的计算图,直到选择 runner / compiler 后才执行或导出。
模型通常沿以下路径之一运行:
| 路径 | 编写方式 | 输出与执行 | 推荐起点 |
|---|---|---|---|
| XNNPACK / CPU | Tensor<XnnpackMixinTag> | 由 XNNPACK runner 直接执行;可以不生成模型文件 | 先验证算子与数值结果 |
| LiteRT flatbuffer | Tensor<TfLiteMixinTag> | 导出 .tflite;交给 CompiledModel 及其加速器 | 需要 App 分发和多设备执行 |
| ML Drift GPU | Tensor<MlDriftMixinTag> | 针对已支持的 GPU 后端构图、编译、执行 | 目标是特定 GPU 流水线 |
这些是支持的开发路线,而不是任一图在任一设备都必然执行成功。尤其 NPU,要区分“能生成 TFLite 图”“设备有 NPU”“供应商加速器和算子可被识别”“实际在 NPU 上运行”四件事。官方 Tensor API README
4. 一个最小 C++ 验证例子:向量相加
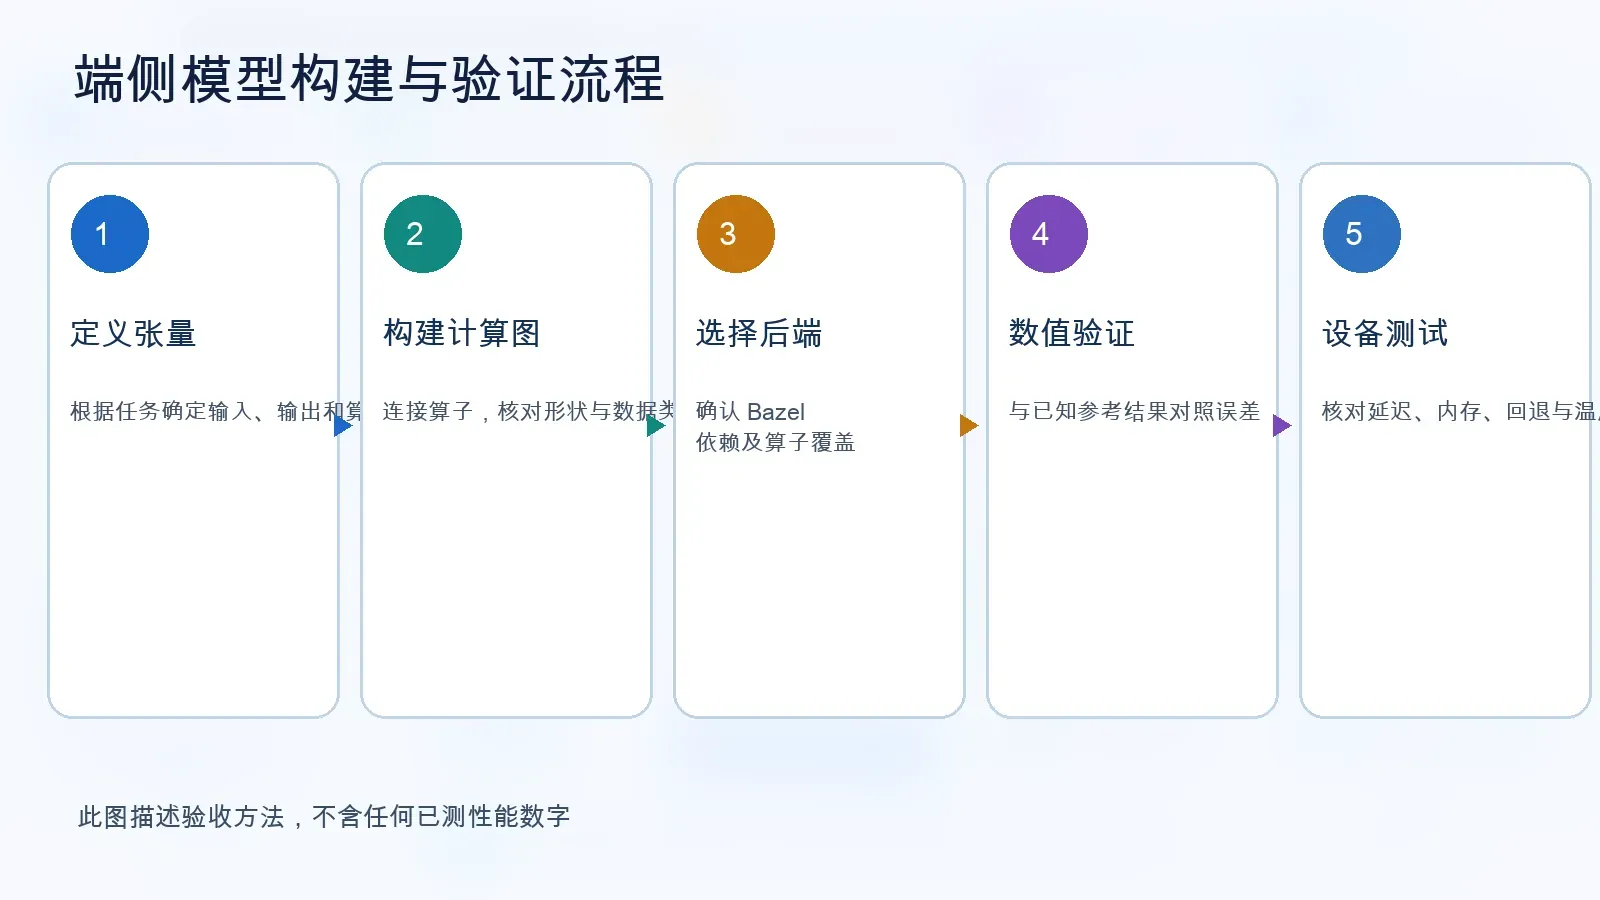
流程图表示应执行的工程步骤,并非 XBSTACK 已完成这些设备测试的凭据。
不要一上来就在手机部署 SAM 2 或大语言模型。首先可以用官方 Quick Start 中的三元素向量加法检查计算图与 CPU runner。
逻辑目标:
Input A = [1, 2, 3]
Input B = [4, 5, 6]
C = Add(A, B)
Expected result = [5, 7, 9]
对应的 Tensor API 核心调用形式如下(为说明目的简化,不是可直接单文件编译的完整程序):
using namespace litert::tensor;
using CpuTensor = Tensor<XnnpackMixinTag>;

CpuTensor a({.name = "a", .type = Type::kFP32,
             .shape = {3}, .buffer = std::vector<float>{1, 2, 3}});
CpuTensor b({.name = "b", .type = Type::kFP32,
             .shape = {3}, .buffer = std::vector<float>{4, 5, 6}});
auto sum = Add(a, b);
// 创建 XnnpackRunner、Run 并读取输出,详见官方 Quick Start。
完整的头文件、XnnpackRunner::Create、ReadOutputAs<float>、错误检查宏,以及 cc_binary 依赖,使用 官方 Tensor API README 的 Quick Start 所列版本,不在这里复制一份可能随 API 更改而过期的大段源码。
构建环境与命令
在已安装 Bazel/Bazelisk、已具备编译器和 LiteRT 仓库依赖的环境中:
git clone https://github.com/google-ai-edge/LiteRT.git
cd LiteRT

# 记录 SHA 以便他人复现;不应只记录 main
git rev-parse HEAD

# 官方 Tensor API 的构建与基础测试入口
bazel build //tensor/...
bazel test //tensor:all //tensor/backends/tflite:all
若另建 add_xnnpack.cc,按照官方 README 定义 cc_binary 与 //tensor、//tensor:arithmetic、//tensor/backends/xnnpack:arithmetic、//tensor/runners/xnnpack:runner 等依赖,然后构建并运行实际创建的 Bazel target。不要把上述 bazel build //tensor/... 误当成自动生成了这个自建二进制。
本轮 XBSTACK Mac 工作区只查到了系统 clang++;没有确认可用的 Bazel/Bazelisk 或完整 LiteRT 编译依赖。因此本文没有完成编译验证,[5,7,9] 是预期数值结果,不是本站终端截图或实测日志。
5. 三条后端路线该怎么选?
XNNPACK:先建立数值正确性基线
在自定义算子图仍不断变化时,直接 CPU 运行通常是最先排除问题的方式。它更容易区分形状与算子错误,不需要先解决每个手机芯片的 NPU 插件加载问题。CPU 跑通并不代表 GPU/NPU 兼容,但它是更清晰的基准点。
.tflite + CompiledModel:进入 App 的部署路线
需要在 Android、iOS 或其他终端分发模型时,可以将 Tensor API 编写的图转成普通 .tflite,再使用对应平台的 LiteRT 编译与执行能力。它不要求最终应用一定部署 Tensor API 的整个 C++ 构图层。
部署前要检查算子、输入输出形状、量化、加速器共享库及版本。尤其 Android NPU,一定要在设备侧核对编译日志、实际生效后端与回退情况;“配置了 NPU”不等于“实际在 NPU 跑”。
ML Drift:GPU 图与设备内流水线
Google 的 ML Drift 路线面向支持的 OpenCL / WebGPU 等 GPU 后端,可以减少图经过 .tflite 的一些环节,但这不代表所有平台使用同一种编译器和驱动,也不代表未支持的算子能自动执行。项目必须进行 backend-specific 的 correctness check。
6. zero-copy 为什么比模型算子微调还重要?
以端侧视频分割为例,一个完整任务可能包含:
- 摄像头帧格式处理与尺寸归一化;
- 编码器推理;
- 目标提示、解码和时间状态更新;
- 输出掩码重采样与合成;
- 返回显示或视频流水线。
如果每个步骤都将 Tensor 从 GPU 复制回主机内存,再送回 GPU,带宽和同步损耗就可能抵消模型内部优化收益。Tensor API 的 ModelChain、LitertBuffer 能用于组织多个 stage 和中间缓冲,使支持的处理链减少不必要的 CPU 往返。能否真正达到 zero-copy 仍取决于缓冲类型和后端互操作是否兼容。
官方案例不是本站实测。 Google 的 SAM 2 浏览器和移动端演示提供了具体的 WebGPU、Metal 和 OpenCL 路线,并报告过特定模型、输入尺寸及硬件条件下的帧率与对比结果。其测试值不应推广为“Tensor API 全面快于 MLX”或“所有 Android 手机达到 30 fps”。详见 Google 官方实验说明。
7. 生产落地前的验证清单
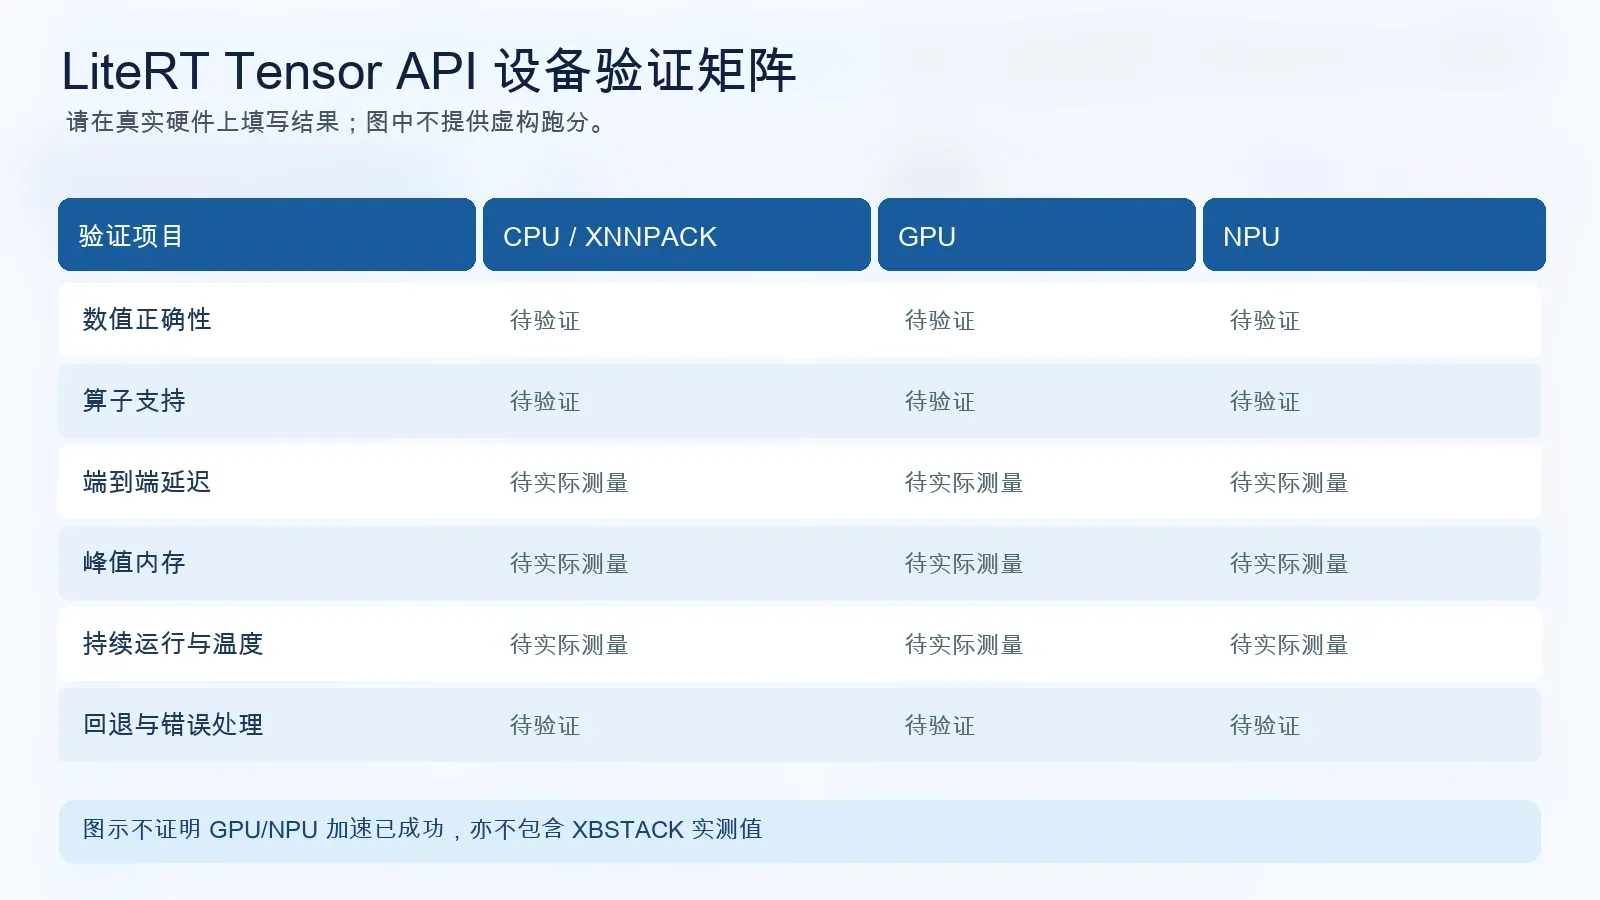
待测矩阵,仅用于制定验证计划;没有任何模拟数字被当成实测结果。
建议逐条记录,并且把错误与回退情况一起保存:
| 检查项 | 必须记录的证据 | 常见误判 |
|---|---|---|
| 环境与版本 | LiteRT commit SHA、Bazel、编译器、OS、SDK | 不固定 main,却给出可复现结论 |
| 数值正确性 | 测试输入、CPU 参考、误差容限与失败用例 | 只看输出形状一致 |
| 算子覆盖 | 图中的算子、后端支持及回退 | 有 NPU 型号就认为所有算子可用 |
| 端到端耗时 | 预处理、编译、预填充/推理、后处理、同步时间 | 仅报告核心模型时间 |
| 内存与热稳定性 | 初始化与峰值内存、连续运行、设备温度 | 只测一次短任务 |
| 设备差异 | iOS/Android 的具体机型、系统、驱动、运行时版本 | 以桌面 Mac 推断手机性能 |
| 失败恢复 | 不支持的算子、资源不足、动态尺寸等场景 | 只测“正常执行一次” |
对于投入生产的端侧 AI 产品,应该把真实设备的 P50/P95 延迟、能耗、内存、长时间运行的热降频与数值正确性放在同一个验收表中。
8. 和现有 LiteRT-LM、端侧 RAG 工作如何衔接?
如果项目已经在手机上使用 LiteRT-LM 来运行本地生成或 Embedding 模型,不必为了“用上 Tensor API”重写推理引擎。先明确瓶颈到底在加载、KV 缓存、CPU-GPU 数据搬运、搜索索引还是模型本身。只有确定需要定制图、预后处理链或未被转换器支持的操作时,再评估引入 Tensor API 的维护成本。
站内关联:
- EmbeddingGemma 2 本地检索实测:这是 XBSTACK 已实际测试的数据,可与本篇纯官方资料研究形成证据边界对照。
- Personal AI 端侧架构:看端与云如何分工。
- AI 工具实验室:后续如有经过真实设备验证的 Tensor API 样例,再在工具入口关联。
9. 什么时候应该暂时不用 Tensor API?
如果你只是想让一个已经兼容的分类、检测、Embedding 或生成模型在终端上运行,成熟转换链和 CompiledModel 往往更省时间。若当前模型能够稳定运行、整体时延满足要求,Tensor API 所带来的 C++ 源码、工具链、后端兼容矩阵与长期测试成本,不应为了追求新接口而引入。
真正值得评估它的条件是:在可复核的性能剖析中,已有转换或流水线路线无法满足需要,且你能够维护跨版本和跨设备的数值、性能回归。
常见问题
Tensor API 与 LiteRT CompiledModel 是同一个东西吗? 不是。前者重点是定义或生成图;后者重点是准备并执行模型。两者可以在一个工作流中连续使用。
是否必须先训练一个新模型? 不需要。Tensor API 可以组合现有权重和算子,但权重来源、许可、张量布局及数值一致性仍要由开发者核查。
是否不再需要 .tflite? 不一定。XNNPACK 直接路径可以没有中间模型文件;需要跨设备分发、LiteRT 编译与执行时,.tflite 仍是可选且重要的路线。
是不是天然跨 Android、iOS 和 Web? 这是 API 的设计方向,不是全部后端和算子的兼容性保证。目标平台必须逐项构建、运行并验证。
资料与核验边界
- Google 开发者博客:Native Model Authoring for Edge with LiteRT Tensor API(2026-10-19)
- Google AI Edge LiteRT Tensor API 源码文档:概念、Quick Start、Bazel、Backend
- LiteRT Getting Started:CompiledModel 与平台选择
- Google LiteRT Samples:公开模型和前后处理示例
编辑校验说明: 截至 2026-10-20,本篇的 API 描述与命令是“官方资料核对”,不是本站设备实测。后续取得可复现的设备测试日志时,将补充独立的配置与运行数据;没有数据的维度不会填估计值。
下一步:继续搭建 Agent 系统
完整专题路径 →沿着架构、工具、Memory、评测、安全或生产治理继续推进,不必重新从头找资料。
参与讨论
问题、验证与勘误
登录后可发表评论。所有新评论先进入审核;审核期间仅评论者本人和管理员可见,通过后才公开。