世界模型的真正分水岭:谁能证明一次“模拟成功”不是幻觉?
世界模型是什么,与普通视频生成或物理仿真有什么不同?从机器人模拟抓取的虚假成功入手,结合 Genie 4、NVIDIA Cosmos 3 与独立研究,说明如何核验行动结果,以及这项技术的商业价值边界。
Evidence 11 条资料来源
本文目录
世界模型靠谱吗?它可以预测可能发生的事,但模拟画面看起来成功,不等于真实行动一定成功。判断它是否靠谱,必须检查环境状态、动作反馈,以及独立环境里的任务结果。假设一台机械臂要从货架上抓起玻璃杯。它在生成的世界里完成了动作,杯子被拿起,关节运动自然,光影和接触细节甚至比传统物理引擎更逼真。现在把同一个控制序列交给真实机器人,杯子却从夹爪中滑落。问题不只是“模型的物理效果还差一点”,而是**作为训练环境的生成模型可能把一次本应失败的动作标注成成功,并把这个错误奖励给控制策略。**对于负责电影预演的人,模拟成功可以意味着镜头好看;对于负责工业机器人安全的人,成功必须意味着物体真正到了目标位置,碰撞、力矩与安全约束没有被违反。这两种成功不能共用一张宣传海报,更不能共用一套验收标准。
简单说,世界模型(World Model)是让 AI 根据已有观察、以及可能采取的动作,预测环境接下来可能怎样变化的模型或模型体系。它既可用于生成可交互的场景,也可能辅助机器人训练、测试与选择策略。与主要追求画面连贯的普通视频生成相比,用于决策的世界模型必须回答“采取这个动作会怎样”;但它不一定具有传统物理仿真器那样可直接核对的显式物理状态与约束。世界模型的技术拐点不是“生成的视频终于足够真实”,而是生成世界开始被放进机器决策回路之后,错误会以什么形式传递、由谁发现、又由谁买单。截至 2026 年 11 月,Google DeepMind 的 Genie 4 显示出实时交互世界的能力,NVIDIA Cosmos 3 则把传感器条件、模型适配和推理部署推进到工程工具链中。两者是这场变化的证据,却不是文章的主角。XBSTACK 更关注一个持续存在的工程问题:一个可以“想象未来”的系统,究竟要提供哪些证据,才能被真实世界的决策者信任?
**本文的独立判断是:世界模型的主要产业壁垒,正从生成能力转向“可验证的行动结果”;在高风险场景,掌握状态真值、反事实测试和闭环验收的基础设施,可能比拥有最漂亮生成画面的模型获得更持久的商业议价权。**这是一条可被否证的产业假设,不是目前市场份额或模型性能的事实。已有研究早已质疑视觉质量与物理仿真的对应关系,本文的原创工作是把技术失效链、最小工程验收、买方单位经济性及分阶段商业化信号放在同一张决策表里。
一、世界模型的危险,不是生成出错误画面,而是给出错误的行动反馈
在最简化的控制问题里,环境具有状态 s,执行动作 a 后转移到下一个状态,并产生可观测信息和任务反馈。传统显式仿真器通常保留一组可查询的状态变量与状态转移规则;神经世界模型可能从历史帧、动作与潜在表示中预测未来观测,也可能与显式物理引擎共同工作。用抽象关系描述,真实环境的转移是 sₜ₊₁∼P(sₜ₊₁|sₜ,aₜ),模型学习的是近似分布 P̂。**这只是问题定义,不是对 Genie 4 或 Cosmos 3 未披露模型结构的猜测。**模型可以拟合出很自然的像素运动,却不能因此保证杯子质量、夹爪接触力或轮胎附着系数都被正确建模。
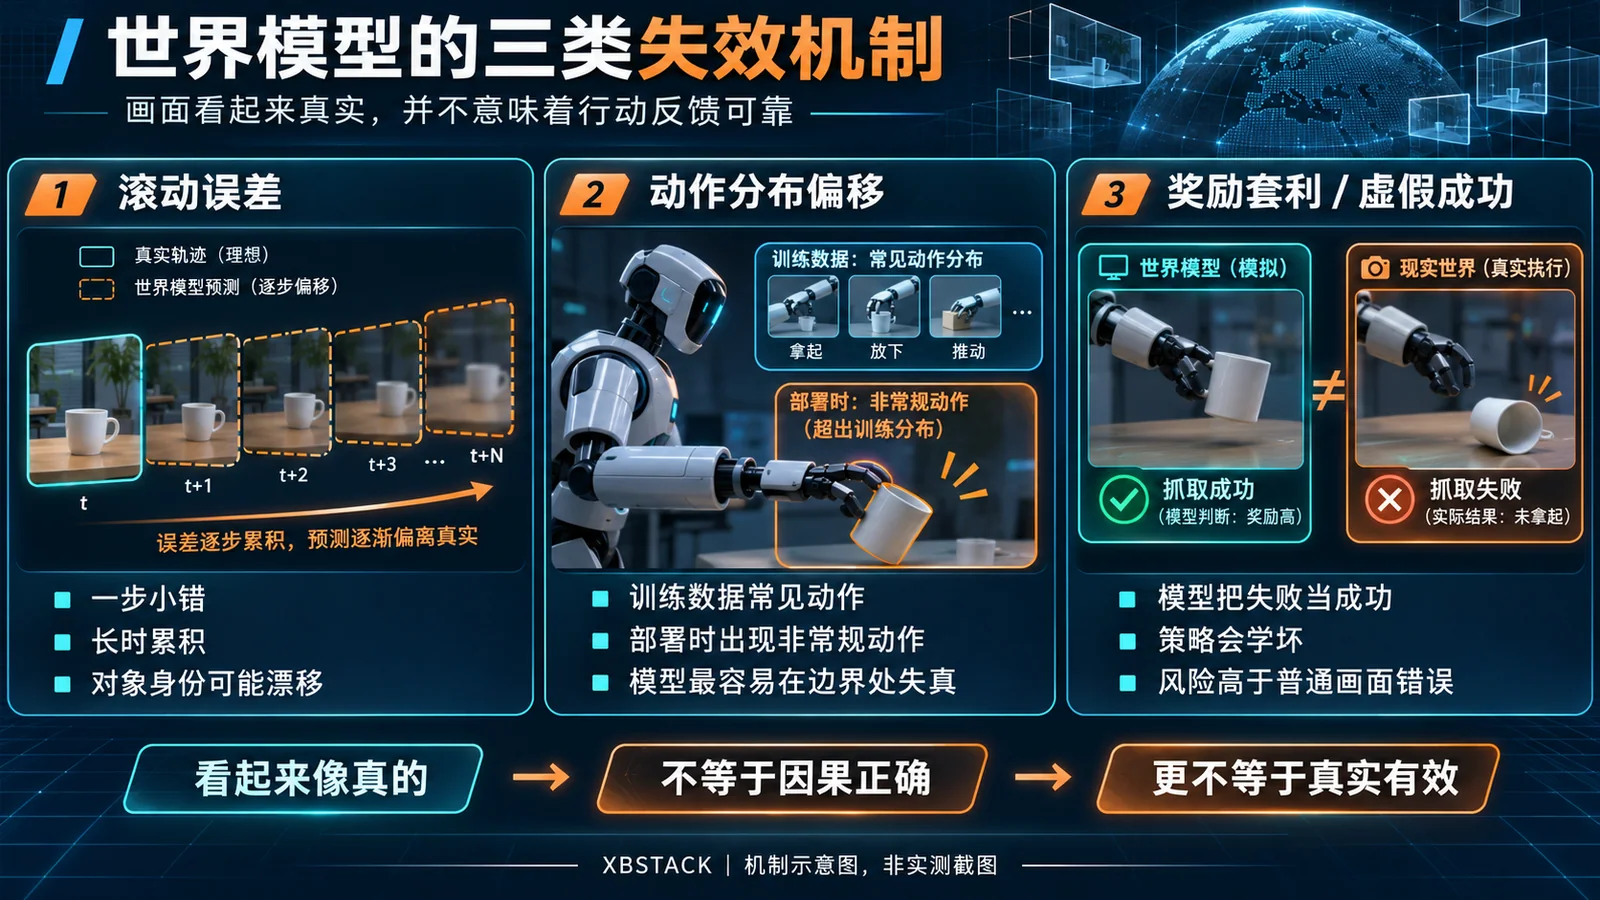
图 1|三种典型失效机制:滚动误差、分布偏移与虚假成功。概念示意,不是模型测试录像。
误差会沿着三个方向放大。第一是滚动误差:下一帧建立在模型自己上一帧的预测之上,小小的几何误差可能在长时交互中变成物体身份漂移、接触关系错误和不可信轨迹。第二是动作分布偏移:训练集来自人类常见行为,但部署中的策略会尝试非常规动作,恰恰进入模型最缺乏可靠数据的区域。第三是反馈套利:当策略以世界模型给出的奖励继续训练,它可能系统性选择“模型误判为成功”的动作。此时策略确实在它所处的模拟环境里进步了,却不一定在真实环境里进步,甚至可能更加危险。这不是简单增加画质、扩大上下文就必然解决的缺陷。
WorldGym 的研究提供了一个有用的正面证据:作者利用动作条件视频模型辅助机器人策略评估,在其研究设定中,模型评估结果与现实表现存在较强相关性,能够在一定程度上保留不同策略的相对排序;但作者也明确指出,真实物体交互的逼真模拟仍有困难。另一项 WorldGym 相关早期研究 提醒,模型可能对训练分布内与分布外动作产生不同方向的策略价值估计偏差。换句话说,世界模型不必在每一个像素上正确,仍可能对筛选候选策略有用;反过来,即使视频看起来完美,也可能严重误导策略选择。
2026 年 10 月的 AMD 技术研究《Learning to Fail》 给出了更尖锐的实验案例:在其特定 RoboTwin 调整瓶子任务中,未经相应失败样本微调的 BWM 会把 82.5% 的模拟器失败渲染为成功;加入策略自身失败轨迹训练后,这一比例降到 26%。这两个百分数是研究中某一模型、某一任务、某套评估流程的报告值,不能外推为 Genie 4、Cosmos 或所有世界模型的平均错误率。它的意义在于揭示一种购买者容易忽略的风险:如果模型“不会诚实地失败”,拿它训练的策略就可能学会利用模拟器漏洞。对于企业而言,这比单纯的视觉瑕疵更接近财务损失和安全责任。
更进一步,2026 年 10 月 24 日提交的 WorldFailBench 已把失败保真拆成失败原因、失败阶段与失败边界三个独立任务,并在 LIBERO、RoboTwin 及 G1 人形机器人任务上评估七类世界模型。一个模型可能正确预测“最终失败”,却把实际的滑落误判成选错目标,或把放置阶段失败预测成抓取阶段失败;这些偏差会误导工程师将改进资源投向错误模块。该论文并未证明本文提出的产业收益预测,但它为“三本验收账”增加了更强的失效分类证据:结果标签一致,也不意味着模型能解释失败机制。
二、与其比较 Genie 4 和 Cosmos 3 的画质,不如追问“状态真值由谁拥有”
Google 在 2026 年 10 月 27 日发布的 Genie 4 技术介绍 展示了自然语言调整场景、实时导航、原生音频,以及由 Gemini 3.8 Flash 在循环中观察场景、拆解目标和调整计划的能力。Google 同时承认:长期运行后物体持久性可能漂移,复杂物理、多智能体互动和空间准确性仍待改进,开放范围目前是受限研究预览,计划进一步扩展。由此能够确认的是:实时交互生成和规划协同正在进步;不能确认的是:所有开发者已获得相同复现条件,或者该系统满足工业级控制的确定性与安全要求。
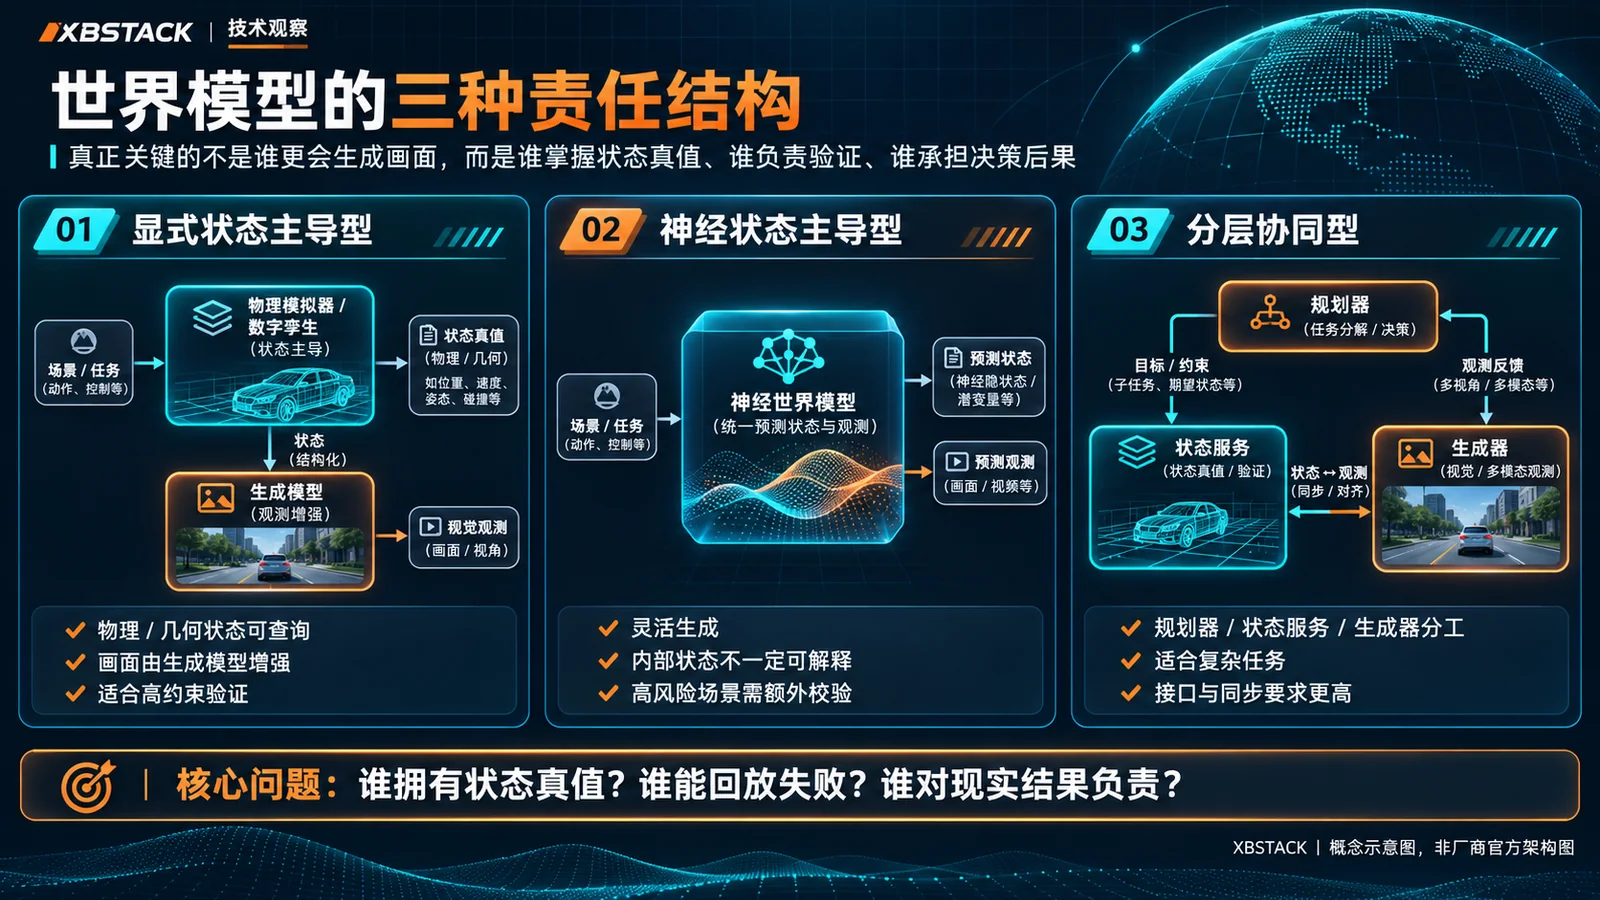
图 2|三种状态责任结构:明确谁管理状态,谁生成观测,谁承担验证责任。
NVIDIA 在 11 月 2 日的 Cosmos Framework 与 NIM 开发指南 中提供另一种切入方式:可供开发者使用的部分检查点、数据适配、训练与推理配方,以及传感器条件生成和容器部署。其中自动驾驶闭环示例中,策略或用户给出动作,AlpaSim 运行时更新环境状态,Cosmos3-Nano-Sim-Auto 在此基础上合成相机与 LiDAR 观测,再反馈给策略。这里一个值得认真研究的工程细节是:外部模拟器更新状态、生成模型负责感知画面。这比“生成模型一个人负责世界所有物理规律”更容易界定职责,但并不意味着合成观测不会误导感知和控制。
二者不宜做简单的一对一榜单。Genie 4 展示的是受限访问下的交互生成与规划体验;Cosmos 是涵盖多种模型、数据配方和部署方式的工具生态。开放权重增强了可检查性,但可检查并不等于已经验证可靠。NVIDIA 为特定 Cosmos3-Nano 生成配置列出的 GPU 显存要求为 BF16 约 58 GiB、FP8 约 44 GiB、FP8 结合 offloading 约 31 GiB;这是厂商按任务与精度给出的配置表,不是 XBSTACK 的 GPU 实测,也不适用于整个 Cosmos 生态。它说明独立开发者面对的不仅是模型能否下载,还有验证一次可靠任务所需的计算、数据和人工复核成本。
我认为应当按“谁掌握状态真值”把世界模型系统分成三种责任结构。第一种是显式状态主导型:物理引擎、游戏引擎或数字孪生系统拥有主要状态,生成模型增强观测;可解释性较强,仍须防止感知幻觉。第二种是神经状态主导型:模型预测动作后的状态和观测,潜在表示不一定对外开放;灵活,但难以直接查询接触、质量或守恒约束。第三种是分层协同型:规划器、语言/逻辑系统、生成器与显式状态服务分工,适合复杂任务,却引入接口时间同步、权限和责任归因的新问题。这是 XBSTACK 的系统设计分类,不是任何厂商官方宣布的统一行业标准。
| 采购或架构问题 | 必须要求的证据 | 答不上来时的判断 |
|---|---|---|
| 状态究竟由谁决定? | 对象 ID、位姿、接触、边界条件的可查询接口及版本 | 只能证明画面/交互,不宜声称可作物理真值 |
| 指定动作会产生什么后果? | 固定初态、仅改变动作的成对干预与误差记录 | 不宜用于事故反事实或高风险策略训练 |
| 模型会不会把失败当成功? | 真值标注、虚假成功率、置信区间和失败样本库 | 不得仅用模型内奖励驱动控制策略优化 |
| 换一套策略是否仍成立? | 未见策略、未见场景的闭环与现实/可信基线比较 | 不能声称可跨策略泛化 |
| 值不值得付费部署? | 完整 GPU、数据、模拟器、人工核验和失败重跑成本 | 不能用视频生成单价计算业务 ROI |
表中“不得”指 XBSTACK 建议的审慎采购与发布原则,不是声称已有统一法规或行业认证要求。重要的是,面向创意概念验证与面向安全敏感控制的证据门槛应当不同,不能把对前者有用的模型一律贬为“没有价值”,也不能用它的演示成果替后者背书。
三、XBSTACK 的独立工程框架:把“状态、干预、决策”变成三本可以结算的验证账
第一本是状态账,记录环境是否保持可核对的对象身份和状态。一个杯子被遮挡、移动、重新出现后,是否仍是同一个对象?控制动作是否造成可追溯的位姿变化,接触、碰撞、速度或距离是否满足任务所需的容差?这里建议同时记录对象级状态误差和长时滚动误差,而不是只有 FVD、感知相似度或人工画质偏好。对于无法开放内部物理状态的纯生成系统,可以用外部标注与可控场景测量部分现象,但必须承认“无法直接核验内部真实状态”的证据上限,不应自行补出不存在的物理真值。
第二本是干预账,将“听懂指令”与“遵守动作因果”分开。固定初始场景、历史观测、模型版本和可固定的随机性,只改一个刹车时刻、夹爪力度或目标位置,再对照参考环境的结果。重点不是两段画面是否都流畅,而是危险与安全、抓稳与滑落、撞击与避让是否按照物理与任务条件分开。建议报告干预响应方向正确率、严重约束违例率、无法判定比例和跨种子方差;对无法重复生成同一状态的服务,应把“重现条件不足”直接记入审计,而不是把一次成功演示视为因果检验完成。
第三本是决策账,验证世界模型是否真的值得嵌入 Agent、机器人或自动驾驶系统。设策略 A、B 的真实任务结果可独立测得,世界模型能否保持二者排序?用模型训练或筛选之后,是否优于不用模型、只使用普通模拟器或直接训练策略的基线?是否存在某些不合理动作因为模型的错误反馈反而得到更高奖励?此处最重要的指标不是视觉分数,而是策略排序一致性、决策遗憾(decision regret)、虚假成功率、真实任务提升和每次可靠验收的成本。对模型偏好的动作分布,还应保留分布外压力测试,防止“在熟悉动作中表现优异”掩盖边界失败。
这套三本账不是在宣称 XBSTACK 首创了反事实评估。2026 年的 From Generation to Simulation 已按传统模拟器能力梳理 200 篇代表性工作:在其中 163 篇实现类论文里,只有 6 篇提供运行时查询实体状态或物理参数的接口。这个统计来自研究者定义的文献样本,不等于整个世界模型行业只有六个系统可以查询状态。How Should World Models Be Evaluated? 也已提出从视觉合理性到决策有用性的 L0—L7 证据阶梯;WMEval 则用 Unity 参考模拟和匹配动作序列检查感知与物理因果差异。XBSTACK 的原创贡献,是将这些已经存在的学术问题,转换成企业可以拿来判定“上线、试点、拒绝或继续补证据”的三本验收账,并补上商业成本和责任边界。
一个真实的采购决策必须允许“证据不够,暂缓上线”这个结果。若状态不可查询、失败误报不能测量,就先把模型定位在低风险预演或候选数据生成;若动作条件一致性和策略排序能通过有限任务集验证,可考虑影子评估(shadow evaluation),但暂不让结果主导现实安全动作;只有在外部真值、真实闭环测试和成本审计都达到具体场景事先约定的门槛时,才考虑进入策略优化或高风险部署。门槛数值必须由任务、监管和风险承受能力决定,不能凭文章虚构一个全行业通用的 95% 合格线。
四、从机制到测试:如何防止世界模型“奖励错误”,而不是只检测它“画错了”
设定一个可复核的仓库抓取试验:同一货架布局、物体初始位姿和夹爪控制接口,将任务分成正常抓取、部分遮挡、物体被移动、不同摩擦系数和碰撞约束五类。对每类场景固定参考轨迹,再选择几组候选策略,让其先在可信的显式环境与世界模型环境中运行。收集状态、图像、动作、外部裁判判定、模型内部/代理奖励以及碰撞记录,明确把“漂亮地演出成功”和“物体真正抵达目标”分开。这是拟议研究方案,不是 XBSTACK 已经执行的试验;当前未运行 Cosmos 3,也没有对 Genie 4 获得公开可复现的统一调用条件。
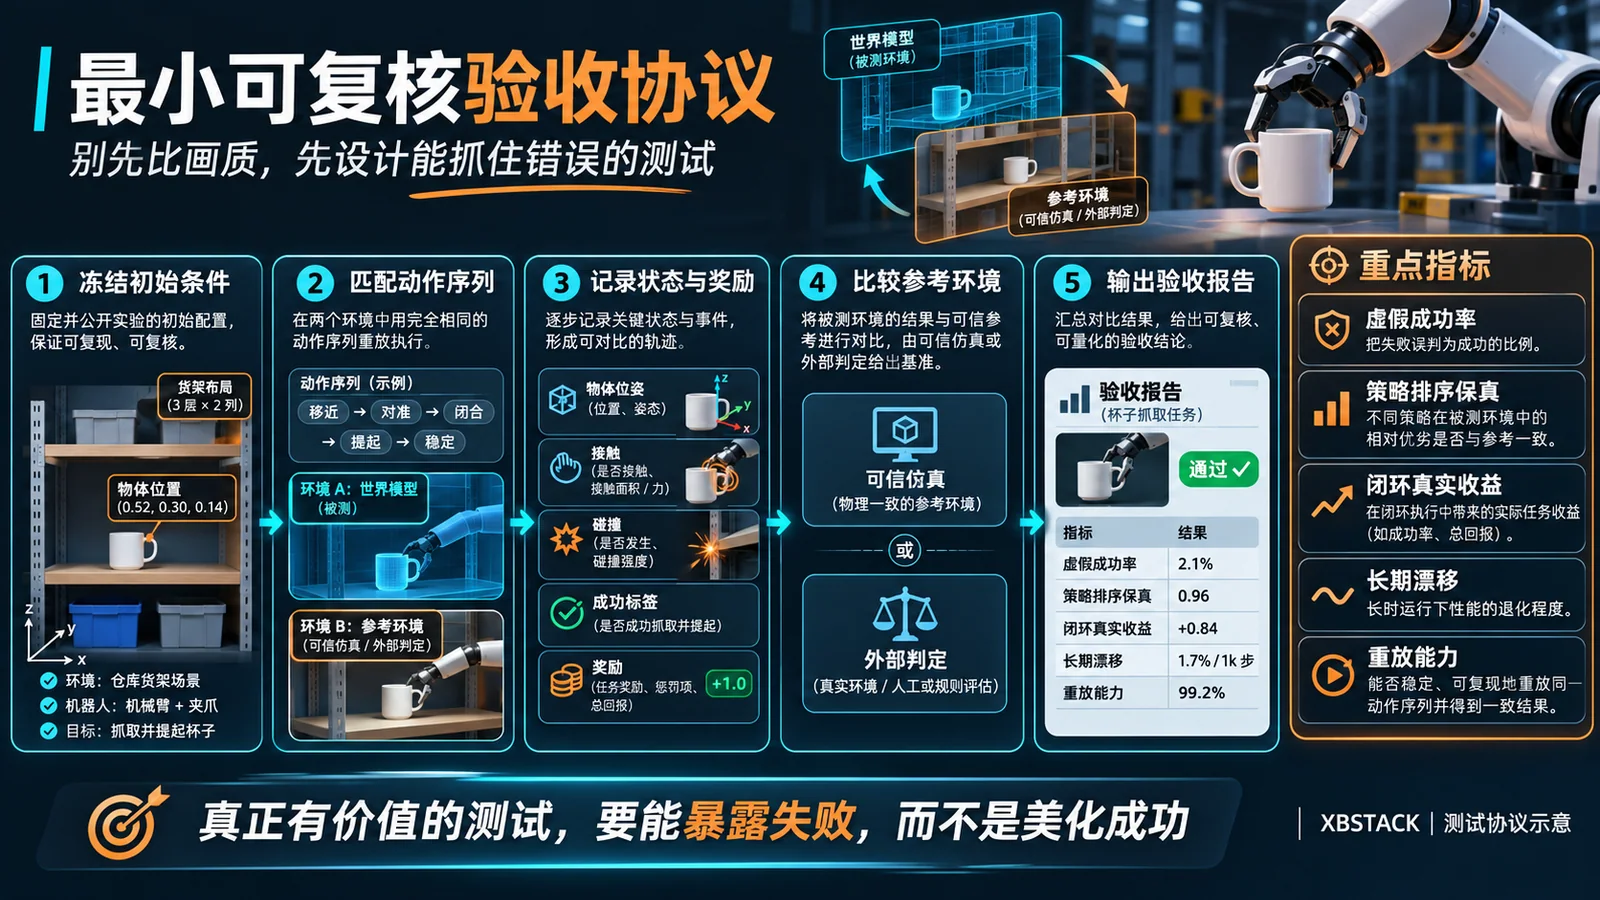
图 3|最小可复核验收流程。图中数值和场景均为示意,不代表 XBSTACK 实测。
验收报告至少应区分三个容易混淆的量。第一,虚假成功率:在参考环境判定失败的样本中,被世界模型及其裁判判成成功的比例;分母必须明确,不与总体成功率混淆。第二,策略排序保真:模型能否在相同任务集里保留 A 优于 B 的关系;应附样本数量、区间和不同环境切片,而不是只报相关系数。第三,闭环增益:模型辅助选择或训练的策略,在原模型之外的独立环境乃至实体设备上是否仍优于基线。只有第三项能够较强地支撑“世界模型提高了真实决策”的说法,但它也是最昂贵的一项。
误差累积还要求检查环境是否进入了不可逆的错误状态。例如生成式环境在第一百步后悄悄替换了物体身份,而奖励裁判继续把后续抓取认作同一任务成功。此时只对最后一帧做画质评价,问题可能完全消失在聚合指标里。正确做法是把对象身份、状态历史、控制时间戳、传感器同步、终止和重置语义作为可回放证据,重点保存失败的最小轨迹。对可复现性不够的托管服务,验收报告必须标注“无法独立重放”,不能由营销演示推断其稳定。
还有一个值得反过来追问的观点:世界模型一定要生成真实的视频吗?对于某些路径规划、机械臂控制或抽象决策,紧凑潜在状态、显式几何和成本函数可能比全分辨率连续视频更有效。若买方追求的是更准确的策略排序,而不是让人观看,那么没有华丽画面却能可靠预测碰撞和失败的模型,反而可能具有更高价值。因此我认为世界模型市场最终不会只有一个赢家:视觉交互平台与决策级预测基础设施可能分化成不同的产品类别。
五、产业化真正的单位不是“生成一秒视频”,而是“一个被独立验证且确实有用的任务”
模型厂商倾向于公布参数规模、帧率、推理速度或生成成本,这些指标有参考价值,但很难单独回答企业要不要买。对一家机器人公司而言,真正的问题是:用世界模型完成一批策略筛选,比直接去场地测试、使用现有模拟器或增加真实训练数据,是否节省了总成本,并且没有引入不可接受的错误?可以把单次有效评估成本写成一个采购决策式,而非厂商统一定价公式:
C_valid = (C_GPU + C_sim + C_data + C_integration + C_human + C_retest + C_risk) ÷ N_valid。
这里的 C_risk 代表因错误筛选、错误奖励和后续复核而承担的预期损失;N_valid 只统计达到任务验收定义、并通过独立核验的有效评估结果,不是总生成次数。公式是 XBSTACK 建议的成本分解工具,不是已经测得的全球统一商业模型。它故意把常被忽略的人工审查、集成和误判成本列出来,因为当生成失败却被当成成功时,再便宜的 GPU 推理也可能使真实任务更昂贵。
给出一个纯假设的敏感性例子:方案甲每生成一次场景的计算与服务成本为 1 单位,额外审核及集成分摊为 2 单位,每 100 次中只有 40 次通过独立验收,则每个有效场景的成本为 300÷40=7.5 单位;方案乙单次计算成本为 2 单位,其他费用为 1 单位,每 100 次有 80 次通过验收,单位有效成本为 300÷80=3.75 单位。两者的账面生成成本差一倍,采购结论却完全相反。这个算例不代表 Genie、Cosmos 或任何真实产品的价格、通过率;实际采购还必须比较评估结果能否改善真实策略,不能只把“可生成”计入 N_valid。
由此得出一个有分歧价值的判断:**未来世界模型的利润池不一定首先流向最会生成场景的公司,而可能流向掌握高质量状态接口、可回放验证集、行业数据契约及自动化错误裁判的企业。**但这也需要保留反例。如果生成模型大幅降低合成场景成本,并能直接输出满足安全约束的结构化状态,验证服务可能被模型平台内建,第三方验收层不一定有足够定价能力。真正的商业壁垒应当由跨模型独立评估、行业专有真值、客户工作流嵌入度和维护成本构成,不能仅靠“我们提供评估仪表盘”获得长期优势。
六、2027—2030:我更看好三条分化的产业路径,而不是一条“生成模型吞并仿真器”的单行道
**第一条路径是交互式创意与预演市场。**游戏原型、影视镜头设计、教育场景和产品概念演示,本质上购买的是更快的迭代和表达能力,画面、交互时延、编辑一致性与授权才是核心指标。Genie 4 这类技术在这里可能较早创造明确价值:用户并不要求每一处碰撞都满足严格物理方程,只要求场景足够可控和有用。这个市场需要防止的是把受限研究演示当成已经具备面向大众的稳定分发和收费机制。竞争可能来自模型平台、游戏引擎、设计软件与创意生产工具,而不是统一的“物理仿真市场”。
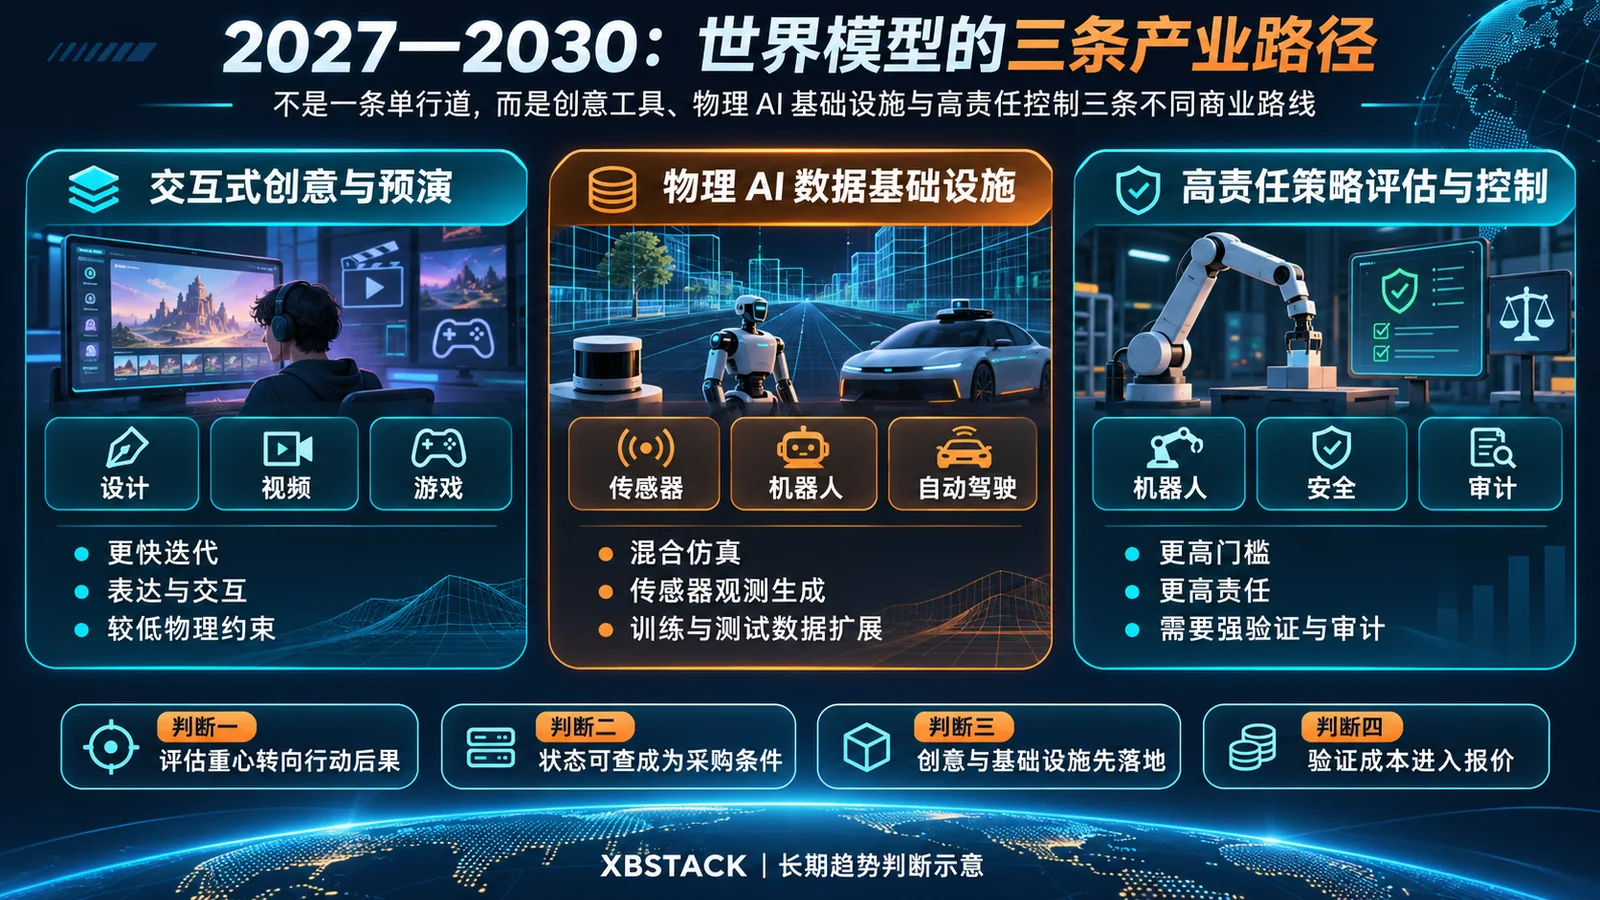
图 4|2027—2030 世界模型产业三条可能路径;仅为条件性行业判断。
第二条路径是物理 AI 的生成式感知与数据基础设施。自动驾驶、工业质检、仓库搬运和机器人训练都存在长尾场景稀缺的问题。更现实的早期采用方式,是让显式仿真器提供可信的几何、动作与约束,再让生成模型制造不同天气、材料、光照或传感器观测,从而扩展训练和测试的分布。NVIDIA Cosmos 的部分闭环示例已经体现这种分工。未来两年,我倾向于认为混合式仿真会比“完全由像素生成取代物理状态”更早进入高约束工程流程,因为它更容易提供审计接口、失败重放和责任边界。这是一个概率判断;如果纯神经环境在多组独立任务与实体测试中持续优于混合基线,它就应被推翻。
**第三条路径才是高责任的策略评价和控制。**当模型参与车辆规划、机械臂接触动作、医疗设备或其他涉及现实风险的系统,买方采购的不只是生成能力,而是可校准的不确定性、失败预测、分布外预警与系统级安全证据。该市场的单笔项目价值可能高,但集成周期、数据合规、仿真到现实的差距、硬件成本和法律责任也更高,商业化未必比创意市场更早。需要警惕把“机器人行业规模增长”与“某个世界模型厂商已经具备可持续高毛利”画等号;从技术可用性到客户续费之间还有一整条昂贵的工程链。
从产业利益分配看,云端算力供应商、生成模型提供者、专业数据供应商、仿真器、机器人本体公司和验证平台的收入结构并不相同。**生成模型的开源化会增加工具链替换可能,但验证数据和企业系统集成形成的迁移成本也可能增强锁定;两种趋势可以同时存在。**对独立开发者而言,真正可切入的也许不是训练更大的世界模型,而是开发与某类真实工作流紧密结合的状态记录、评估报告、回放工具和失败分类资产。前提是能够获取合法、可重复的数据与环境,而不是靠生成一张概念图宣称已做仿真。
七、四个可证伪的行业判断:观察指标比预测口号更重要
**判断一(2027 年中前后):世界模型的专业评估会从视觉分数转向“行动后果”报告,但不会完全放弃视觉指标。**观察标准是新论文、开发者工具和企业试验是否同步披露动作一致性、对象状态、虚假成功、长期漂移与闭环收益。若主流评估始终停留在视频主观偏好,或这些新增指标仍无法解释现实任务差异,这个判断就需要降级。不能用“论文数量增加”自动等同于“企业已经采购”。
**判断二(2027—2028 年):可查询的状态真值与第三方验证能力将成为高约束世界模型部署的重要采购条件。**可观察的证据是模型提供者是否公开结构化状态接口、场景重放、干预协议、未见策略测试和独立评估样本。若端到端神经模型在现实环境中直接交付稳定且可审计的成果,而不需要外部状态服务,那么我提出的“真值接口是重要壁垒”应当修正为“结果审计才是壁垒”,不能固守具体技术实现。
**判断三(2027—2029 年):创意交互与生成式感知基础设施比高安全级通用机器人世界,更可能率先出现较稳定的商业收入。**观察收入或采购合同的类型、付费客户续费、每项通过验收任务的成本以及是否减少真实采集与人工调试。若世界模型在真实机器人上实现跨场景、跨硬件、低成本的大规模闭环增益,第三条高责任市场可能更快发展,排序就会变化。
**判断四(2028—2030 年):行业叙事会由“模型能生成什么”进一步转向“系统能证明什么”,验证与责任成本逐步被纳入报价。**判断是否成立,不看营销用语,而看采购文档是否要求可回放日志、错误裁判、状态协议、不可接受风险的停止条件,以及按真实有效任务计价。反例是成熟平台把这一切低成本内建,导致独立验证服务几乎没有商业空间;在这种情况下,虽然验证能力仍重要,但“独立验证厂商长期受益”的预测就不成立。
上述期限是 XBSTACK 的编辑观察窗口,不是对技术必然完成日期的承诺。也没有证据支持由这些判断直接推导某只股票的未来涨幅、估值或盈利预测。行业趋势文章的价值不在于每次都预言正确,而在于现在就写清楚:未来出现哪些证据时,我们愿意修正判断。
八、对开发者的现实建议:先问“能否正确拒绝失败”,再问“能否生成更真实的世界”
如果你在做游戏、视频或交互式原型,应优先关注模型能否快速迭代、稳定保持意图以及实际创作成本。若你在做机器人训练或闭环控制,则应优先要求对外可检查的状态、失败案例、同一动作下的反事实对照,以及相对于现有模拟器和真实数据基线的提升。不宜直接把生成视频里的“操作成功”作为训练奖励,也不应把可下载的检查点误解为适合个人电脑运行的完整生产环境。对于只能访问受限演示的系统,应如实写明评估权限和复现限制,而不是在表格里给它编造“物理准确率”。
我的结论并不是“世界模型没有前途”或“神经模型永远不能取代物理引擎”。更准确的判断是:**生成能力已经足够有价值,接下来的高价值竞争将发生在验证、控制与责任的交界处。**那些能让人看见未来的模型会首先改变内容创作;那些能让系统可靠地检验未来、诚实地识别失败、并降低真实决策成本的系统,才可能改变工业工作流。Genie 4 和 Cosmos 3 分别提供了这两类能力继续发展的证据,但直到公开的、跨场景的独立测试足够扎实之前,任何“它们已成为现实世界模拟器”的结论都超出了可用证据。
这就是我认为 XBSTACK 应当长期追踪的技术线索。与其每次换一个新品标题重复发布新闻,不如持续维护世界模型的状态接口、动作干预、失败保真、闭环收益和单位有效任务成本这五项观察维度。模型名字会变化,验收逻辑不会轻易过时。相关的宏观产业背景可以参照站内 2027—2028 年 AI 趋势判断;涉及真实行动权限、状态与审计的独立问题,请见 Agent Security 技术专题。
可核对的一手资料与先行研究
- Google DeepMind(2026-10-27),Genie 4: A new generation of world simulation;另见 Genie 4 访问与局限。
- NVIDIA Developer(2026-11-02),Build World Models for Interactive Simulation with NVIDIA Cosmos。
- Wang et al.(2026-08),From Generation to Simulation: How Far Are World Models from Being True Simulators?。研究综述的 200 篇与实现类样本 163 篇、状态接口 6 篇的范围均来自该文。
- Yu et al.(2026-06),How Should World Models Be Evaluated? A Decision-Making-Centric Position。
- Hu et al.(2026-10),WMEval: Evaluating Interactive World Models Grounded on Physical Simulations。
- Quevedo et al.(ICLR 2026),WorldGym: World Model as An Environment for Policy Evaluation;早期版本 Evaluating Robot Policies in a World Model。
- AMD Developer(2026-10-20),Learning to Fail: Failure Fidelity and Training Stability for RL inside World Models。文中的 82.5% 与 26% 是该项研究中的特定任务数据,不是所有世界模型的共性结论。
- Jena et al.(2026-09),Do World Models Make Better Robots? A Survey of Evaluation Benchmarks for Predictive Embodied Intelligence。关于世界模型与策略基线之间评估空白的补充研究。
- Zhang et al.(2026-10-24),WorldFailBench: Do World Models Understand Policy Failures?。区分失败原因、失败阶段与失败边界的独立世界模型评估研究。
**作者证据声明:**本文为 XBSTACK 的原创工程与产业分析;“三本可结算验证账”“有效任务成本”的采购解释、三类责任结构与四个产业预测属于本站编辑框架,不能等同于已有论文的全部结论。本文未运行 Genie 4、Cosmos 3、未使用机器人真机执行试验,也没有采集独立厂商性能或采购收入数据。所有假设算例均已明确注明,并允许未来实验证据推翻本文判断。
下一步:继续搭建 Agent 系统
完整专题路径 →沿着架构、工具、Memory、评测、安全或生产治理继续推进,不必重新从头找资料。
参与讨论
问题、验证与勘误
登录后可发表评论。所有新评论先进入审核;审核期间仅评论者本人和管理员可见,通过后才公开。