Gemini 4 Argon 发布:功能、API 定价、迁移指南与真实项目评估方案
Google 于 2026 年 10 月 13 日正式发布 Gemini 4 Argon。本文核对百万 Token 共享上下文、仅文本输出、API 定价、迁移要求与 Coding Agent 测试方案,不冒充模型实测。
本文目录
Gemini 4 Argon 于 2026 年 10 月 13 日正式发布,API 模型 ID 是 gemini-4-argon。 Google 公开规格包括 1,048,576 Token 统一上下文、low/medium/high Thinking Level 与多模态输入。需要特别注意的是:它只支持文本输出,并不生成图片、音频或视频。2026 年 11 月 30 日之前,输入与输出每百万 Token 阶段性定价分别为 2 美元、10 美元;12 月 1 日起为 4 美元、20 美元。
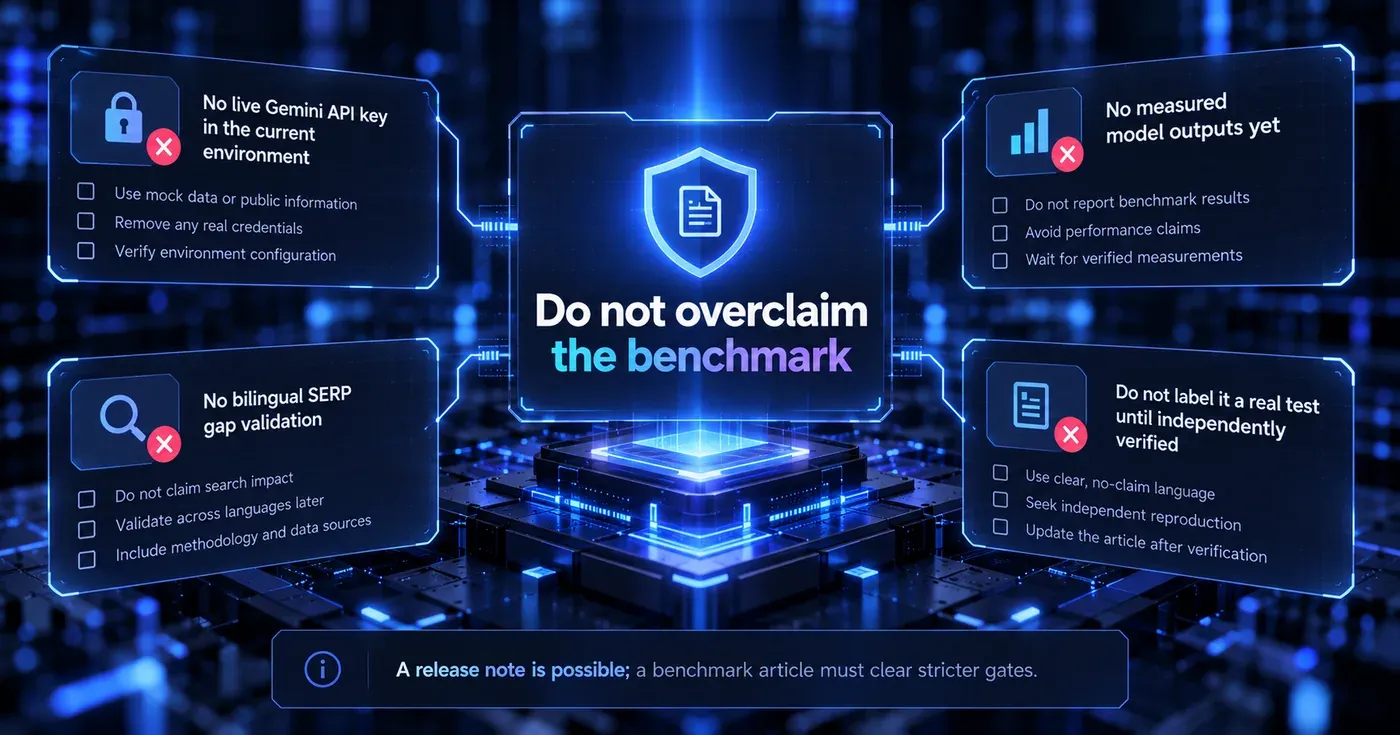
证据边界必须放在第一屏:本文不是 Gemini 4 Argon 实测。 目前只有官方规格核验、真实项目任务设计和单独的 LangGraph 故障恢复回归。尚未获得 Gemini 模型的真实响应、延迟、成本和任务准确率数据;封面终端属于概念插画而非真实运行截图。
官方规格应该怎么理解?
Google 的模型说明明确列出 Text、Image、Video、Audio、PDF 五种输入形式,输出只有 Text。多模态理解不等于多模态内容生成;我们已将一张错误标注“Multimodal input and output”的插画隔离,不将它当作准确说明使用。
官方的百万 Token 是统一输入输出窗口,输入、思考与最终输出一起占用。默认同步输出限制为 65,536 Token,想超过这个值,应依照 长解码和 Background 机制控制任务执行与多段输出收集。不能把“最大上下文”直接等同于“单次同步生成 100 万 Token”。
API 价格与迁移要点
| 类型(美元/百万 Token) | 2026-11-30 前 | 2026-12-01 起 |
|---|---|---|
| 输入 | $2.00 | $4.00 |
| 输出(包含推理) | $10.00 | $20.00 |
| 隐式缓存命中输入 | $0.10 | $0.20 |
价格以 Google 官方迁移与定价指南为依据,不能当作本站实际账单。隐式缓存只有命中时才有折扣;模型不支持显式缓存创建。迁移需要核对模型 ID、Thinking Level、输出 Token 上限、背景执行方式、客户端超时和会话状态。官方还说明旧 sampling 参数 temperature、top_p、top_k 会被忽略。项目应移除无效控制项,而不是保留后错误归因给模型。
对生产系统而言,重要指标是每个被验收的实际任务消耗多少费用,而非只比较每百万 Token 的单价。Coding Agent 一旦加入长推理、Tool Call、错误恢复和多次尝试,相同标价也可能得到不同账单。
三、API 调用示例与迁移验证
Gemini 4 Argon 官方迁移说明展示了当前推荐的 Interactions API 调用。下面只是 API 文档格式示例,本次没有使用密钥向 Gemini 4 Argon 发送过请求:
curl 'https://generativelanguage.googleapis.com/v1beta/interactions' \
  -H 'Content-Type: application/json' \
  -H "x-goog-api-key: $GEMINI_API_KEY" \
  -X POST \
  -d '{"model":"gemini-4-argon","input":"Review this proposed code change for correctness."}'
调用成功只是接入冒烟测试,不能证明生产 Agent 安全或代码修改正确。准备迁移时还应在本地验证预算、超时、会话状态、显式缓存移除和被忽略的采样参数,避免把请求正常返回误当作任务验收通过。
四、真实项目实验:两项可证伪的任务
测试 A:Astro 路由代码审查
XBSTACK 的测试方案会将实际 Astro 文章路由代码交给模型,让它识别有证据支持的缺陷并提出有限范围的补丁。随后由独立验证流程检查 Diff、运行 Astro 类型检查与构建,同时保证旧文章 URL、Canonical、双语关系和导航不被擅改。
“模型说已修复”不计为成功;必须拿到实际修改、测试结果和人工或受限执行器的验收结论。实验需保存输入校验和、模型配置、响应内容、真实费用与失败案例。当前这些模型结果尚不存在。
测试 B:Agent 超时后会不会重复执行?
第二项任务采用独立的 LangGraph 超时恢复复现工程。模拟支付已完成,但 HTTP 响应超时;同一 Thread 恢复后 Tool 再执行,可能导致重复业务副作用。
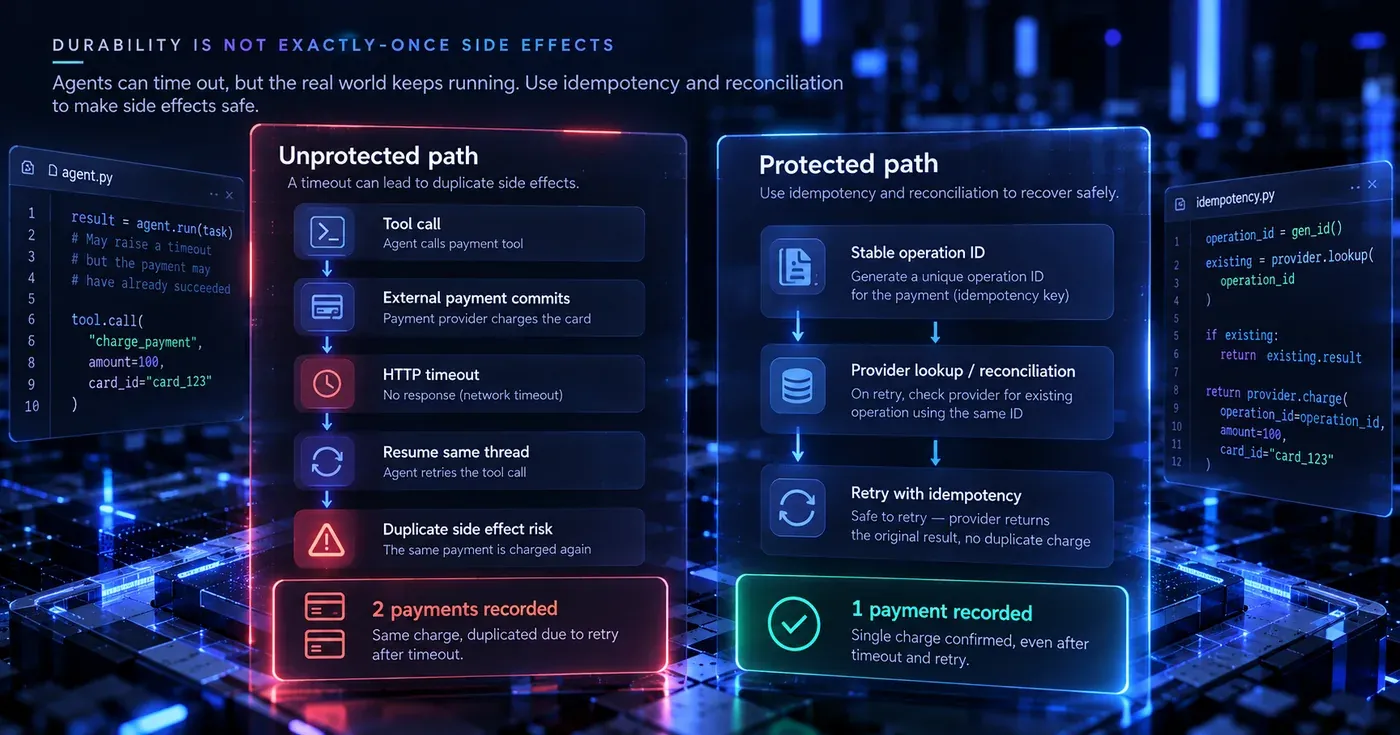
10 月 14 日我们单独运行了五组本地回归并全部通过。在模拟服务中,不采取幂等控制会累计两次付款;稳定业务操作键和核对逻辑将记录限制为一次。这只证明复现程序中的业务层保护有效,不能用来声称 Gemini 4 Argon 已经识别或修复该问题。后续模型评估必须要求它解释网络超时的不确定性、幂等边界、对账方案和人工审核条件。
准备怎样评价 Agent 任务结果?
应事先固定评分维度:准确理解源码、生成可审计 Diff、真实构建通过、没有误改路由、正确处理已提交但未确认的外部副作用,以及全部 Token 和重试成本。不同 Thinking 档位使用相同题目与环境进行复核,不能只挑最好的一次展示。
进一步阅读时,可从本站 Gemini 3.8 Flash 与 3.7 Flash 的既有选型分析理解版本边界;从 LangGraph 失败恢复与重试文章核对真实故障的独立修复路径,并在 AI Tools Lab查看其他可复现实验。这里的站内链接是相关阅读路线,不表示其他文章已经测试过 Argon。
这套验收方法并不只面向 Gemini:未来如果要评估 GPT、Claude 等 Cloud AI 模型或云端 Coding Agent,也应该采用相同任务与证据标准。目前本站没有完成这些模型之间的横向 A/B 测试。讨论更广义的 AI、AGI 能力边界时,也不能把一次代码生成或长上下文演示当作通用智能的证据。
六、现在应该迁移到 Argon 吗?
是否现在迁移?建议只对有明确验收标准的复杂 Coding 或 Agent 任务做小范围试点;高风险支付、邮件、生产文件改写等操作必须保持独立的权限、幂等和审计控制。不能因为新模型参数更大,就直接替换已经稳定运行的生产方案。
常见问题
Gemini 4 Argon 有免费 API 吗?
按照 Google 截至 10 月 14 日的说明,没有免费 Gemini API Tier,也不属于 Google AI Pro 的模型使用权益。正式接入前请核对 最新价格页。
Gemini 4 Argon 可以生成图片或视频吗?
不可以。该型号接收多种媒体输入,但模型输出是文本。理解视频和生成视频是不同功能。
XBSTACK 完成该模型实测了吗?
没有。我们准备了实验方案,并独立验证 LangGraph 的恢复场景,但 Gemini 4 Argon 本身还没有运行。任何“Gemini 实测成功率、耗时或费用”的数值在当前阶段都不能发布。
来源与证据界限
除了 Reuters 对本次 GA 发布的独立报道外,Google 自己公布的 ADK 真实仓库工程复盘也提供了来自厂商的运行例子,其中包含代码验收的局限;都不能当作本站模型实测。本文依据 Google 更新记录、官方模型页和 价格与迁移指南整理。本文为基于官方信息与独立工程证据的 API 迁移和测试方案,不包含 Gemini 4 Argon 的真实模型跑分;得到可复现的模型调用结果后将另行更新。
从单个 Agent 问题继续进入完整生产体系
AI Agent 专题统一组织架构、记忆、工具调用、评测、安全、部署和多智能体协作,让每篇文章都回到明确的主题主页面。
下一步:继续搭建 Agent 系统
完整专题路径 →沿着架构、工具、Memory、评测、安全或生产治理继续推进,不必重新从头找资料。
参与讨论
问题、验证与勘误
登录后可发表评论。所有新评论先进入审核;审核期间仅评论者本人和管理员可见,通过后才公开。