Claude Fable 5.2 升级后为什么报 400?Agent 历史消息、工具调用与成本排查
升级 Claude Fable 5.2 后出现 400、历史会话不能继续、工具失败或输出为空?从自建 Coding Agent 的请求前缀、Computer Use、Advisor、跨模型回退与费用核算入手,给出离线诊断代码、实证边界和生产回归流程。
本文目录
Claude Fable 5.2 升级后为什么报错?从 400 到 Agent 状态恢复的排查过程
一个正在运行的 Coding Agent 要从 Claude Fable 5.1 切到 Fable 5.2。开发者把模型 ID 改了,第一轮问答可能正常,第二轮带上历史工具结果却失败;或者 API 返回成功,但跨模型回退后明显不再利用之前的推理上下文。另一类系统连第一轮都没走到,直接报 400。这些现象可能来自不同的层次,处理错方向会浪费大量时间。
上面的情境是合成的工程案例,不是 XBSTACK 某个生产账号已经发生的故障。本文把排查拆成可以操作的过程:先看错误形态与迁移来源,再检查请求快照和工具配置,使用一套可运行的离线 Fixture 做预检查,最后设计需要真实 API 才能完成的回归。服务端协议事实引用 Anthropic 迁移指南 和 What’s new,截至 2026 年 11 月 10 日没有冒充本站已调用 Fable 5.2 并复现 400。
先用两分钟分诊:同样是“升级失败”,不一定是同一种故障
如果你搜索的是“Claude API 报 400 怎么办”,先明确 HTTP 400 通常表示请求未满足 API 参数或消息格式要求,它不等于服务器暂时不可用,也不是 429 限流或 5xx 服务端故障。只看到 invalid_request_error 仍不足以判断是哪一项参数出错,必须结合安全脱敏后的错误信息和实际请求结构。升级后“不能继续聊天”,也要分辨是会话历史重放失败,还是账号、工具或模型路由配置发生变化。
不要第一步就调低 temperature、删旧对话或无限重试。先保存脱敏后的错误类型、来源模型、目标模型、平台、工具版本和发生在哪一轮。
| 读者看到的症状 | 最先查什么 | 不能直接下的结论 |
|---|---|---|
| 400,包含 `The block is bound to a different conversation` | `system/tools/messages` 历史前缀是否被改动;旧 thinking 块是否原样回传 | “API 不稳定,再试几次即可” |
| 400,首轮工具调用就失败 | `tool_choice`、thinking 模式、旧 Computer Use 工具、Advisor 配对 | “全部都是 5.2 新增限制” |
| 400,ZDR 工作区调用失败 | 账号/工作区的数据保留策略及模型授权 | “本地存储数据,所以供应商必然零保留” |
| HTTP 200,但模型回退后上下文表现不同 | 模型路由、thinking 块兼容和 `input_transformations` | “HTTP 200 = 推理状态完整恢复” |
| `stop_reason=max_tokens`,可见正文很少甚至没有 | adaptive thinking、effort、输出预算、内容块类型 | “模型没有生成能力” |
| 单价变便宜,任务费用反而上涨 | 缓存命中、思考量、重试、工具与子 Agent 调用数 | “厂商公布降价一定代表单任务降价” |
要特别区分从哪里迁移。Fable 5.1 已经使用始终开启的 Adaptive Thinking、限制强制工具调用,并有数据保留要求;它们不都是 5.2 新加的破坏性变化。从更老的 Opus 配置迁入时,同样的字段才可能构成新的兼容障碍。https://platform.claude.com/docs/en/models/fable-5-2/migration-guide
场景一:第一轮正常,续聊却出现 thinking 签名 400
出错是怎样形成的?
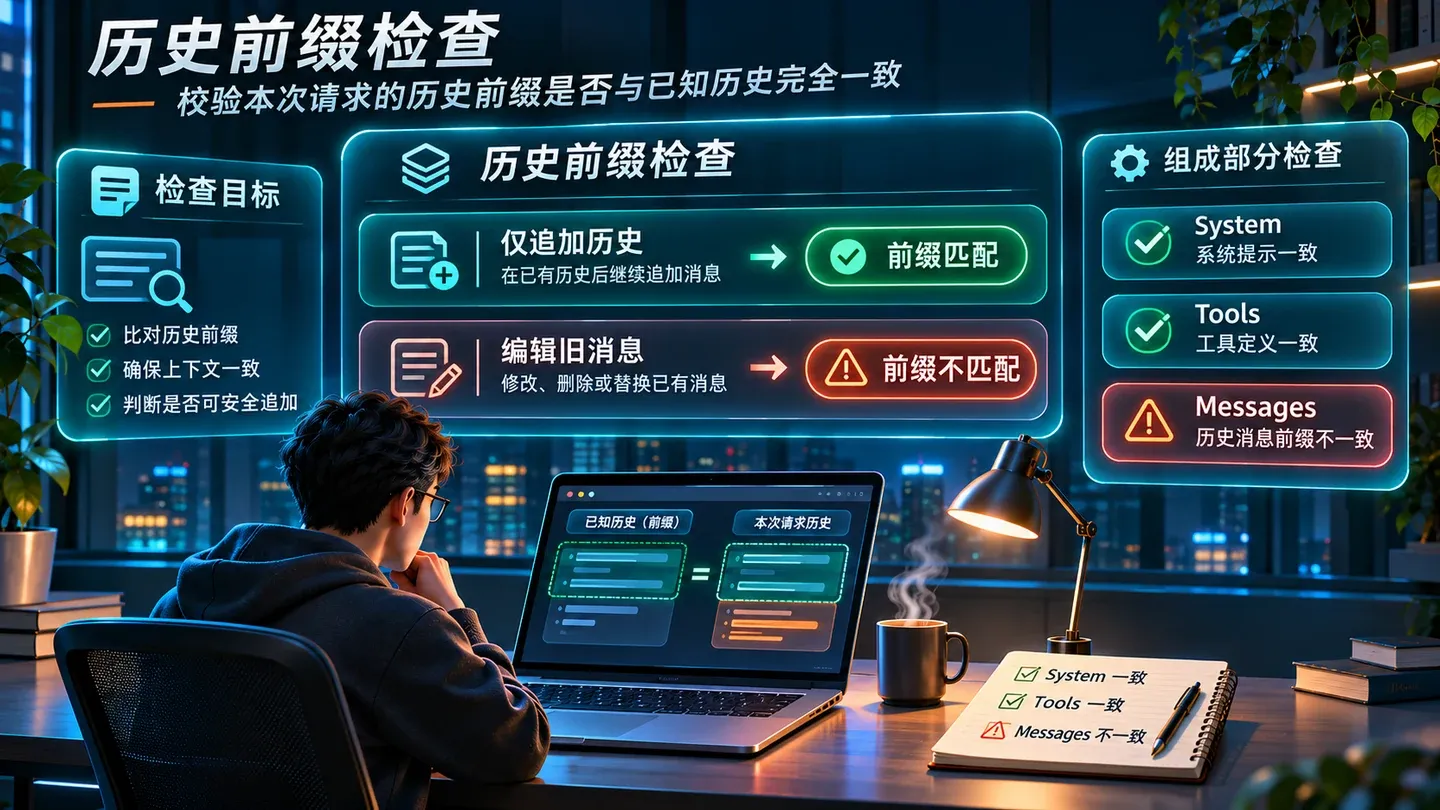
假设旧 Agent 在存储历史时做过一种常见“优化”:前一轮由模型返回 `assistant` 的 `thinking` 和 `text` 两个块;下一轮为了减少上下文,把最早的 `user` 消息改成摘要,再把上轮 thinking 原样塞回去。
```js // 示意:不是 Anthropic 真实返回的签名块 const before = { system: ‘Use the approved tools.’, tools: [{ name: ‘search’, input_schema: { type: ‘object’, properties: {} } }], messages: [ { role: ‘user’, content: ‘Check issue A.’ }, { role: ‘assistant’, content: [ { type: ‘thinking’, thinking: ‘SYNTHETIC_ONLY’ }, { type: ‘text’, text: ‘First diagnosis.’ }, ] }, ], };
const next = structuredClone(before); next.messages[0].content = ‘Summarized earlier context’; // 改写已被绑定的前缀 next.messages.push({ role: ‘user’, content: ‘Continue.’ }); ```
这是合成数据的前缀变更示例,刻意不包含真实 thinking 签名。Fable 5.2 的官方机制会核对前一块 thinking 之前的 `system`、`tools` 和早期 `messages`。如果请求携带了与新前缀不匹配的 thinking 块,在没有专门的丢弃控制时会返回 400。对所有 Fable 5.2 账号均执行这一检查;但旧版 Fable 5.1 的适用情况与账号创建时间有关。https://platform.claude.com/docs/en/models/fable-5-2/whats-new-fable-5-2
从代码上先排除哪些原因?
检查四个时点:API 返回时保存了哪些块;写入数据库后是否丢掉空 thinking 或调整 content 顺序;重新组装请求时是否编辑了历史消息;动态 MCP 工具表或 system prompt 是否改变。
```bash node —test experiments/claude-fable-5-2-migration/*.test.mjs ```
在 XBSTACK 的工作区里,`preflight.mjs` 对两个合成请求快照计算有序 JSON 指纹,`diagnose-migration.mjs` 把前缀变化映射到 `PREFIX_MUTATION`。下面这个调用可以粘贴到项目自己的合成测试环境:
```js import { auditPrefix } from ’./experiments/claude-fable-5-2-migration/preflight.mjs’;
const report = auditPrefix(before, next); console.log(report.changedFields); // [{ code: ‘EARLIER_MESSAGE_CHANGED’, index: 0 }] ```
我们实际验证了什么? 2026 年 11 月 10 日,在本地执行 14 项 Node 测试,14 项全部通过,覆盖历史消息只追加、修改/删减旧消息、改变工具声明和费用计算等。这个检查器不是 Anthropic 签名算法的实现,不能得出“已复现线上 400”或“已经修好供应商服务”的结论。
怎样修?怎样判断修好了?
原则上保存模型返回的每一个 assistant content block,并按原顺序回放;同一会话的 `system`、`tools` 保持稳定,普通对话历史只追加。如果业务确实需要压缩,优先研究官方支持的服务端压缩/上下文编辑和中途 system 指令能力,注意各平台支持范围。
官方提供一个临时策略:使用 `thinking-binding-controls-2026-08-01` Beta Header,并在支持的请求中设置 `thinking.block_binding.prefix_mismatch_behavior: “drop_block”`。它会丢弃不兼容块而不是修复签名,需要监控响应中的 `input_transformations`。丢弃后输出 Token 可能增加,不能把过渡措施默认为长期最优解。
完整验收必须等真实 API 测试:固定 system 与 tools、多轮 Tool Result 回放不报签名错误;人为改旧历史时错误或 transformation 符合官方预期;恢复策略不重复执行产生外部副作用的工具。
场景二:首轮就报 400,先判断是哪个“来源模型”的配置遗留
“400”只是请求被拒绝,不能仅凭状态码猜根因。以下矩阵更适合作为工程扫描表:
| 检查对象 | 哪种迁移需要关注 | 应如何处理 |
|---|---|---|
| `thinking: {type:“disabled”}`、手动 `budget_tokens` | 从仍支持手动/禁用 thinking 的旧版 Opus 迁入 | 改用 adaptive thinking 与 effort;Fable 5.1 已有这一限制 |
| `tool_choice: {type:“any”}` 或 `{type:“tool”,name:”…”}` | 旧 Opus 的强制工具调用配置 | 改为 `auto`,工具输入仍需应用层验证;Fable 5.1 也不支持强制工具调用 |
| `computer_20251124` | 使用旧 Computer Use 的 Fable 5.1/早期集成 | 在 Amazon Bedrock 以外 迁到 `computer_toolset_20260801` 并改 Agent Loop |
| Fable 5.2 executor + Fable 5.1 advisor | 使用 Advisor Beta 的多模型 Agent | 将 advisor 更换为 Fable 5.2 或获得授权的 Mythos 5.2;换工具声明需新会话 |
| `temperature/top_p/top_k` | 从其他模型复制原始请求参数 | 按型号支持范围去掉;不能靠盲目重试 |
| ZDR 工作区 | 涉及数据保留与模型可用性 | 先核对是否允许 30 天保留及 Anthropic 明确的例外授权 |
一个典型的混合故障: 先更新 advisor 模型,产生 `tools` 差异;如果仍使用同一会话先前生成的 thinking,可能又触发前缀校验。此时不是两个独立无关的 400,应同时检查工具声明变化和历史回放。官方要求新会话处理这种配置迁移。https://platform.claude.com/docs/en/models/fable-5-2/whats-new-fable-5-2
场景三:排查工具不应该直接发送真实 API 请求——先做静态分流
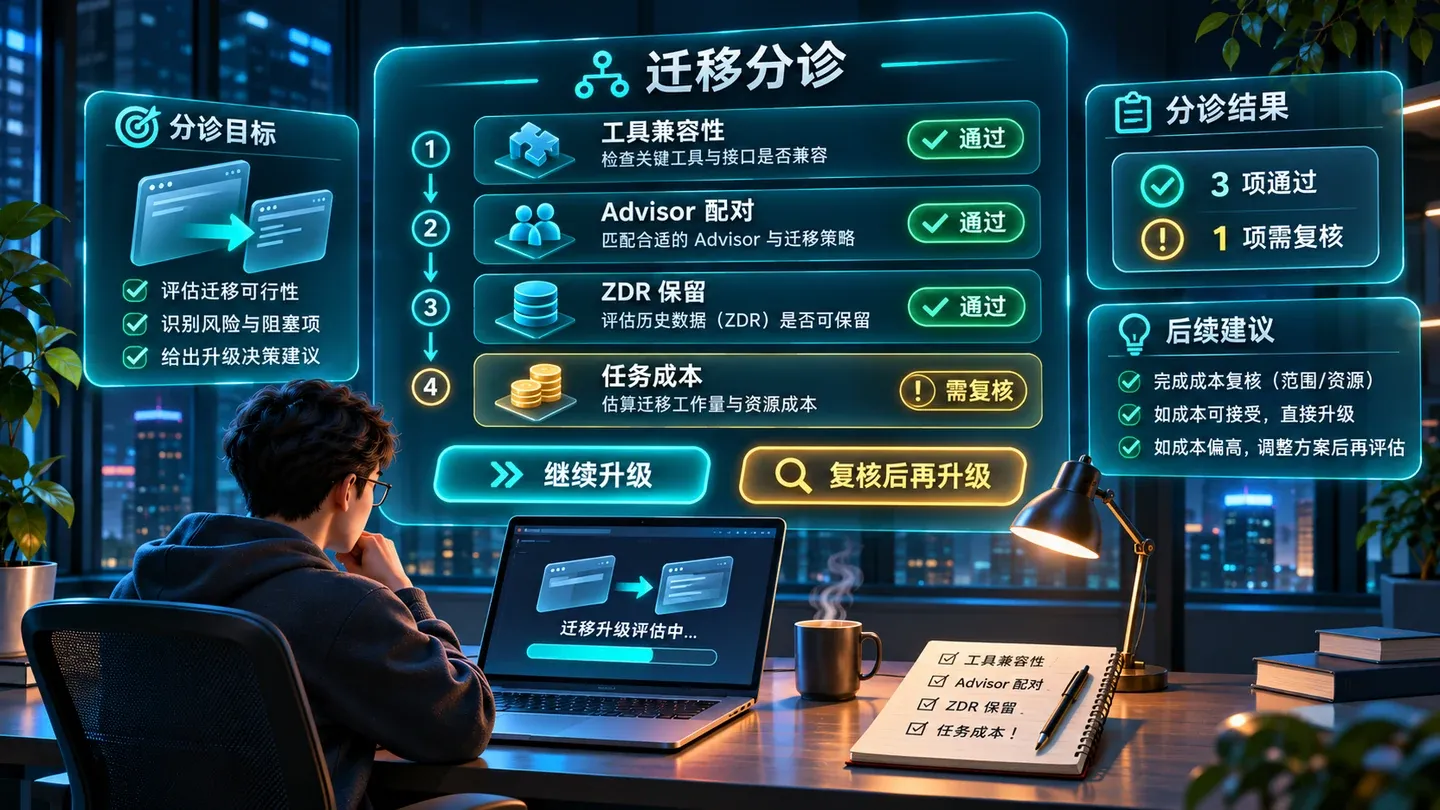
为了把“看官方文档”推进到可运行的工程交付,我们增加了一个静态诊断入口:
```js import { diagnoseMigration } from ’./experiments/claude-fable-5-2-migration/diagnose-migration.mjs’;
const report = diagnoseMigration({ sourceModel: ‘claude-fable-5-1’, nextRequest: { system: ‘SYNTHETIC’, messages: [{ role: ‘user’, content: ‘SYNTHETIC’ }], tools: [{ type: ‘computer_20251124’, name: ‘computer’ }], tool_choice: { type: ‘any’ }, }, platform: ‘claude-api’, advisorModel: ‘claude-fable-5-1’, requiresZdr: true, });
console.table(report.findings.map(({code, severity}) => ({code, severity}))); // LEGACY_COMPUTER_TOOL / FORCED_TOOL_CHOICE / ADVISOR_MODEL_INCOMPATIBLE / RETENTION_POLICY_BLOCK ```
此工具只做规则匹配。它不会读取 API 密钥,不模拟真实模型,也不根据本地规则直接制造 Anthropic 400。对于从 5.1 迁移的源模型,它还会显式标明强制工具调用等限制并非 5.2 新增。对用户实际日志的使用,应先脱敏,并且绝不把 thinking 原文、系统提示词、密钥或用户文档写到公开日志。
本地 14 项回归覆盖了:
| Fixture 类别 | 检查结果 | 证明范围 |
|---|---|---|
| 追加历史与篡改旧消息 | PASS | 本地输入快照变化能被发现 |
| 强制调用、手动 thinking、Computer Use 平台例外 | PASS | 本地诊断规则与官方描述一致 |
| Advisor、ZDR 和跨模型回退的不同严重性 | PASS | 本地可阻断与可警告项区分正确 |
| 公布价格的假设费用和非法输入 | PASS | 计费算式在已给出的测试数据上成立 |
Fixture 测试结果不代表外部模型服务端的通过率。 这是本文最重要的证据边界。
场景四:API 返回 200,但路由切换后 Agent 像“忘记”了过程
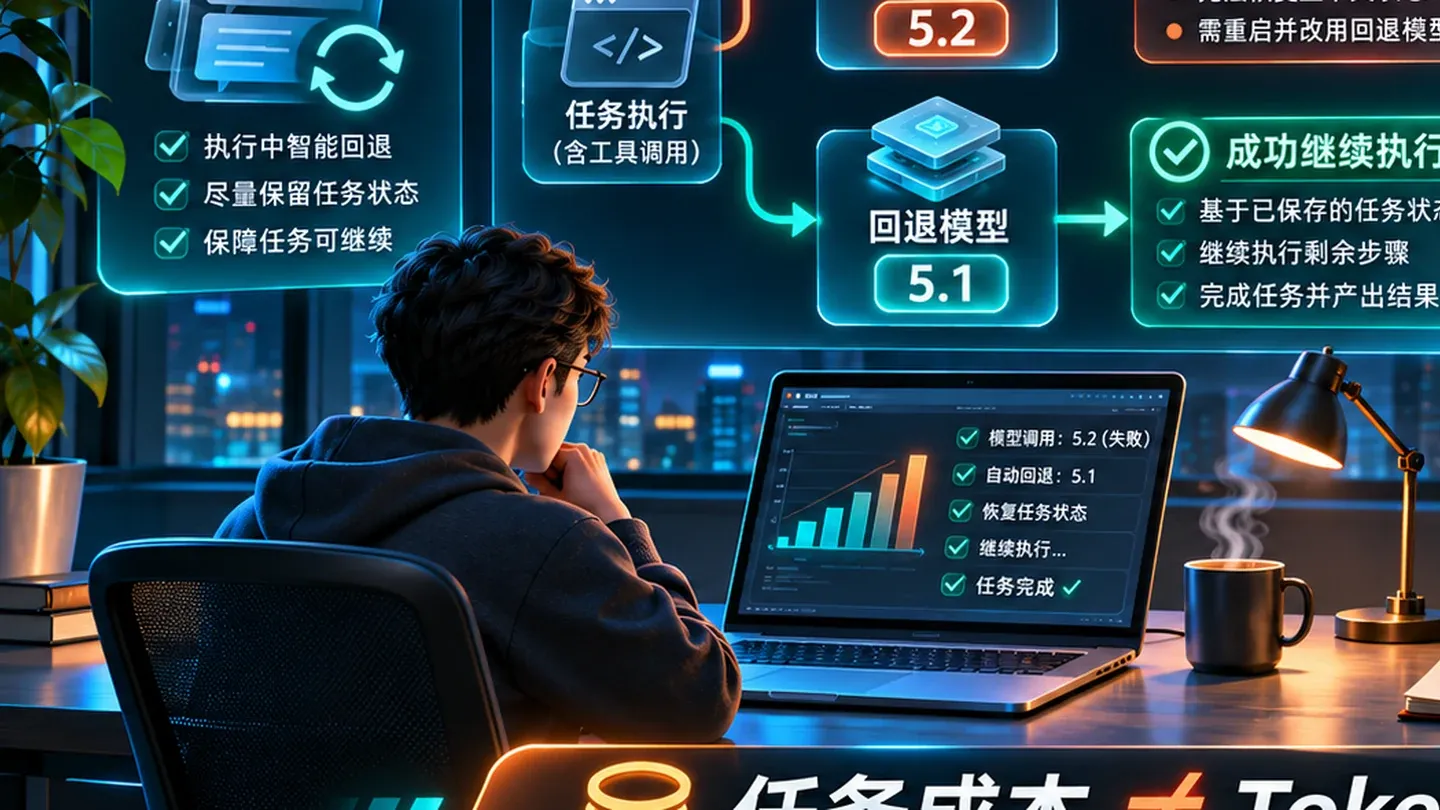
在同一工作流中,Fable 5.2 处理复杂阶段,随后切到 Fable 5.1、Opus 5.5 等更便宜的模型是合理的成本策略。然而不同模型的 thinking 块不是全互通。
官方文档指出,在支持的 Claude API 和指定 Google 管理平台上,Fable 5.2 可以读取较早模型的许多 thinking 块;相反,Fable 5.1、Opus 5.5 等模型不能读取 Fable 5.2 写出的 thinking 块。这些块可能在输入阶段被丢弃,而请求仍成功;带有适用 Beta Header 时,`input_transformations` 可以记录 `model_binding_mismatch`。
所以不要把问题归类为“模型无缘无故降智”,应区分文本/工具结果保留与内部 thinking 可用性。推荐将恢复检查分为:模型来源 → 目标、是否携带 thinking、提供商是否报告转换、任务结果是否通过,以及是否重复执行已产生外部副作用的工具。
工程判断: 如果你的工作流真正依赖长会话状态,模型切换时应以应用侧持久的任务状态、引用和工具回执作为可信恢复基础,不能把私有 reasoning block 当成跨模型、跨账号通用的长期记忆格式。这一建议不依赖某个版本是否修复。
场景五:请求成功却没有正文、或者 ZDR/隐私配置直接挡住上线
看起来像“空回复”:Fable 5.2 始终启用 Adaptive Thinking,默认 `high` effort,`max_tokens` 覆盖思考与文本输出。若预算过小,有可能 `stop_reason: “max_tokens”`,但文本块尚未出现。解析时不要默认 `content[0].text` 存在;要按 `type` 找文本,记录 `stop_reason` 并为 thinking 预留预算。调整 effort 前先确认你使用的客户端和平台支持相应参数。
ZDR 问题比调参更优先。 官方写明 Fable 5.2 通常要求 30 天的数据保留,除非获得 Anthropic 的明确授权例外;普通 ZDR 工作区不应直接当作可用模型。在 Claude API 上,不满足条件的组织/工作区可能报 400。这与“我们的 App 把用户文件本地存储”是不同层次:本地数据策略不自动决定模型供应商对主动发送内容的保留政策。对于带有隐私承诺的产品,要先通过供应商政策和工作区配置审查,才能开放该云模型入口。https://platform.claude.com/docs/en/models/fable-5-2/overview
场景六:5.2 公布降价 20%,为什么你的 Agent 账单未必少?
目前官方标准价格为 Fable 5.1 每百万输入/输出 Token 50,Fable 5.2 为 40。这只说明同等输入输出量的标准单位价格下降 20%,不保证任务成本下降。https://platform.claude.com/docs/en/models/fable-5-2/overview
举一个明确的假设:一次任务使用 50 万未缓存输入 + 10 万输出,不计算额外工具:
| 模型 | 假设输入费 | 假设输出费 | 假设总价 |
|---|---|---|---|
| Fable 5.1 | $5 | $5 | $10 |
| Fable 5.2 | $4 | $4 | $8 |
我们使用 `estimateCost()` 编写并测试了这一简单算式,但尚未读取真实 Anthropic 用量与账单。它不包括 cache write/read 的组合、平台差价、失败重试、子 Agent、沙箱和工具费;真实核算必须记录这些部分。
有意义的实验不应该问“每百万 Token 谁便宜”,而应该问“同一批真实任务在同样质量门槛下,每成功完成一次工作花多少钱”。最低限度记录:
```text task_id, model_id, source_model, effort, prompt_version input_tokens, output_tokens, cache_read, cache_write tool_attempts, tool_side_effect_ids, retries, subagent_runs stop_reason, input_transformations, elapsed_ms task_passed, human_fix_minutes, cost_usd ```
如果模型出现额外的思考、回放、重试或者在回退过程中丢失 reasoning,结果可能跟标准单价背道而驰。
一套可以真正落地的灰度验收:别把静态 PASS 当成上线许可
第 0 步:隐私/授权门禁。 检查本项目数据保留要求、模型可访问权限、成本预算和 Rate Limit。没有通过就保持旧模型,绝不为了测试上传用户真实数据。
第 1 步:离线预检查。 对合成快照运行:
```bash node —test experiments/claude-fable-5-2-migration/*.test.mjs ```
本轮 14/14 PASS,只证明工具自身测试通过。运行目录中的 `README.md` 给出了范围与注意事项。
第 2 步:隔离的真实 API 集成验证(尚未执行)。 按来源模型分别准备合法/非法的 thinking 续跑、旧 Computer Use、Advisor 切换、强制 Tool Choice、空正文预算、跨模型 fallback 样例。所有场景使用测试账号和无敏感内容的人工数据,保留脱敏 HTTP 状态和官方字段,而不是复制供应商错误给最终用户。
第 3 步:固定的 Coding Agent 任务组(尚未执行)。 至少包含一个多轮 Tool Result 恢复、一个可判定对错的代码修复、一个中断后幂等续跑。每个场景锁定任务和评估标准;性能对比采用同一质量门槛,不能临时改题。
第 4 步:回滚。 旧模型路由保留,新的工具声明/系统提示/Advisor 变更通过版本化新会话推进;如果要回退,不把 Fable 5.2 thinking 原样交给不兼容模型并假设可读取。已执行的外部操作依幂等键对账,而不是从头再调用。
是否真正上线,应由 隐私条件、真实 API 回归、任务表现和成本一起决定,而不是因为“Node 测试全部绿色”就直接切换生产。
值不值得升级?我的工程判断
如果你只是短时间问答、常规代码补全或阅读总结,先把 Opus / Sonnet 等成本较低的候选跑成基线。Fable 5.2 更值得留给长时间 Coding Agent、深度迁移和需要复杂工具编排的任务,但最终选择仍取决于你的可复现评测,而不是厂商排行榜。
对 已经从 Fable 5.1 运行平稳的自建 Agent,优先级不是立刻全量改模型 ID,而是确认历史会话是否自建、是否会改旧消息、有没有 Computer Use/Advisor 依赖,以及隐私与路由是否满足新模型边界。只有这些环节确认后,才值得花时间比较智能表现与总成本。
这篇内容与站内 Fable 5.1 / Mythos 5.1 价格及权限比较的读者任务不同:旧文解决“选哪个模型”,本文回答“现有 Agent 升级后怎样定位具体故障并验证安全切换”。关于工具执行、幂等和流式恢复,还可以阅读 AI SDK 7 生产迁移实战;需要在生产系统层面长期跟踪任务状态、人工审批和回滚,可参考 AI Agent 生产化治理。
本文证据来源与局限
- Anthropic Fable 5.2 迁移指南:不同来源模型的参数、历史、Tool、Advisor 与 ZDR 条件。
- Fable 5.2 What’s new:前缀绑定、回退兼容、平台例外。
- Fable 5.2 模型规格:模型 ID、价格、上下文、保留政策。
- 2026 年 11 月 9 日 Anthropic 发布信息:发布日期及官方产品定位。
证据边界: XBSTACK 已开发并运行 14 项离线合成请求测试;没有调用真实 Claude Fable 5.2 API,也没有得到厂商侧 400、响应延迟或真实账单。本文不是官方文档的逐项翻译,而是面向具体故障做的独立工程分诊、代码检查和回归设计;任何需要供应商在线验证的结论均按官方来源标注,尚待后续实测补充。
从单个 Agent 问题继续进入完整生产体系
AI Agent 专题统一组织架构、记忆、工具调用、评测、安全、部署和多智能体协作,让每篇文章都回到明确的主题主页面。
下一步:继续搭建 Agent 系统
完整专题路径 →沿着架构、工具、Memory、评测、安全或生产治理继续推进,不必重新从头找资料。
参与讨论
问题、验证与勘误
登录后可发表评论。所有新评论先进入审核;审核期间仅评论者本人和管理员可见,通过后才公开。