用户自填 API Key,AI App 就更隐私了吗?本地 AI、云端数据保留与 BYOK 的真正边界
用户自填 API Key 不代表数据不出设备。结合 Gemini 新项目日志设置与 OpenAI ZDR,详解本地 RAG 资料外发、服务端代理、Key 安全、供应商保留与删除验证。
Evidence 5 条资料来源
本文目录
“用户自己填写 API Key,所以资料不会经过 App 开发商”这句话,只有在非常具体的网络和权限结构下才可能成立。 密钥归用户持有,不代表请求一定直接到模型厂商;请求不经过应用服务器,也不等于模型供应商不会保存;关闭某个日志选项,也不等于缓存、文件、后台任务、第三方搜索和应用自己的数据库同时遗忘。一个声称隐私优先的 AI App,真正需要解释的不是是否出现“本地 AI”“BYOK”“零数据保留”几个标签,而是每一次资料处理的数据控制者、目的地、存储时长、删除能力和可验证证据。
这个问题对于个人知识库尤其重要。应用在本地检索出三段文档,然后通过用户自填的 Key 询问云端模型,用户的原始 PDF 可能从未上传;但这三段片段、用户本次问题、引用标题、甚至附带的系统摘要可能已经成为云端输入。对用户来说,关键不是“上传了文件还是没上传文件”,而是“哪些字节已经离开设备、到哪里、为什么、谁还能留存”。
首先画出数据流,而不是先写隐私承诺
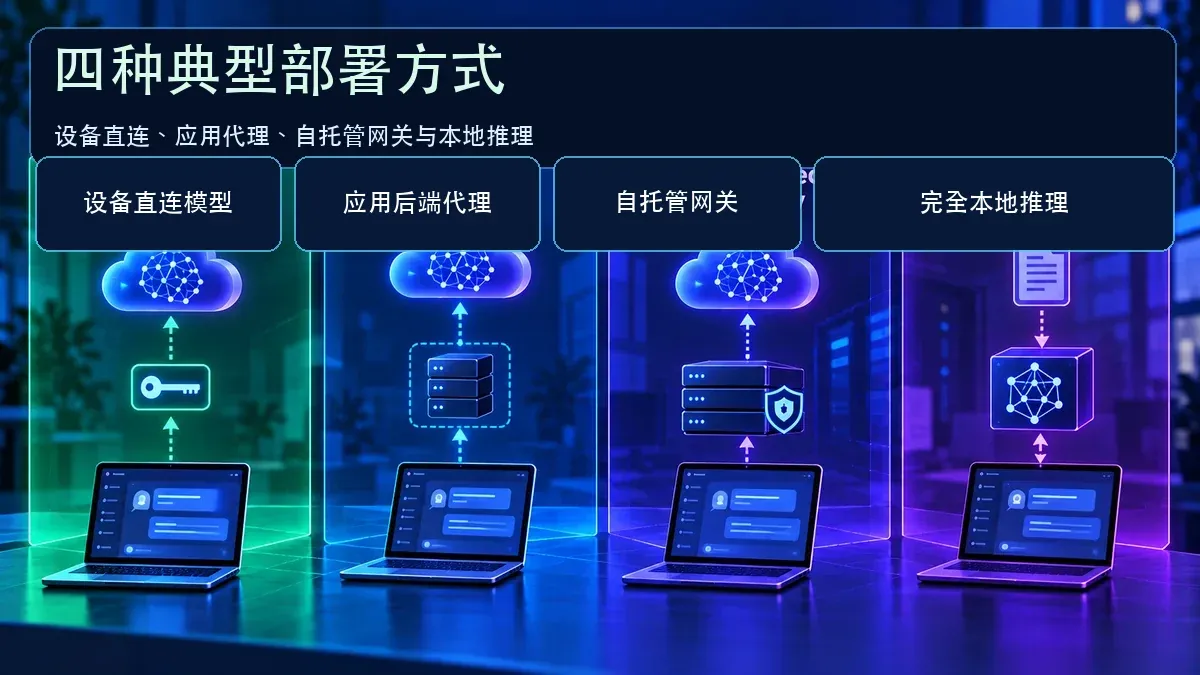
图 1|四种部署模式应分别核对 Key、资料片段、应用后端和模型供应商的数据流;BYOK 本身不代表内容留在设备。
BYOK 产品至少存在三种典型部署方式。第一种是设备直连供应商:Key 在客户端安全存储,客户端本地完成检索后,向供应商 HTTPS 端点发送被授权的上下文。此时应用开发者的后端理论上无需看到问答内容,但供应商可按自己的条款处理请求;客户端上的密钥仍可能受到本机入侵、调试、恶意代理或被篡改应用的威胁。第二种是应用后端代理模型请求:用户虽然填写自己的 Key,请求和密钥(或临时凭据)却经过应用服务器;运维日志、APM、错误上报、反向代理和备份都可能形成额外数据副本。第三种是用户自托管网关:应用连接用户或其组织运营的推理端点,组织可控制日志与保留策略,但网络配置、身份鉴别、版本维护和上游再调用仍需核验。不能把这三种模式简单合并为“BYOK”。
本地推理是第四条不同路径:模型在设备上运行,资料与上下文不必发给外部模型供应商,但如果产品仍启用了云同步、在线搜索、崩溃诊断上传或远程 Embedding,本地模型本身并不能保证“所有数据永不离开设备”。一个负责任的设置页面应将“本地问答”“云端模型”“联网搜索”“资料同步”“诊断日志”拆成不同开关,并在用户切换模式时明确提示本次将传输哪些内容。对于 RecalAI 类型的本地资料库,最好在生成前让用户能看到将发送的摘要/选定证据片段预览,而不是只显示目标模型名称。
2026 年 10 月 26 日,Gemini API 改变了一个值得重视的默认值
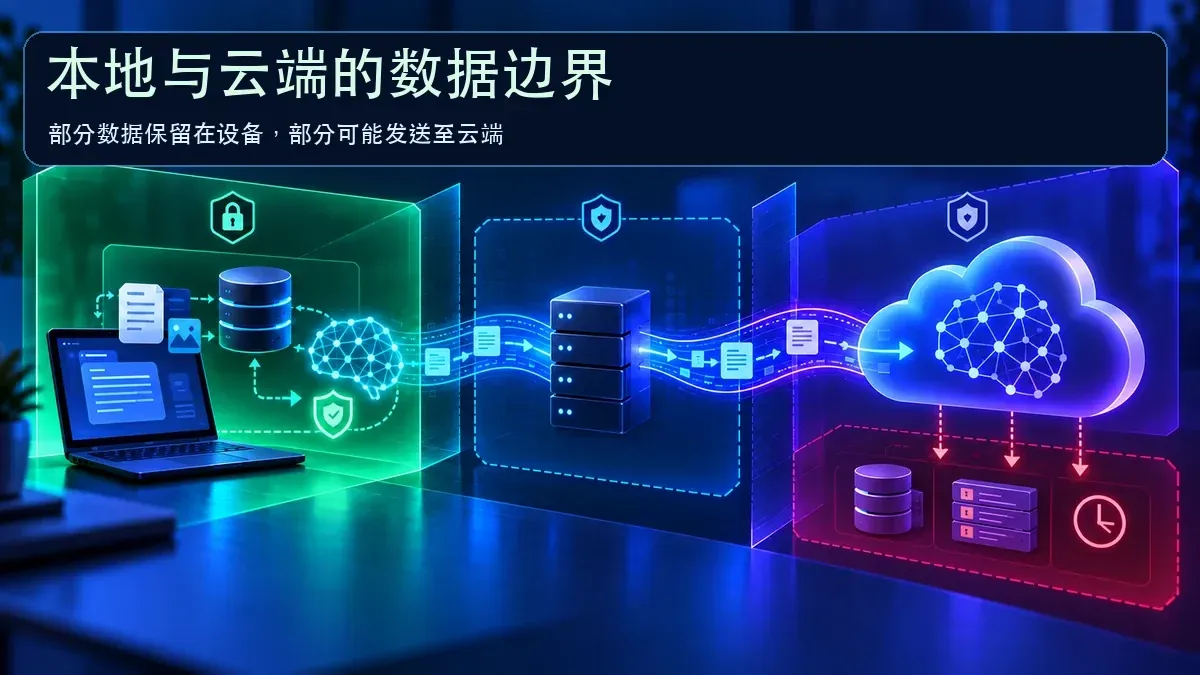
图 2|本地与云端之间的数据流边界;供应商项目日志、缓存与应用侧处理策略需独立核查。此图并非 Gemini 具体 API 配置截图。
Google 官方在 Gemini Logs and Datasets 文档 中说明:2026 年 10 月 26 日及以后创建的新项目,Generate Content API 请求默认存储,等效于 store=true;此前的旧项目默认仍是 store=false,除非曾在 AI Studio 中启用相关日志。Interactions API 的请求存储又有自己的默认行为,因为服务端会话状态需要依赖它。项目管理员可以在 AI Studio 分别控制 Generate Content 与 Interactions 的存储设置,并可对单次请求指定。这里不能偷换成“所有 Gemini API 用户从 10 月 26 日开始都被默认存储”,更不能混淆旧项目与新项目、免费调用与文档说明的付费项目日志能力。
该文档同时指出,支持的 API 日志一般保留最多 55 天,可调整至 7、14、28 或 55 天;保存为 Dataset 的记录有不同生命周期,不会按普通日志期限自动过期。日志可显示请求和响应内容,也可以选择将选定数据分享为产品反馈。值得特别强调,项目私有日志、供应商滥用防护监控以及用户主动分享以改进模型的数据是不同的处理目的:开启日志并不直接等于“全部用于训练”,关闭项目日志也不等于所有供应商侧系统均零留存。真正的隐私说明必须逐层表达默认设置、请求覆盖、保留时间、分享机制、删除流程与例外。
因此即使应用对每次请求明确发送 store=false,也不能孤立用这个字段承诺整个 AI 系统零存储。它通常只控制某类应用状态或项目日志,仍须核对具体 endpoint 的其他留存、文件和安全处理规则。更稳妥的实现是默认采用供应商允许的最小化保存配置,对需要持续服务端会话的功能解释其必要性,并用脱敏的测试项目实际核验项目设置与请求覆盖是否一致。
OpenAI 的 ZDR 不是整个 Agent 系统“所有节点零存储”
OpenAI 的 Data Controls 官方文档 区分 abuse monitoring logs(滥用监测日志)和 application state(应用状态)。常规 API 请求默认不用于训练模型,除非客户主动选择共享用于改进;但这和日志留存属于两个问题。符合条件并获批准的组织可以启用 Zero Data Retention(ZDR):对于支持的 Responses / Chat Completions 调用,store 参数即便被请求设置成 true,也会按 false 处理。ZDR 不是所有普通开发者默认都具备的开关,更不等于第三方 MCP、托管容器、缓存、文件、向量存储、后台执行、会话对象或组织自己的日志全都同步删除。
例如,远程 MCP 服务是第三方:发送给它的数据服从第三方的保留政策;Background Mode 为了轮询任务可能暂时在磁盘保留数据;Hosted Shell 或 Code Interpreter 的容器有自己的临时文件生命周期。Conversations 与 Responses 的状态维护方式不同,ZDR 的 endpoint 适用性和地域处理也需要逐项核对。对“已经通过 BYOK 启用 OpenAI ZDR”的宣传,应要求应用能提供当前组织/项目的真实控制状态、使用的具体 endpoint、工具清单及数据路径,而不是凭 UI 里出现一个“隐私模式”图标推断合同已生效。
在技术设计上,最好对不同供应商建立统一的数据策略契约:本次请求是否允许传资料、是否允许持久化、是否允许用于模型训练、是否有区域限制、是否启用外部工具、是否可删除、失败后是否允许自动重试。供应商没有提供相应保证时,应标为“不确定 / 不支持”,而不是静默按最严格选项处理。统一策略不是统一政策:同一个字段名称在不同 API、不同账户等级上的语义可能不同。
从端侧检索到云端回答,五个地方最容易泄漏
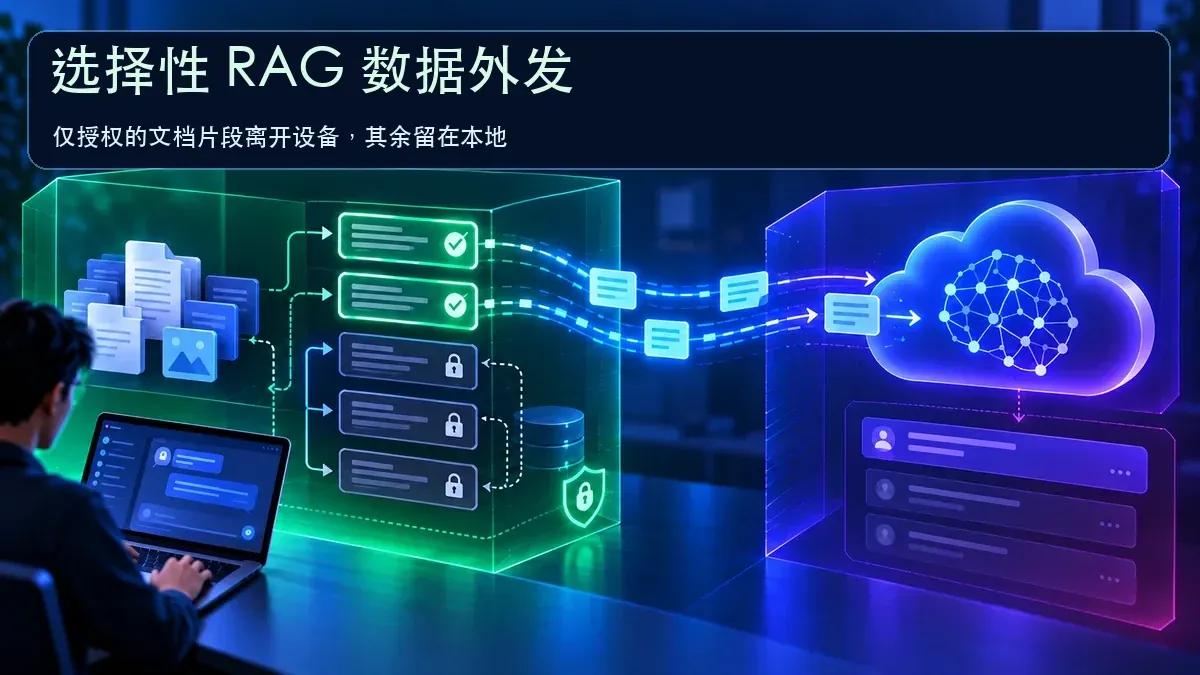
图 3|Selective RAG Egress:只有完成授权与证据筛选的 Chunk 才允许发送给远端模型,不能据此声称 RecalAI 已在所有平台实现该机制。
第一是上下文组装。混合检索通常先用 FTS、Embedding 与 Rerank 找到相关 Chunk。即使用户只问一句“这份合同有哪些风险”,云端模型收到的可能是多个合同片段。应按知识空间、文件权限、意图和 Token Budget 限制能被组装的证据,默认不传整个文档,不因云端模型支持长上下文就扩大暴露范围。
第二是密钥存储和日志。移动端应使用平台安全存储(例如 iOS Keychain、Android Keystore 的适当封装),桌面端使用系统凭据或密钥保护设施。不要把长期 Key 硬编码进可发布应用,不要向浏览器控制台、代理服务日志、崩溃上报和分析埋点发送 Key、Authorization 头或用户全文。若采用代理转发,要明确是否在服务器收到完整请求与密钥,如何限定保留时长以及如何撤销。
第三是隐式联网工具。模型供应商的 Web Search、Remote MCP、Browser、Computer Use、File Search 可能增加新的处理方。用户授权“调用云端模型”,不一定授权“把本地合同再送给第三方抓取工具”。应用应分别批准模型调用和特定工具的联网范围,审计工具调用链上的跨域出站流量,并阻止模型用外部网页指令劫持高权限行为。
第四是数据删除。删除 App 内一份资料,只能证明本地索引和记录发生变化;此前发送的摘要、API 项目日志、供应商会话状态、工具缓存、代理后台错误快照和备份,可能各自需要独立清理。应将删除分为“应用本地失效”“服务端保存状态删除”“第三方保留期结束”三个不同承诺,不能在点击删除按钮后显示“互联网上所有副本均已永久删除”。
第五是跨设备同步与备份。本地优先不应被默认解释为“永远只有这一台设备有明文”。端到端加密与服务端可读同步不是同一种隐私模型;密钥托管、恢复机制、设备撤销和备份过期需要进入同一张数据流表,避免用户在手机端选择关闭云端模型后,桌面端仍继续外发旧对话上下文。
推荐的工程验收:用网络证据,而不是用营销措辞
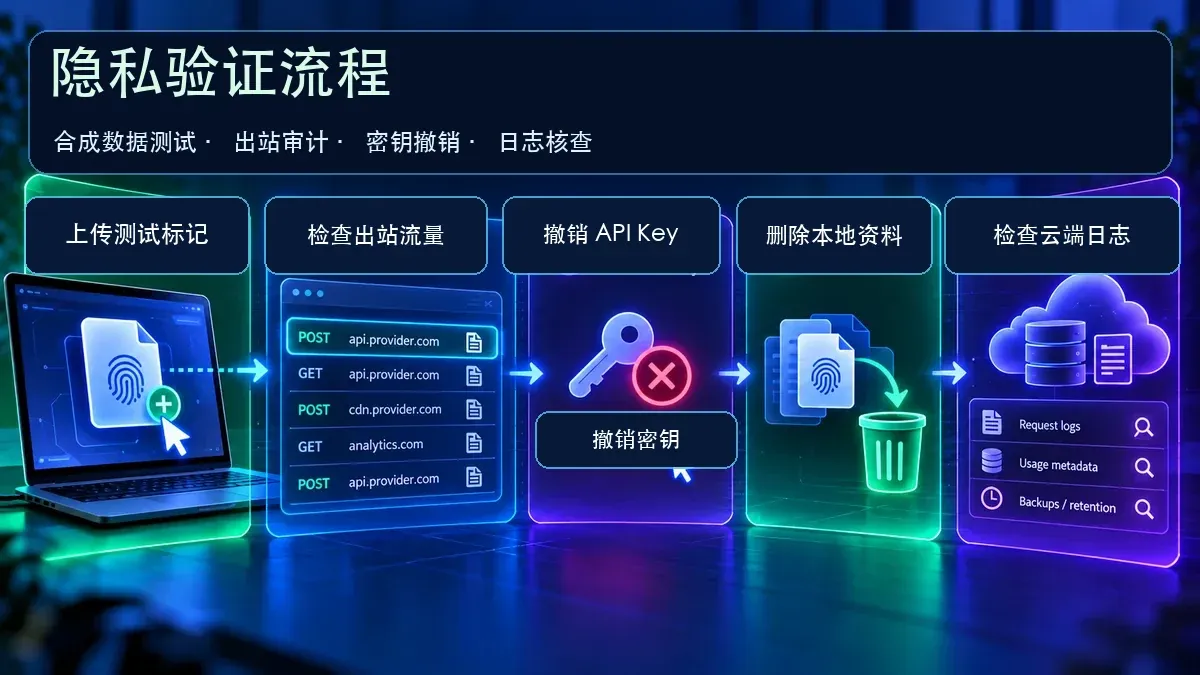
图 4|使用合成文档与脱敏网络日志检查真实数据边界;撤销本地 Key 不自动删除模型供应商已保存的日志或备份。
一个可审计的 BYOK 产品至少要证明四条行为。其一,在“本地模式 + 联网搜索关闭”时,生成和检索路径没有向外部模型或工具发送知识内容;其二,云端模式开启后仅传送用户授权的选定片段,且请求目标、上下文大小和对应权限可解释;其三,应用自身错误监控、运营分析、代理日志不存储密钥或未经许可的用户全文;其四,切换供应商、停用某 Key 或删除本地资料后,应用确实停止使用原凭据和已撤销 Chunk。要验证这些,应使用隔离测试项目、脱敏假文档和可控网关记录,检查请求目的地、HTTP Body/Headers 的脱敏摘要、云端项目日志设置、重新打开应用后的状态;不能在生产个人隐私数据上盲目抓包测试。
对应的接口设计可提供一份内部数据策略表:source scope、本地证据 ID、provider/endpoint、storage preference、tool permissions、retention policy、log policy、effective account control、用户确认时间、撤销状态。Policy Gate 在发请求前校验这些条件,并把“缺乏官方保证”的字段真实传给 UI 显示。这些设计对个人本地知识库、企业 RAG、AI 笔记、代码助手和法律文档产品都长期有效,远比追踪某个模型小版本更新更有建设价值。
BYOK 数据流验收矩阵:判断是否真的“数据不出设备”
给用户承诺隐私之前,产品团队应至少对四种模式完成相同口径的资料流向核查。设备直连:用户 Key 需要在系统凭据设施保存,提示词与经授权的文档片段直接发送给模型供应商;应用开发者的后端理论上不经手内容,但需要验证遥测或额外同步路径。应用后端代理:客户端到开发商再到模型供应商,开发商具备接触请求正文和凭据的技术机会,必须定义日志、审计、备份、密钥生命周期。用户自托管网关:数据发往用户指定的服务端,仍须识别网关是否转发第三方、是否留存请求及谁有管理员权限。本地推理:模型可以不发生云端请求,但仍要检查独立的联网搜索、崩溃上报、云同步和远程 Embedding 是否开启。
四种模式对“密钥由谁保管、请求最终去哪里、哪方能读取上下文、日志是否启用、第三方工具是否允许、删除需要几步”必须逐项给出答案,不能只返回一个笼统的“安全/不安全”图标。尤其是云端请求中只包含三个 Chunk,也不等于内容不敏感:一个 Chunk 可能包含身份证号、商业合同条款或跨租户资料。正确的流程是先按身份与知识空间过滤,再由用户明确授权特定云端模型与出站范围,组装 Prompt 后记录脱敏的证据 ID 与目标域名。
可以用合成文档实现不触碰用户隐私的验收:写入一个不会出现在正常业务里的唯一测试标记,在本地模式禁用搜索/同步后核对设备出站请求是否包含该标记;在授权云端模式核对实际发送的 Chunk 是否与预期一致;撤销 Key、删除一份资料后验证后续请求不再使用该 Key 或资料。此举只能证明被测试的版本、请求路径和网络观察窗口内的行为,无法证明模型供应商所有内部日志、备份或受法律约束的数据保留均已清零。因此本文把验收清单作为工程标准,而不是冒称完成 RecalAI 真机认证。
与已有 BYOK 产品相比,应该证明什么。 市面上已有客户端把“设备直连模型供应商、不经过开发商代理、Key 保存于本机 Keychain”作为主要卖点,例如 Byokey 官方产品说明这样描述其网络路径;这属于该产品自己的公开承诺,并不等于 XBSTACK 完成了独立网络审计。另一些跨设备密钥管理工具允许经用户选择的云端保险库或代理转发,请求路径因此不同。单纯重复“自填 Key 更安全”“本地存储密钥”已经不足以成为区别于现有内容的新文章,本文需要回答更难的问题:用户能否知道本地检索的哪段资料真的离开设备、服务端是否能读取并记录请求、远端供应商仍可能保留什么,以及删除和撤销的每一步由谁完成。只有这些问题具有可执行的验收办法,BYOK 与 OpenAI ZDR 的站内旧文才有独立编辑价值。
选型结论:三个“隐私优先”不是一个东西
本地 AI 优先解决上下文不必离开终端的问题,但不自动关闭同步、遥测和联网搜索。BYOK 优先解决用户对供应商凭据和模型费用的控制问题,但不自动授予用户供应商 ZDR 权限,也不保证应用自己没做中转。云端 ZDR/受控留存 属于特定组织与端点的保留治理,需要资格、协议、设置和工具边界逐项符合。长期产品若要真正获得用户信任,就必须把这三者分别实现、分别验收、分别解释,尤其不要把“没有使用用户数据训练模型”“不会生成应用日志”“请求完全不出设备”混成同一个承诺。
本文为 2026 年 10 月 27 日的公开资料与工程架构研究,XBSTACK 没有在真实 RecalAI App 上进行密钥泄漏、抓包、第三方日志清理与云端账号保留期的独立验收。因此这里提出的是可操作的验证标准,不是对某个已上架 App 的完成声明。真正的下一步是把数据流图、项目配置与脱敏网络实验固定下来,允许每一种运行模式给出可以被复核的隐私行为。
FAQ
用户自己填 API Key,App 运营方就看不到内容吗? 只有直连供应商且没有其他同步/遥测/代理泄漏路径时,应用运营方才可能不接收原始问答。是否经过代理必须以真实网络架构为准。
Gemini 在 2026 年 10 月 26 日之后是不是所有请求都强制留存? 不是。变化针对新项目的 Generate Content 默认设置,已有项目保留旧默认,且项目管理员和部分单请求配置可调整;其他日志和保留规则仍须分别核查。
OpenAI 设置 store=false 是不是等于全系统 ZDR? 不是。它不能替代组织级 ZDR 授权,也不约束应用自己的数据库、远程 MCP 及其他第三方或独立状态存储。
云端 AI 能否只收到本地检索出的三个 Chunk? 可以按产品设计控制上传范围,但前提是应用能够在调用前准确过滤授权空间、选择证据并审计最终请求,而非只在界面上显示“仅上传必要信息”。
删除本地资料能否同时删除所有供应商的日志? 不能承诺。不同 endpoint、项目、数据集、工具与备份都有独立保留和删除能力,必须逐层说明。
一手来源与站内关联
下一步:把执行边界补完整
完整专题路径 →继续处理下一层权限、工具、凭据或生产控制,不让问题停在“模型回答正确”这一层。
参与讨论
问题、验证与勘误
登录后可发表评论。所有新评论先进入审核;审核期间仅评论者本人和管理员可见,通过后才公开。