个人网站文章越来越多,为什么还是没有流量?一次 592 URL 的真实复盘
网站文章越写越多却没有搜索流量?XBSTACK 复盘 592 个 Sitemap URL、6 个孤立页面、Google 已抓取与未收录状态,用真实构建和公网回执解释为什么发文不等于被发现、被索引或产生点击。
Evidence 5 条资料来源
本文目录
个人网站文章越来越多,为什么还是没有流量?一次 592 URL 的真实复盘
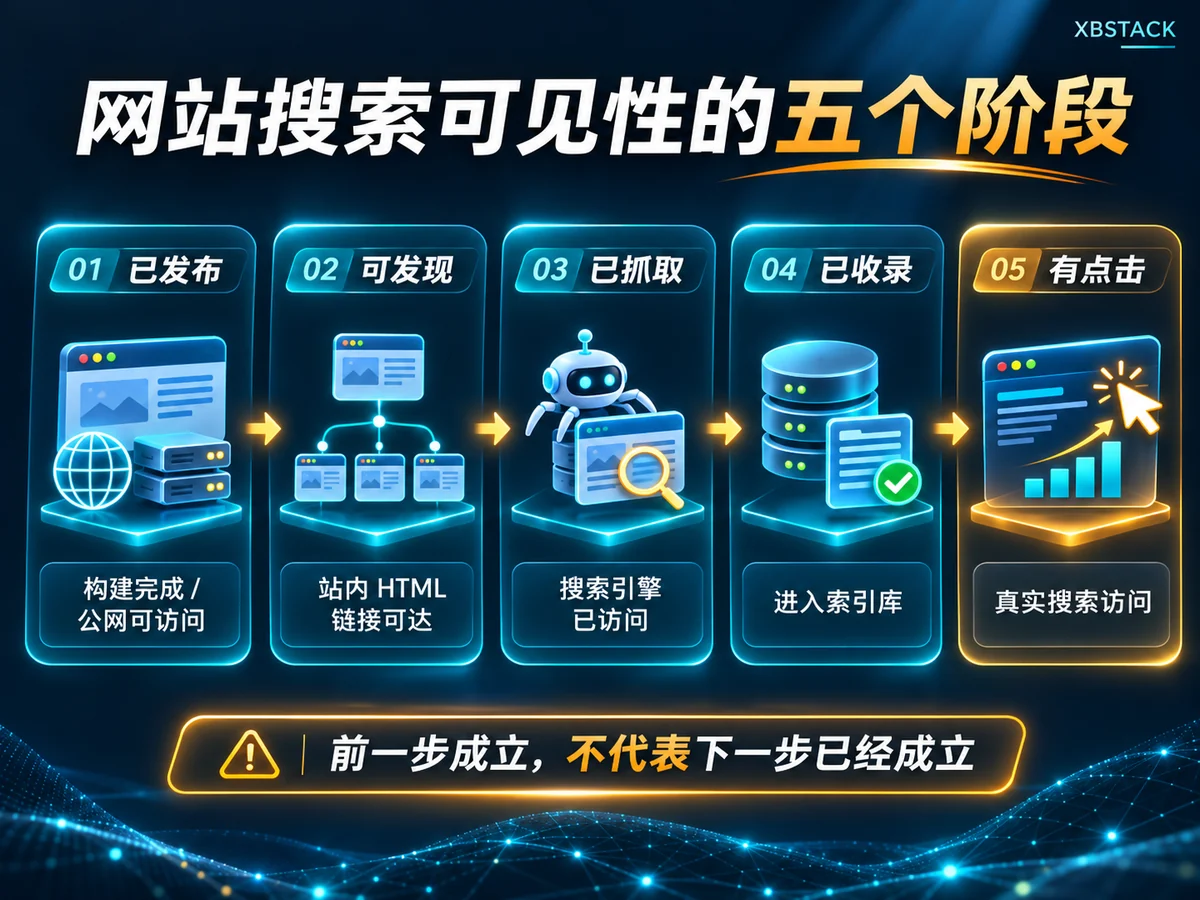
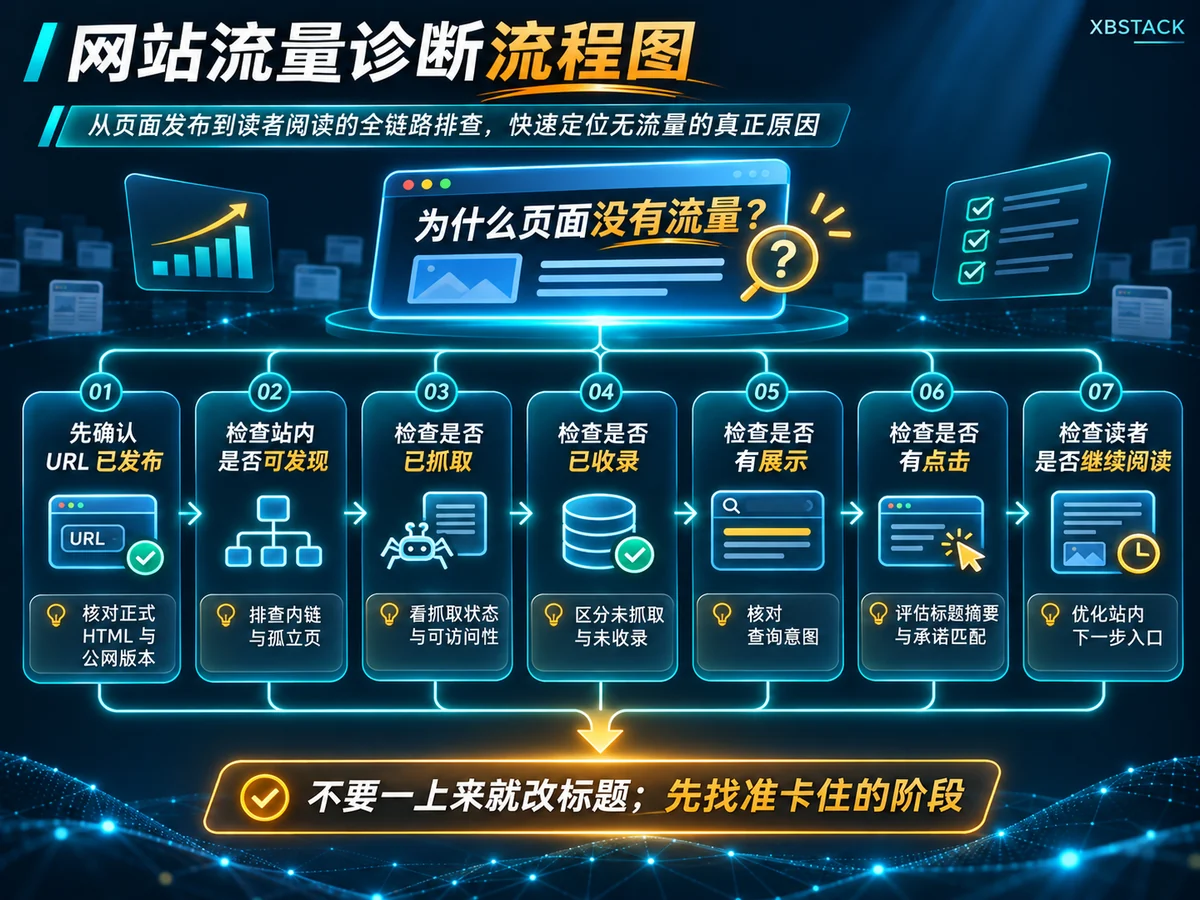
网站文章多却没流量,应该先检查什么? 网站更新了大半年,文章、工具、专题页越来越多。每天打开统计后台,看到的可能还是少量搜索展示、几乎没有点击。站长最容易做的,是再写一篇、再改一个标题、再把 Sitemap 提交一遍。但一个页面被发布、能从首页找到、被搜索引擎抓取、被收录,以及真正有人点击,是五件不同的事。
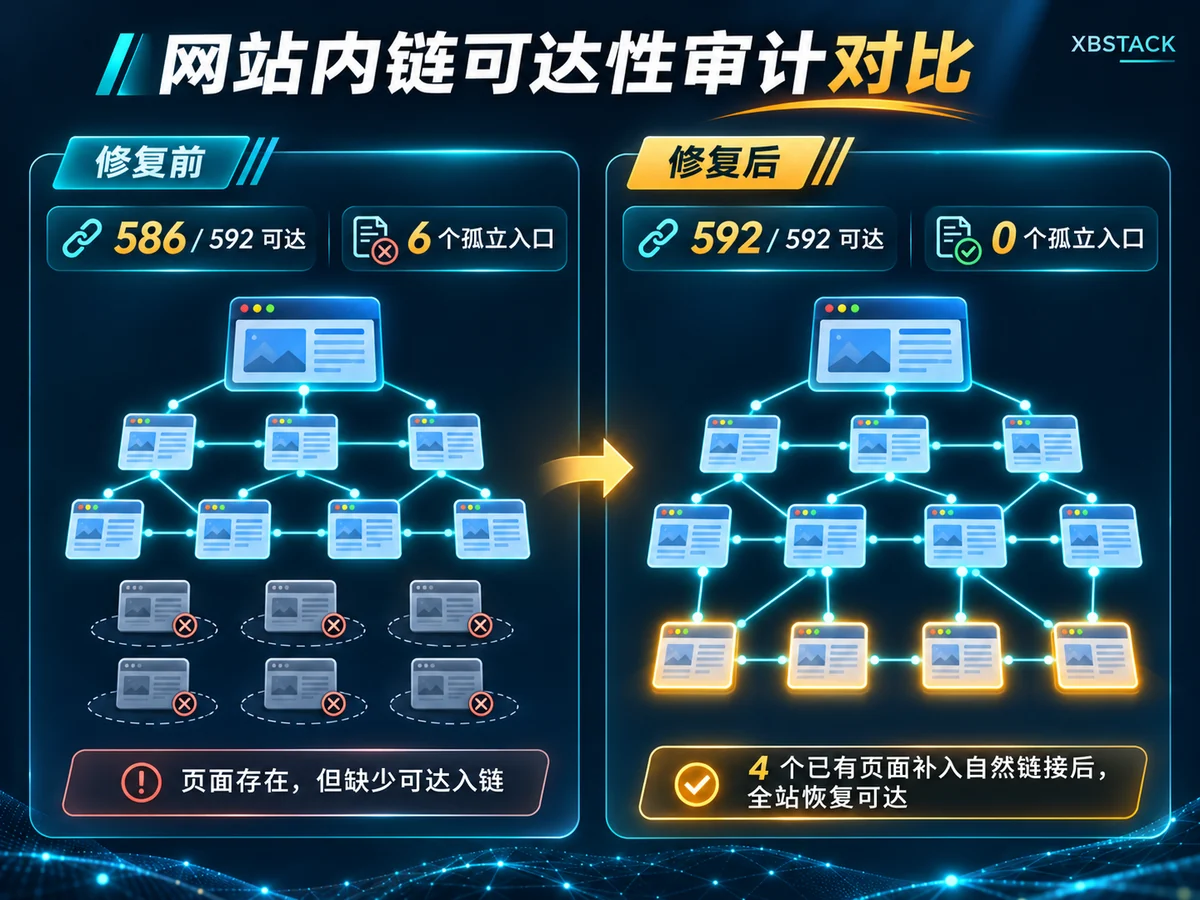
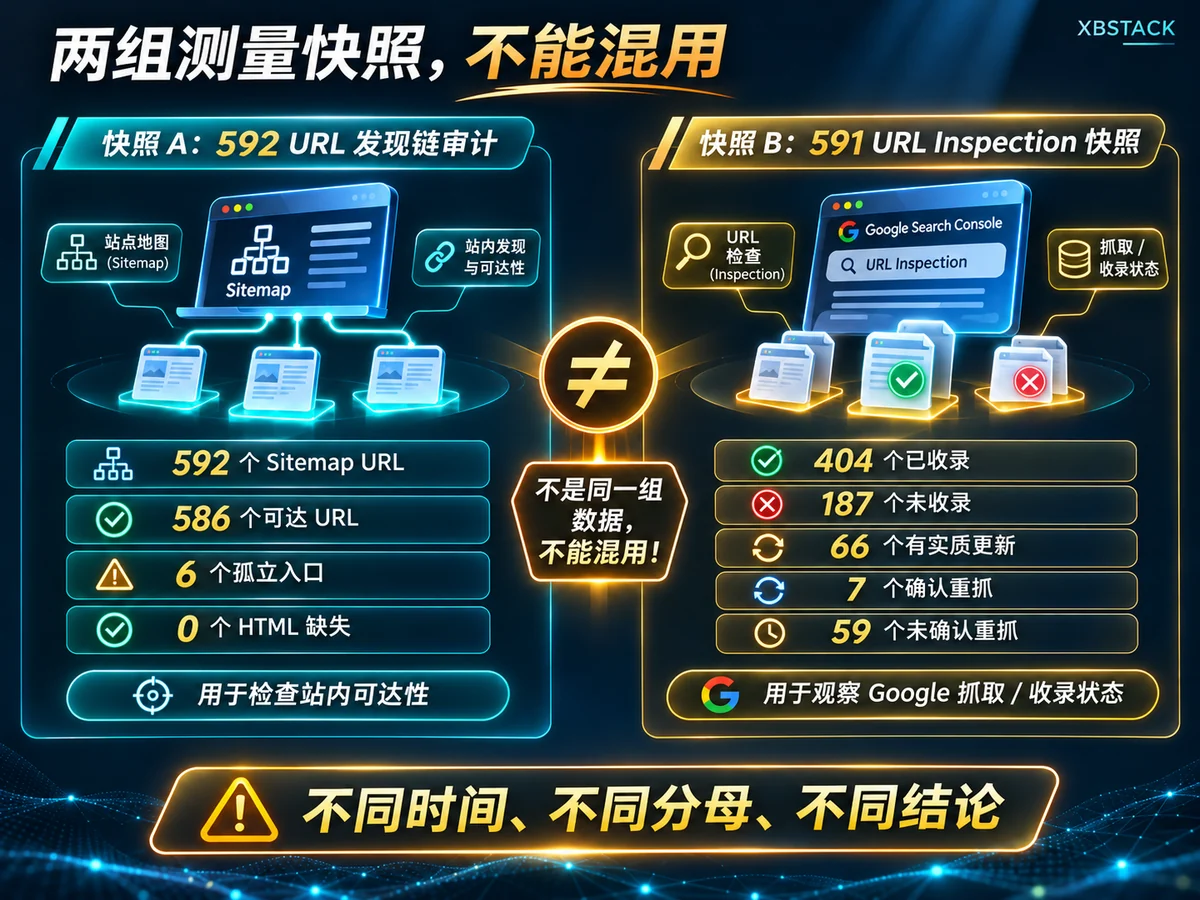
我最近维护 XBSTACK 时就遇到了这样的错觉。2026 年 11 月 11 日,正式发布的 Sitemap 已有 592 个 URL。如果只看构建成功和 Sitemap 数量,很容易觉得站点内容体系已经完整。但第一次沿网站真实链接检查,只有 586 个 URL 可达,其余 6 个 URL 虽然文件存在、也在 Sitemap 中,却没有正常的站内入口。修完这些问题,592/592 才全部能够沿 HTML 链接抵达。
这篇不是一篇“SEO 秘诀”,也不把 592 当作流量结果。它记录我的检查顺序、用到的脚本、具体的六个问题,以及我为什么没有因此宣称 Google 已重新抓取或全部收录。原先关于“160 篇内容越写越乱”的编辑反思,留在旧的内容质量审计日志里;这里专门回答如何查证一份 Sitemap 背后的真实发现链。
先把“网站没流量”分成五种不同的故障
| 你看到的情况 | 需要先核对什么 | 不应立刻做什么 |
|---|---|---|
| URL 已发布但站内找不到 | 正式构建的 HTML、首页及专题页的普通链接 | 不要先批量改标题 |
| Sitemap 存在但 Google 尚未抓取 | URL Inspection 状态、robots、可抓取链接、响应状态 | 不要反复提交同一份 Sitemap |
| Google 已抓取但未收录 | Canonical、内容独立价值、重复页、页面状态 | 不要把所有未收录都归因于“抓取预算” |
| 有展示/排名却没有点击 | 查询意图、搜索结果标题摘要、首屏承诺 | 不要仅凭一次 0 点击就改 H1 |
| 有点击但读者离开 | 文章能否回答问题、站内下一步和实际产品/资料入口 | 不要把原始 GA4 Sessions 当作有效自然流量 |
这一步很重要。否则你可能在修“网站没流量”时,持续改变一个已经能被发现、真正卡在内容价值或搜索意图上的页面。Google 的官方说明也明确:Sitemap 帮助发现 URL,却不保证抓取和索引。
实测快照:592、586、6,到底分别指什么?
| 指标 | 2026-11-11 修复前 | 修复后 |
|---|---|---|
| 正式 Sitemap URL | 592 | 592 |
| 从中英文首页沿 HTML 链接可达的 Sitemap URL | 586 | 592 |
| 历史孤立 URL | 6 | 0 |
| Sitemap 对应 HTML 文件缺失 | 0 | 0 |
| 本轮实际改变的已有 HTML 页面 | — | 4 |
这里的 592 是 URL,不是 592 篇文章。XBSTACK Sitemap 中不仅有文章,也有专题、工具、产品和其他公开页面。“可达”也只表示站内 HTML 链接图有路径,不是 Googlebot 的真实抓取记录。初始检查和修复后检查均针对部署产物的普通 HTML,随后又做了公网版本的独立核验。
六个问题入口是:
/guides/:中文专题指南入口;/en/guides/:英文专题指南入口;/guides/ai-agents/:旧的 Agent 学习路径;/guides/self-hosted/:旧的自托管学习路径;/lens/:旧 Lens 记录入口;/zh-tw/products/lunest/:繁体中文 Lunest 产品介绍。
这些 URL 的共同点不是 404,而是站内链路不完整。页面文件还在,Sitemap 也列出了它们,只是普通读者从首页一路点击未必能走到。这里还要区分“整个 HTML 图上存在链接”和“实际页面对读者有价值”:通过机器审计只解决前一个问题,后一个问题仍由内容编辑判断。
如何复现:从 Sitemap 校验走到 HTML 链接图
我没有用 site: 查询估算文章数量,也没有把生成源码里的 Markdown 链接当作用户真正可点击的 HTML。项目里的审计脚本是:
scripts/audit-discovery-coverage.py
站在仓库根目录,对已有的公开静态发布仓做一次只读检查:
python3 scripts/audit-discovery-coverage.py \
  --root deploy \
  --baseline deploy \
  --report reports/search-notification/discovery-coverage-latest.json
发布前对尚未上线的不可变静态快照,应把 --root 改为新产物根目录、--baseline 保留正式已部署目录。不建议在构建未完成时对中途写入的 dist 反复测试,否则会读到不同时间点的文件。
脚本做了这些事:
- 从
sitemap-0.xml读取每个<loc>,拒绝不属于本站、格式错误或重复的 URL; - 找到每个 URL 对应的
index.html,明确区分“HTML 文件缺失”和“页面有文件却没有站内入链”; - 以
/和/en/为起点,用广度优先搜索(BFS)解析静态 HTML 中具有真实href属性的锚点标签,标准化本站相对路径,并排除nofollow、锚点、邮件和站外链接; - 计算
Sitemap URLs - BFS 已访问 URL,再找没有入链的页面;相比发布前的既有基线,分别判断新 URL 孤立、已有 URL 失去可达性、旧的已知孤立债务; - 发现 Sitemap 目标 HTML 丢失、新增孤立 URL 或历史页面丢失可达性时阻止发布;已知历史孤立问题单独警告,不能借机删除旧页。
这段方法有明显边界:它是静态已渲染 HTML 的内部链接图审计,不执行浏览器 JavaScript,不代表 Googlebot 的完整渲染行为;它可以证明在该静态快照内存在入链,但不能证明页面相关性、抓取频率、索引资格、外部反向链接质量或实际排名。Google 建议使用带真实 href 的可抓取链接,原因也在这里。
修复为什么只动四个页面,而不是改导航或创建六个新 URL?
看着“6 个孤立页面”,直觉是把它们全塞进主导航。但导航不是为机器指标服务的;如果一个栏目不再承担一级入口职责,强行增加菜单会让用户更难理解网站。我采用的办法是把有意义的链接放回相关正文:
| 编辑位置 | 实际新增的读者路径 |
|---|---|
| 中文建站复盘正文 | /guides/、/guides/ai-agents/、/guides/self-hosted/ |
| 英文建站复盘正文 | /en/guides/ |
| Life 现场记录 | /lens/ |
| Lunest 产品页 | /zh-tw/products/lunest/ |
四处已有页面的正文变化让六个旧入口重新接入发现链。既没有更换六个 URL 的 Canonical,也没有用无关的“SEO 友情链接区”硬堆入口。完成后再次运行全站审计,回执给出 592/592 reachable、0 noInbound、0 missing HTML。
这也是我认为个人网站最值得坚持的一条运营原则:先问读者为什么会从当前页面走向下一页,再决定要不要加链接。 搜索引擎可发现性是附带的工程收益,而不应成为牺牲导航可读性的理由。
Git Push 成功,怎么证明 Cloudflare 真正已经发布?
另一个之前容易犯的错误,是把 git push 成功看成公网更新成功。实际链路还包括构建产物、部署平台处理、CDN 生效与缓存。
XBSTACK 当前先冻结通过门禁的静态产物,只对真实变化范围发布,再独立检查线上版本:
python3 scripts/verify-public-deployment.py \
  --before 06d356fea4044e39c34c4e97a6c43fa8765c62bd \
  --after c2bf06bc17e45c6705b89926e3eef5b603d66d8f
2026 年 11 月 11 日这次发布的核验回执显示:4 个改动路由全部匹配、共检查 11 个页面、Sitemap 592 URL 一致、状态 PASS。检查对象包括实际公网 HTML 的规范化内容指纹、Title/Canonical 与完整 Sitemap;它不是简单只看 HTTP 200。只有公网验证成功后,系统才发出本次真正变更 URL 的搜索通知。
本轮 IndexNow 接受 4 个 URL(HTTP 200),Google Sitemap 提交成功。这意味着通知步骤有了正式回执,并不等于 Bing 或 Google 已经抓取这四页。尤其 Google 的 URL Inspection 状态不能用 IndexNow 的接口结果来替代。
另一个分母:591 个 URL 的 Google Inspection 为什么只有 404 个收录?
同一天较早的 另一次 Google Search Console URL Inspection 快照,用的是591 个 URL 的 Sitemap 版本,结果如下:
| 该次 Inspection 指标 | 结果 |
|---|---|
| 已核验 URL | 591 |
| Google 确认已收录 | 404 |
| Google 确认未收录 | 187 |
| 有明确实质更新证据的 URL | 66 |
| 确认更新后已重抓 | 7 |
| 没有确认更新后已重抓 | 59 |
不能把 404/591 写成 404/592;也不能把 187 个全部解释为“站内孤立页”。 它们是不同时间的不同快照,状态归类各不相同。有的页面属于“已发现尚未抓取”,有的被抓取但尚未编入索引,还有的 URL 目前对 Google 来说未知。URL Inspection 的 lastCrawlTime 也只是最后已知抓取时间,并非每分钟更新的服务器日志。
专业排查可以按这样的分流处理:
- Discovered – currently not indexed(已发现未抓取):先核对可抓取链接、robots、网站可访问性和内容是否长期有独立意义;不把一次未抓取归结为 Crawl Budget。
- Crawled – currently not indexed(已抓取未索引):确认实际 HTML 的 Canonical、重复意图、文章是否真正回答用户问题,再决定是更新、合并还是保持观察。
- 更新后没有确认重抓:核对内容真实修改、Sitemap
lastmod对应的编辑证据,以及当前观察窗口;不要每天无变化地刷新日期或反复提交。 - 已有展示而没有点击:换到 GSC 查询词与读者意图问题,先区分样本不足、标题摘要不匹配和页面实际任务不一致;不要为了 CTR 随意改 slug。
官方也提醒:抓取与索引需要时间,提交和请求不构成保证。对常见的状态误区,还可以参考 Google 抓取与索引 FAQ。
为什么我没有立刻改几十篇旧文章标题?
在一份截至 2026 年 11 月 7 日的完整 GSC 分析窗口中,XBSTACK 的 AI 财报指南曾出现 48 次展示、平均排名约 7.92、0 次点击。这听起来像“标题吸引力差”,但同一份报告里有效可用的查询词是零。没有看到真实搜索问题、国家/设备分布、日期趋势与足够的点击样本,无法证明是标题本身出了问题。
我更倾向于先核对用户进入这个页面时究竟想做什么,再把问题与现有内容、工具入口、站内阅读路径对应起来。相关的点击问题,我已经放在另一篇Search Console 有曝光没点击的复盘中;本文不重复讲“怎样写一个更吸引眼球的标题”。
如果你也在经营一个个人网站,可以先做这份检查
我建议从最便宜、最可验证的地方开始,不必先装一大套 SEO 工具:
- 数 URL,不数情绪:导出 Sitemap,区分文章、专题、工具与产品;记录快照日期,不能把不同发布日期的数字混用。
- 数真实入口:从中文/英文首页遍历已渲染的 HTML 链接;区分“缺 HTML”“缺入链”“链接指向旧路径”。
- 修用户真的会走的路径:在专题、正文、产品说明中补上下文相关链接;不要为提升覆盖率往菜单塞不相关链接。
- 验证部署:拿发布前后 HTML 内容指纹和 Canonical 与公网比对,不只相信本地构建或 Git Push。
- 观察搜索链条:URL Inspection 区分发现、抓取、收录;GSC Performance 再看展示、真实点击和可见查询;最后评估读者回访和产品转化。每一步都单独留日期和证据。
这次真正解决的只是一个明确问题:六个有文件、有 Sitemap 记录,却缺少正常站内 HTML 入链的旧页面。 它把网站发布流程的一个盲点补上了,不能直接把 592/592 可达写成“SEO 增长 100%”。Google 后续重新抓取、是否索引以及能否带来有效访问,还需要继续按真实日期观察。
个人网站最值钱的不是哪一天突然多了几十个 URL,而是几年之后,一个读者仍然可以沿着清晰的路径找到准确、更新过、知道边界的答案。对我而言,这才是 XBSTACK 值得持续建设的原因。
相关资料与继续阅读
- 内容质量审计:160 篇阶段的个人建站反思——回答为什么不能只堆内容,而不是重复本文脚本和发布核验步骤。
- Web Builder Log 专题——Astro、Cloudflare、网站架构与搜索问题的长期记录。
- Search Console 有曝光没点击怎么办——搜索结果层面的 CTR 与意图排查。
- 404 暴增:外链路径与旧 URL 修复——真实 404 与本文“文件存在但无可达入链”是两个问题。
- Google 官方 Sitemap 说明 / 可抓取链接规范 / 抓取故障排查。
数据时间说明:文中的 592 URL 发现链、591 URL Inspection、四页面发布以及 IndexNow 回执均来自 2026 年 11 月 11 日不同阶段的实际检查,不代表现在或未来任何时刻全站索引状态。配图为 GPT 制作的概念示意,并非 Google 后台截图。
下一步:继续搭建 Agent 系统
完整专题路径 →沿着架构、工具、Memory、评测、安全或生产治理继续推进,不必重新从头找资料。
参与讨论
问题、验证与勘误
登录后可发表评论。所有新评论先进入审核;审核期间仅评论者本人和管理员可见,通过后才公开。