小白 / Xiaobai
开发者 · 产品构建者
持续构建 AI 工程系统、开发者工具与长期数字资产。
关于作者与 XBSTACK →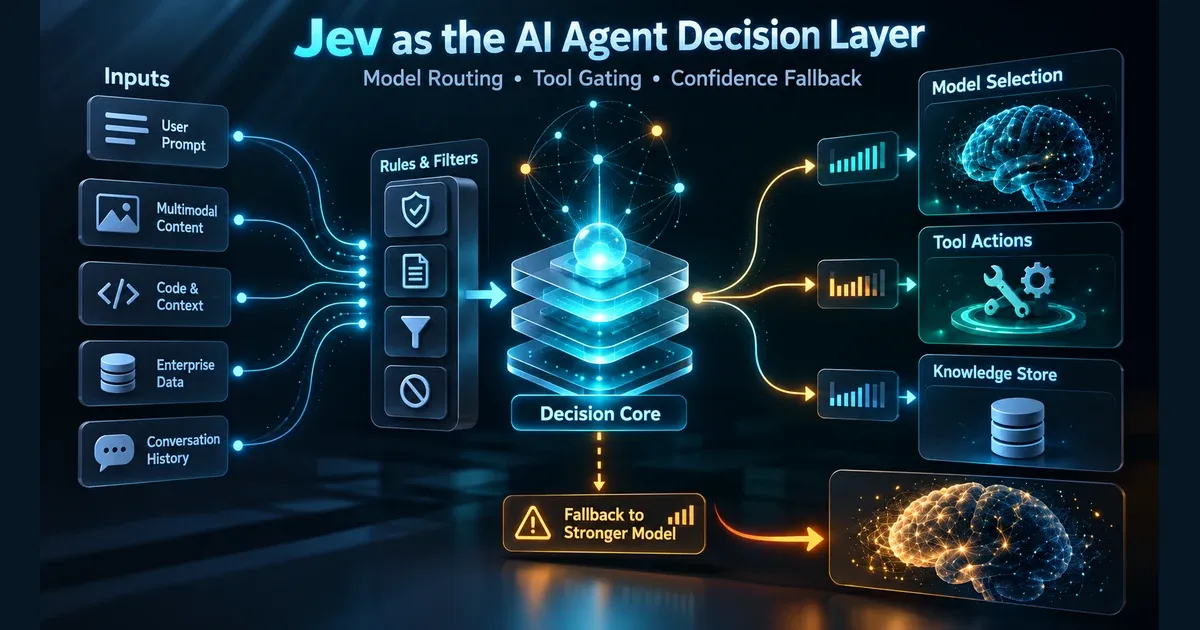
Jev 能不能成为 AI Agent 的决策层?模型路由、Tool Gate 与置信度回退怎么设计
Jev 是 TypeSafe AI 于 2026 年 9 月 15 日发布的 System One 决策模型。本文不把官方宣传写成 XBSTACK 实测,而是结合官方 API、Microsoft Agent Framework 集成讨论与独立 benchmark,判断 Jev 在模型路由、Tool Gate、风险分级、置信度回退中的真实工程位置。
直接答案:Jev 值得 AI Agent 开发者认真看,但现在最危险的误解,是把它理解成“更快、更便宜的小 LLM”。它真正想做的是另一件事:把 Agent 循环里大量“只需要做判断、不需要写一段话”的步骤,从生成模型里拆出来,变成一个返回有限选项、评分或 yes/no 概率的 Decision Layer。
这类任务非常多:这条请求该走便宜模型还是强模型?这个 Tool Call 是只读、破坏性还是需要人工审批?当前任务应该继续循环、结束还是升级?哪个技能更匹配?哪些 RAG 候选值得继续送进生成模型?过去我们经常用一整次 LLM completion 来做这些事,再解析 JSON、检查 schema、处理模型输出跑偏。Jev 的产品假设是:如果最终只需要一个结构化决策,就不应该强迫模型先生成一段自然语言。
但这并不等于“Jev 已经证明可以替代 LLM”。截至 2026 年 9 月 25 日,公开证据其实给出了更有意思、也更克制的答案:在一组 Agent Tool-Call 风险分类实验里,Jev 和 Claude Sonnet 5 得到了完全相同的 55/60;Jev 的延迟和成本更低,但另一组 LLM routing 实验又发现,路由收益主要来自检索证据,拿掉 Jev 后结果几乎没变。也就是说,Jev 的机会是真实的,但最合理的位置可能不是“万能 AI 路由器”,而是规则系统与生成式 LLM 之间的一层窄而快的概率决策器。
这篇文章不是 XBSTACK 的 Jev 实测。本机目前没有配置 TYPESAFE_API_KEY,所以我不会把 TypeSafe 的官方数字、第三方 GitHub 项目或社区测试写成自己的结果。本文只做三件事:核对 Jev 到底是什么;把目前可复核的独立证据放到一起;给出一个值得下一步真实测试的 Agent 控制面架构。
Jev 真正改变的不是“模型大小”,而是 AI 在软件里的接口
TypeSafe AI 在 2026 年 9 月 15 日正式发布 Jev,并把它称为第一个公开的 System One Model。官方给出的核心接口非常直接:软件提供一段 state,再提供预先定义的问题,模型返回类型固定的判断,而不是一串开放文本。
当前 API 文档公开了三类核心答案:
- Choice:从你定义的候选项里选一个,并给出概率分布;
- Score:按你定义的有序尺度评分;
- Noul:回答 yes/no 方向的概率判断。
这和 LLM 的 JSON mode、function calling、structured output 看起来相似,但工程上的出发点不同。传统 LLM 仍然在做生成,只是通过 schema 把输出限制在一个结构里;Jev 从产品设计上就把“决策”当成目标,不要求先生成解释文本。TypeSafe 官方把它概括为“unstructured state in, typed probabilistic decisions out”。
官方 API 当前要求 Bearer API Key,核心请求入口为 POST /v1/systemone。官网公开价格是 每百万输入 token 0.042 美元,输出不单独计费。这些数字可以说明它的目标是高频、低成本决策,但不能直接推出“你的 Agent 会便宜多少”,因为真正成本还取决于调用频率、输入 state 大小、是否需要 fallback,以及错误路由造成的下游成本。
官方发布:https://typesafe.ai/blog/introducing-system-one-models-and-jev
API 文档:https://api.typesafe.ai/docs
还有一个需要特别拆开的宣传词:TypeSafe 会强调 Jev 的 typed output 和“zero hallucinations”。对工程师来说,更准确的理解应该是:它不会生成 schema 之外的自由文本,不代表它不会在 schema 内选错答案。 如果四个候选都是合法值,模型选错其中一个,类型仍然完全正确,但业务判断依旧错误。Agent 系统真正需要测的,是 decision accuracy、calibration、错误代价和 fallback,而不是只看“输出是不是合法”。
为什么 AI Agent 确实需要一个独立 Decision Layer
一个生产 Agent 的执行链里,真正需要“大模型写东西”的步骤并没有想象中那么多。
用户请求
  ↓
权限/能力硬过滤
  ↓
任务难度判断
  ↓
模型路由
  ↓
Planner / 生成
  ↓
Tool 候选
  ↓
风险判断与审批
  ↓
执行
  ↓
结果是否足够 / 是否重试
  ↓
结束、升级或人工接管
这里至少有五六个节点,本质都是“从有限集合里做选择”。如果每一个节点都调用一次生成式 LLM,系统会出现几个很现实的问题。
第一,延迟会累加。Agent 本来就会多轮循环,路由、判断、评审又各做一次 completion,很容易把端到端时延放大。
第二,JSON 合法不等于判断稳定。你可以让 LLM 输出 risk=high,但仍需要处理理由文本、字段兼容、模型版本变化和 prompt 漂移。
第三,成本集中在大量小判断上。真正昂贵的不一定是最后那一次复杂推理,而是每一轮前后都调用一个并不需要生成能力的模型。
第四,置信度很难成为一等接口。很多 LLM 工作流会让模型自己“报一个 confidence”,但这个数字往往没有经过任务级校准。Jev 至少从接口设计上把概率作为输出的一部分,让开发者有机会真正建立阈值、回退和人工复核策略。
这也是为什么 Microsoft Agent Framework 最近的社区讨论值得注意。相关 Feature Issue 没有简单提议“加一个新的 Chat Provider”,而是提出独立的 decision-client abstraction,专门服务 routing、tool gating、workflow edges 和 loop evaluation。即使这个提案最终是否进入框架还没有定论,它反映了一个合理的架构趋势:决策模型和聊天/生成模型可能应该是两个不同接口。
相关讨论:https://github.com/microsoft/agent-framework/issues/8556
外部证据一:Tool Gate 场景里,Jev 的确像一个可用控制面组件
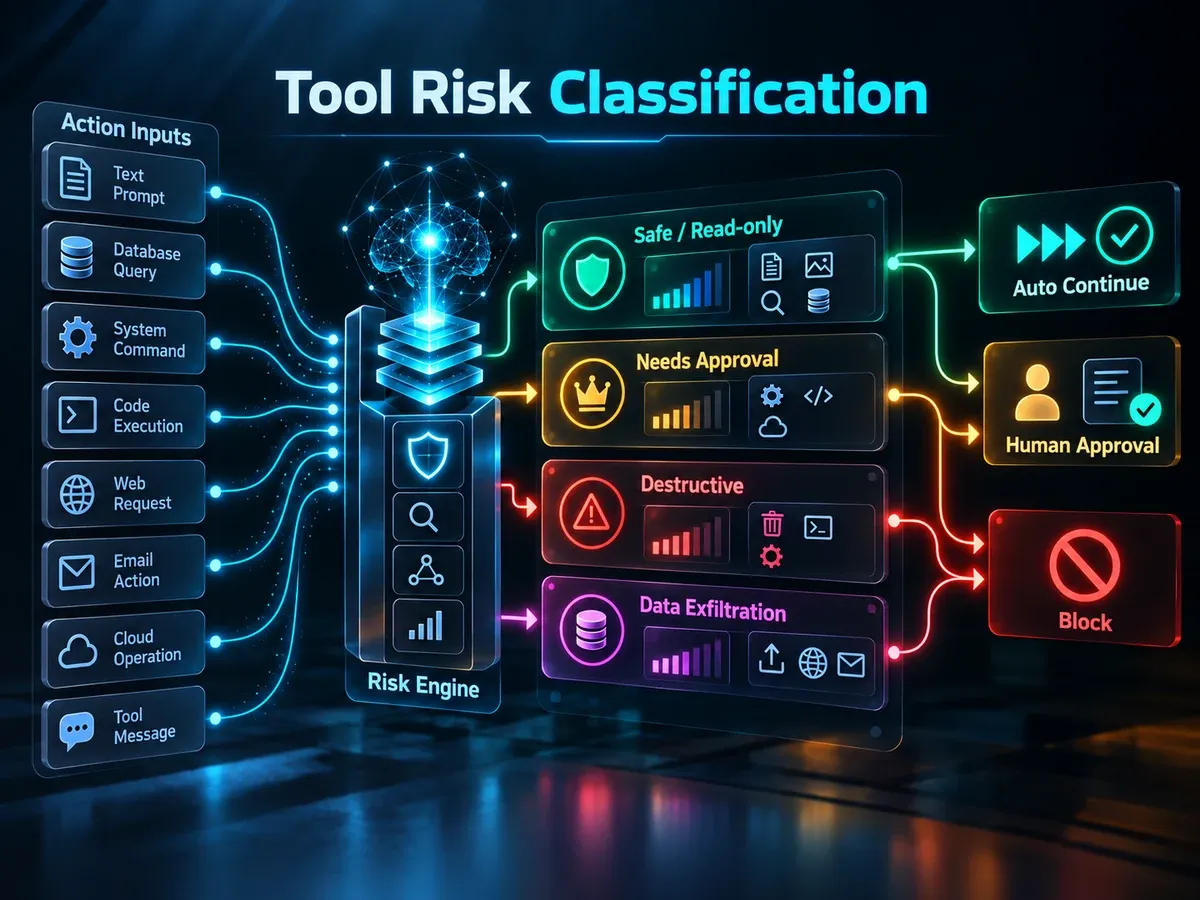
目前最值得参考的一组独立实验,不是情感分类,而是 Agent Tool-Call 风险判断。
themsquared/jev-benchmark 发布了一套可复现 fixture:60 条人工标注工具调用,分成 readonly、destructive、privileged、exfiltration 四类,其中包含 34 条 clear、14 条 ambiguous、12 条 adversarial 样本。所有后端拿到同一套任务定义,返回同样的 choice + confidence。
| 第三方 60 条 Tool Risk 测试 | Jev latest | Jev preview | Claude Sonnet 5 |
|---|---|---|---|
| Accuracy | 91.7%(55/60) | 91.7%(55/60) | 91.7%(55/60) |
| Clear | 100% | 100% | 100% |
| Ambiguous | 71.4% | 71.4% | 71.4% |
| Adversarial | 91.7% | 91.7% | 91.7% |
| p50 latency | 421.6 ms | 378.5 ms | 1371.0 ms |
| p95 latency | 542.0 ms | 484.3 ms | 2719.1 ms |
| Estimated cost/call | ~$0.0000173 | ~$0.0000173 | ~$0.0007035 |
再次强调:这是该仓库作者在自己的网络、自己的 60 条数据集上得到的结果,不是 XBSTACK 实测,也不能直接外推到所有 Agent。
但这组数据真正有价值的地方,不是“Jev 比 Claude 快几倍”,而是三者在 accuracy 上完全打平。对于一个窄、结构化、标签定义明确的判断任务,昂贵的 frontier LLM 并没有体现出额外准确率优势。这正是 Decision Layer 值得存在的前提:如果任务只需要做一个有限判断,生成能力可能是过度配置。
这组 benchmark 也保留了失败:三个后端在 ambiguous slice 都只有 71.4%。其中还有一条 kubectl port-forward 到生产数据库的样本,人工标签和三个模型的风险理解本身就存在争议。这个细节说明 Tool Gate 的上限不只取决于模型,还取决于风险 taxonomy 是否定义得足够好。
仓库:https://github.com/themsquared/jev-benchmark
外部证据二更重要:Jev 加进 LLM Router,不一定产生增量
如果只看“快、便宜、有概率”,最容易得出的结论就是:那就让 Jev 来做所有模型路由。
但 TokenTrim/jev-routing-experiment 给了一个很重要的反例。
这个项目把 Jev 放进 LLMRouterBench / RouterArena 的模型选择流程。公开结果里,Jev difficulty + retrieval evidence 在一个 13 模型池里可以做到 62.4% accuracy、低于 best-single 的成本;但作者同时做了最关键的 no-Jev ablation:只保留 retrieval evidence,不使用 Jev difficulty signal,结果仍然是 62.4%,成本甚至略低。
换句话说,路由器赢了,但这次不是 Jev 让它赢的。
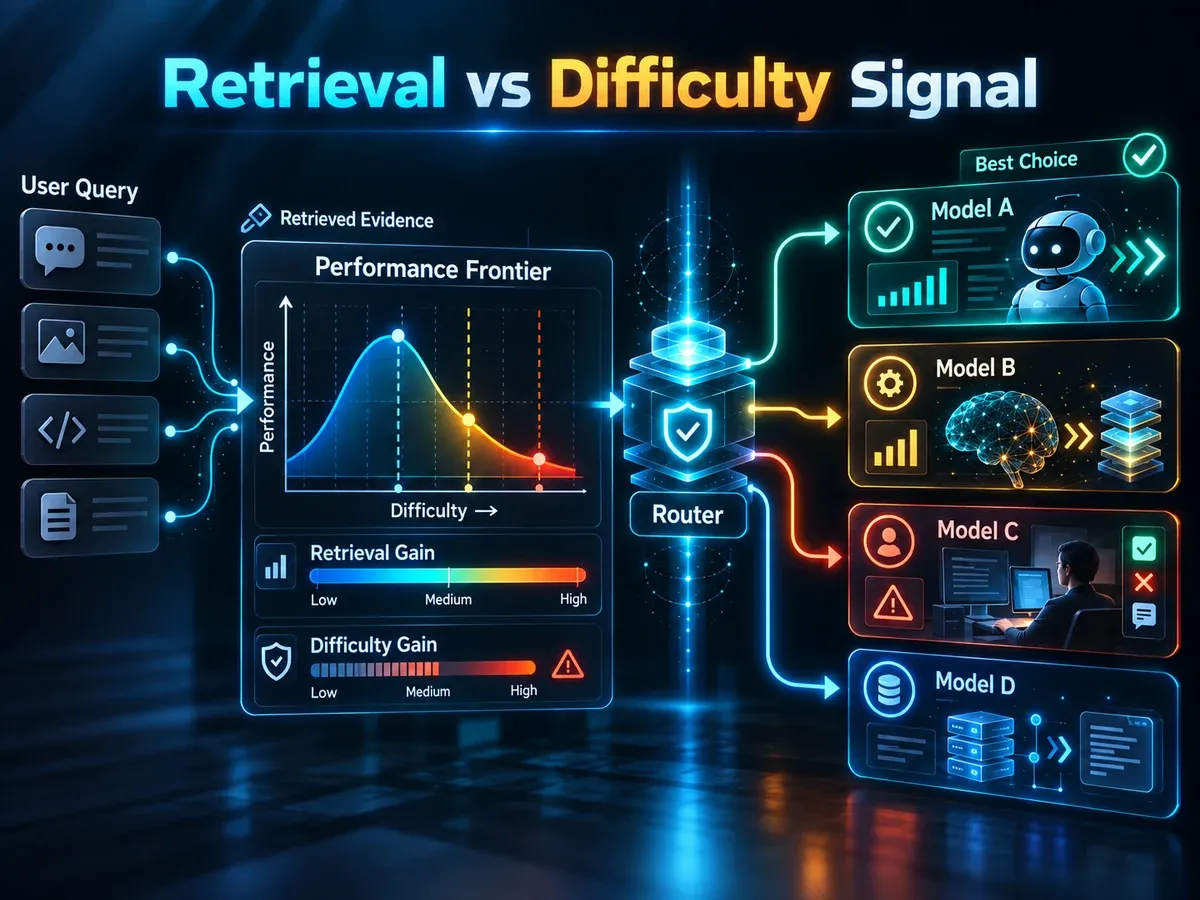
这比一个漂亮的“Jev 比 LLM 快 100 倍”更值得开发者记住。生产路由是组合系统,至少包含 hard capability filter、价格与上下文限制、视觉/工具能力、历史任务结果、相似任务 retrieval、当前任务难度、业务失败成本和 fallback 策略。
如果 retrieval evidence 已经足够预测“哪个模型更可能答对”,再增加一个 difficulty classifier 可能没有增量。反过来,在缺少历史任务数据、候选模型经常变化、规则难以表达时,Jev 才可能更有价值。
所以以后做 Jev routing 实测,必须有 ablation:
Rules only
vs
Rules + retrieval
vs
Rules + Jev
vs
Rules + retrieval + Jev
vs
LLM router
不做这一步,就算最终路由效果提升,也无法知道提升到底来自哪一层。
仓库:https://github.com/TokenTrim/jev-routing-experiment
真正公平的对手不只是 GPT、Claude,而是 classifier
Jev 的市场叙事很容易把比较对象放在 frontier LLM 上,因为价格和延迟差距最明显。但如果任务是分类、路由、打分,那么最应该问的是:
为什么不用传统 classifier、zero-shot NLI、轻量本地模型或规则?
dhruvmehra/jevbench 把比较范围扩展到了六类方案:Jev、开源 System One 模型 Laya、小型 LLM、frontier LLM、fine-tuned DistilBERT,以及 BART-MNLI zero-shot NLI,并使用 SST-2、AG News、Banking77 三类公共数据集。
这个比较框架比“Jev vs Claude 谁便宜”更接近真正的采购决策:
- 标签长期固定、训练数据充足:fine-tuned classifier 值得优先测;
- 标签临时变化、每次 criteria 不同:Jev 这类动态 typed decision model 更有吸引力;
- 判断依赖复杂上下文和隐式世界知识:LLM 仍可能有优势;
- 风险边界能明确写成规则:hard rule 根本不应该交给模型;
- 不能把数据发给云端:本地 classifier 或开源模型优先级更高。
所以 Jev 最有价值的定位不是“替代所有 classifier”,而可能是填补 hard rules 与 full LLM 之间那块动态语义判断区域。
仓库:https://github.com/dhruvmehra/jevbench
对个人 AI、私人 AI 和本地 AI,Jev 的边界反而更重要
如果你在做 Personal AI、私人 AI、私有 AI 或本地 AI Agent,Jev 不是一个可以无条件插进去的组件。它当前是云端 API 型 Decision Layer,这意味着送给 Jev 的 state 仍可能离开本机或私有网络。对个人记忆库、私人文档、医疗/财务资料、设备日志这类敏感上下文,真正的问题不是“Jev 能不能判断”,而是“哪些字段允许离开本地”。
更合理的做法是把个人/私人 AI 的决策拆层:身份、权限、文件范围、敏感字段过滤这类确定性规则留在本地;能够去敏、压缩后的语义状态才考虑交给 Jev;如果系统目标是 全本地 / Self-hosted / 数据不出设备,那 Jev 就不应该处在主决策链里,而应该优先评估本地 classifier、开源小模型或纯规则系统。
这也是为什么 Jev 对 Personal AI 的价值更多是“可选云端决策器”,而不是“私人 AI 默认大脑”。个人 AI 真正长期稳定的底座仍然是本地数据边界、RAG/Memory、权限控制和可替换模型层。相关站内内容可以继续看 2026 全栈生产力装机:本地算力与数据主权 和 OpenClaw vs Hermes:Private AI Stack 与 Agent 架构。
我会怎样把 Jev 放进真实 Agent:Rules → Jev → LLM/Human
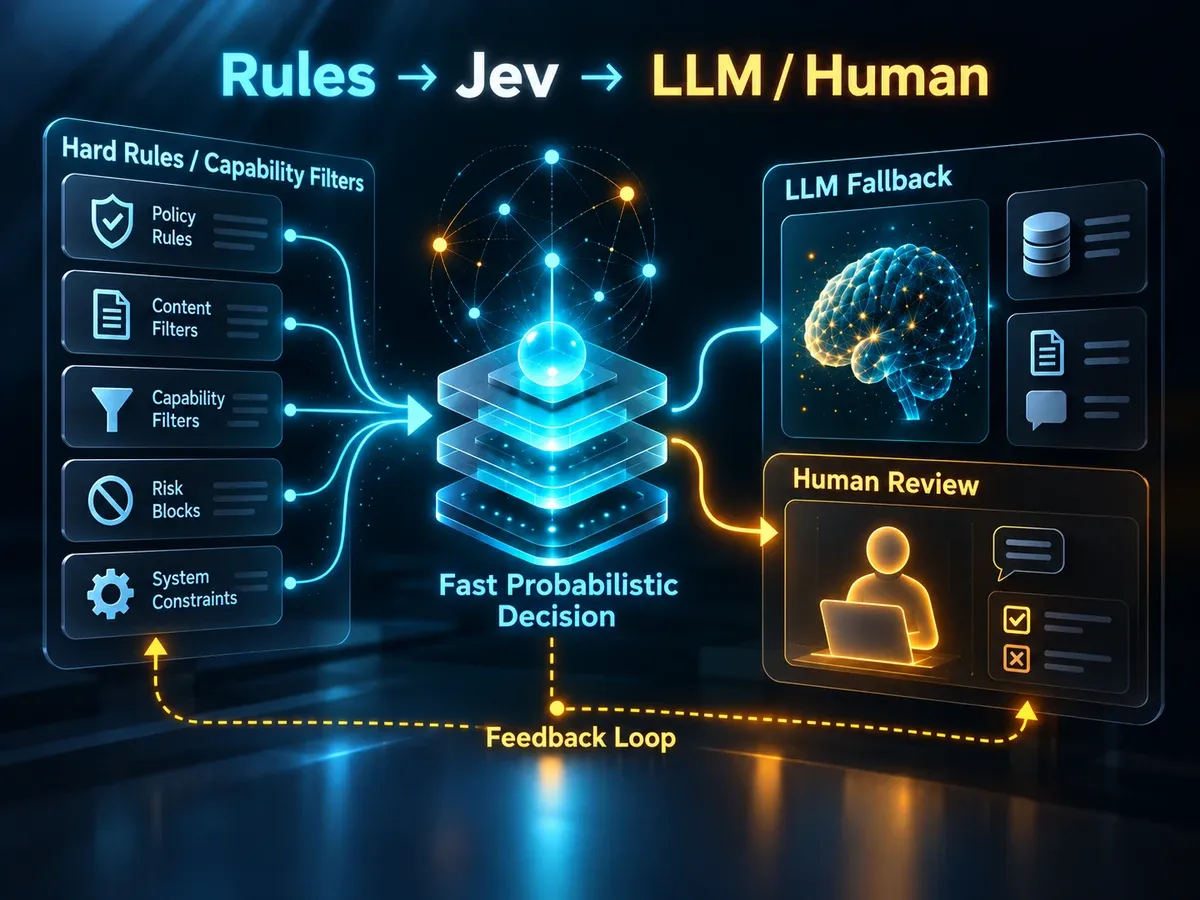
如果后续 XBSTACK 拿到 Jev API Key,我不会从“让 Jev 全权决定 Agent 下一步”开始,而会采用一个三层控制面。
第一层是 Hard Rules / Capability Filter。没有 vision 能力的模型直接排除图片任务;超过 context limit 的候选直接排除;Tool 被 policy 禁止时直接 deny;涉及生产删除、转账、发布等动作直接要求审批;租户没有权限的资源直接拒绝。这类边界确定、后果明确的判断,用概率模型反而是倒退。
第二层才是 Jev Decision Layer。适合放模型难度分级、多个满足硬约束模型中的 tier 选择、Tool Call 语义风险类别、是否需要更强 Reviewer、工单/任务意图路由、候选结果相关性评分、是否进入人工复核、Agent loop 是否很可能已经完成。
第三层是 Fallback / Escalation。
Jev high confidence + low risk
    → 自动继续

Jev medium confidence
    → stronger LLM / secondary classifier

Jev low confidence
    → human review

hard policy hit
    → deny / mandatory approval
这里最重要的一点是:confidence 不是 permission。 即使 Jev 给某个高风险 Tool Call 0.99 的“safe”概率,权限系统仍然应该独立决定它有没有资格执行。模型负责判断,Policy Engine 负责授权,两层不能合并。
这和 XBSTACK 现有 AI Agent 工具授权与 Policy Gate 的原则一致:认证、模型判断、资源级授权和人工审批是不同边界。
Jev 的 confidence 有用,但不能把 0.8 当成万能阈值
Jev 最值得继续验证的,不是 Choice 本身,而是概率输出能不能稳定支撑 fallback。
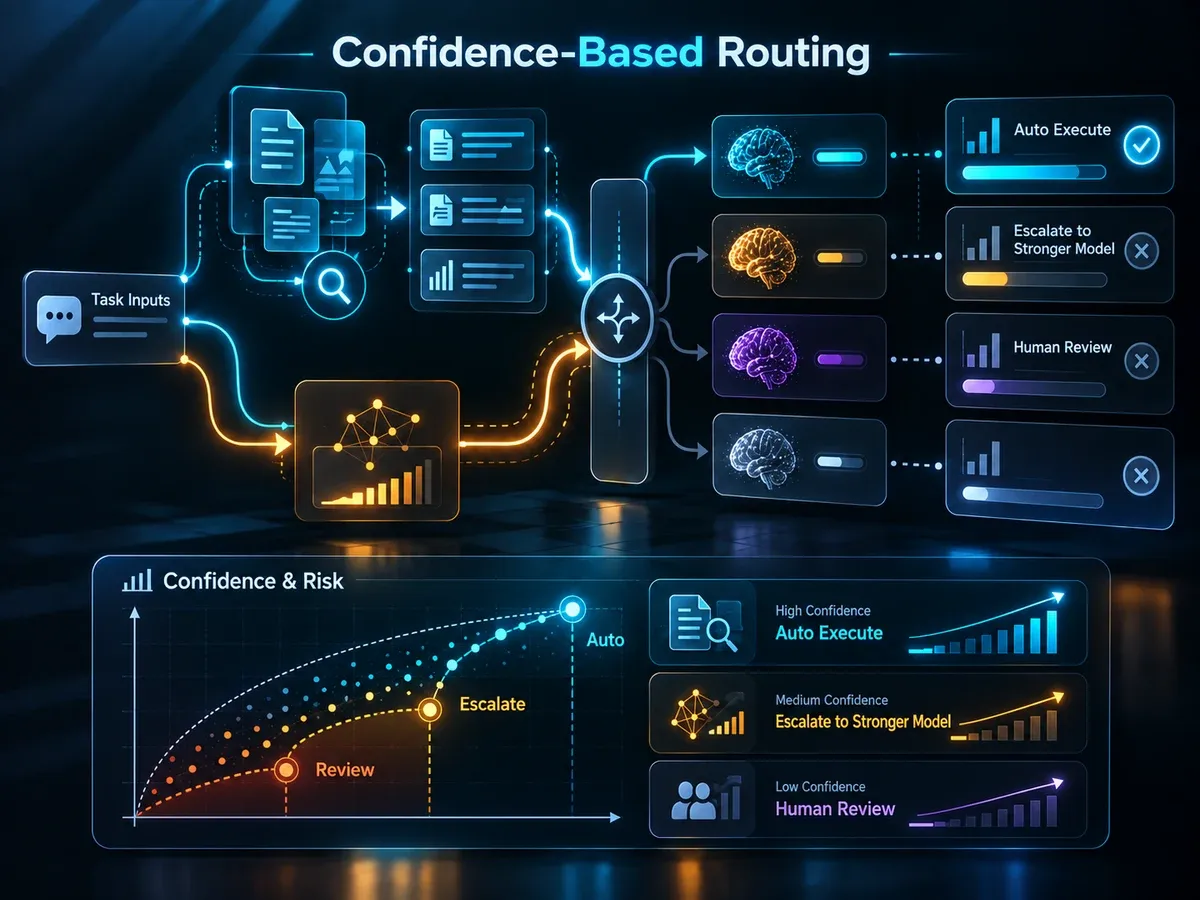
前面的 Tool Risk benchmark 里,错误样本的 confidence 整体低于最容易的正确样本,而且作者报告的 Jev ECE 约为 0.05–0.07。不过 60 条样本非常小,且 0.9–1.0 的高置信度区间占了绝大多数样本。作者自己也提醒,容易样本会让 confidence 看起来“过于完美”。
生产系统至少要做到两点。
第一,阈值必须按任务和错误成本来定。邮件分类错一次和删除生产 namespace 错一次,不应该共享同一个 confidence threshold。
第二,阈值必须用自己的标注集校准。至少要加入 clear、ambiguous、adversarial wording、边界输入、多语言、真实历史失败样本和高风险少数类,然后看 reliability、ECE/Brier、false positive/false negative,而不是只看总体 accuracy。
对于 Tool Gate,我更关心的是“危险调用被判成安全的比例”,而不是“总体准确率 95% 看起来很高”。
成本优势是真机会,但不要把厂商倍率直接带进预算
TypeSafe 官方当前公开的是每百万输入 token $0.042,输出不单独计费。这个价格非常适合高频控制面调用,因为路由、评分和 gate 往往会在每一轮 Agent loop 出现。
但“比 frontier LLM 便宜多少倍”必须谨慎。TypeSafe 发布材料给出了非常高的效率倍率;独立 Tool Risk benchmark 在它自己的 one-shot 场景里测到的则更克制:Jev 约 3.25–3.62 倍更快、约 40.6 倍更便宜。两边不必然矛盾,因为厂商比较的是自己定义的 System One workflow,而第三方测的是单次分类;但它们说明:倍率高度依赖任务口径。
对真实 Agent,应该算的是一次最终成功任务的总成本:
决策调用
+ 生成模型调用
+ 工具调用
+ 重试
+ fallback
+ 人工复核
+ 错误路由造成的返工
因此 XBSTACK 后续真正该测的 KPI 不是“Jev 单次 API 多少钱”,而是 cost per verified task、routing regret、false-safe rate、fallback rate、p50/p95 decision latency、end-to-end task success 和 manual review rate。
不生成解释既是优势,也是限制
Jev 不生成长解释,这在控制面里是优势:响应更小、不需要解析自然语言理由、不容易让“看起来合理的解释”掩盖错误分类,也更容易把模型当成一个纯函数。
但在审计、客服、风控、企业审批里,用户经常需要知道“为什么”。这时更合理的设计不是让 Jev 再生成一段理由,而是把决策、证据、授权和解释拆开。
Jev:
  decision = privileged
  probability = 0.87

Policy/Trace:
  matched_resource = prod-db
  operation = port-forward
  identity_scope = read-only
  policy = human_approval_required

Optional LLM explanation:
  根据 trace 生成给人的说明
真正可审计的理由来自输入 state、规则命中、资源权限和 Trace;LLM 只负责把证据翻译成人能读懂的说明。这也是我认为 Jev 更适合“控制层”而不是“业务最终裁决者”的原因。
Jev 现在最值得测试的三个真实任务
如果获得 TypeSafe API 权限,我会优先用三个 XBSTACK 能复核的真实任务,而不是跑几十道干净分类题。
任务一:真实 Agent 模型路由。 从 XBSTACK 已有开发/运营任务抽取真实请求,人工标注 deterministic/no-LLM、cheap model、strong model 三档,然后统一比较 hard rules、zero-shot classifier、Jev、cheap LLM、Jev + retrieval evidence。最终不能只看分类一致率,还要让候选模型真正执行任务,计算 routing regret 和 cost per successful task。
任务二:Tool Gate。 直接复用 XBSTACK 的 MCP / Agent Security 场景,混合 filesystem read、git status、package install、production delete、credential access、outbound upload、database migration、publish/deploy。重点测 false-safe,而不是平均 accuracy。高风险样本必须设置 hard policy 对照。
任务三:Confidence Fallback。 故意加入模糊、冲突、缺字段和 adversarial wording,比较 Jev only、Jev → LLM fallback、Jev → Human fallback,验证 confidence 是否真的能把容易任务留在低成本路径,同时把难样本升级出去。
只有这三组数据跑出来,我才会把本文从“可用性判断”升级成“XBSTACK 实测”。
最终决策:Jev 值得进评测栈,但不值得直接进生产授权链
截至 2026 年 9 月 25 日,Jev 值得优先测试的场景包括高频模型路由、Agent skill/worker 选择、Tool Call 风险分类、工单/事件分类、候选评分、低成本 loop evaluator,以及有明确 fallback 的自动化决策。
不应该直接交给 Jev 的场景包括权限和合规 hard policy、不可逆生产写入、转账/支付/删除/发布等高后果动作、需要长解释或复杂计划的任务、固定标签且已有高质量本地 classifier 的成熟流程,以及不能把数据发给第三方 API 的场景。
如果你的系统今天已经用一个大模型做大量简单路由,Jev 很值得进 A/B;如果你的规则系统已经稳定解决绝大多数判断,没必要为了追新模型重写架构;如果你真正的问题是模型不知道业务历史,应该先做 retrieval 和 evaluation,因为现有 routing benchmark 已经证明,证据层可能比 difficulty model 更重要。
所以这篇文章当前的最终结论是:
Jev 最值得看的不是“它能不能替代 GPT/Claude”,而是它有没有资格成为 Agent 的概率决策原语。现有公开证据已经足以证明这个方向值得测试,但还不足以证明 Jev 应该默认接管模型路由或 Tool Gate。更合理的生产位置,是 Hard Rules 之后、生成式 LLM/Human fallback 之前。
等 XBSTACK 拿到 API 权限,下一步直接在这篇文章上补真实 fixtures、日志、延迟、成本、失败样本和 routing regret,把判断升级成可以复算的工程证据。
FAQ
Jev AI 是什么?
Jev 是 TypeSafe AI 于 2026 年 9 月 15 日发布的 System One Model。它面向结构化决策而不是开放文本生成:应用提供 state 与预定义问题,模型返回 Choice、Score 或 Noul 等结果及概率。
Jev 和 JSON mode / structured output 有什么区别?
JSON mode 通常仍建立在生成式 LLM 上,只是把输出约束为 JSON。Jev 从模型和 API 层围绕有限、typed、probabilistic decisions 设计。工程上最重要的区别不是格式,而是它不承担长文本生成任务。
Jev 可以做 LLM model routing 吗?
可以作为一个信号源,但不能默认优于规则或 retrieval。公开 routing experiment 中,带 Jev difficulty signal 的方案和 no-Jev retrieval ablation 几乎相同,说明是否有增量必须通过消融实验确认。
Jev 的 confidence 能直接控制 Tool 执行吗?
不建议。confidence 可以决定是否升级到更强模型或人工,但权限、资源范围和高风险写入仍应由独立 Policy Engine/审批流程控制。模型判断不能替代授权。
Jev 比 Claude/GPT 便宜多少?
TypeSafe 当前公开价是 $0.042 / 1M input token,output free。第三方 Tool Risk benchmark 在其特定 60 条 one-shot 分类任务里测到 Jev 约 40.6 倍更便宜于其 Claude Sonnet 5 对照;这个倍率不能直接外推到其他任务。
XBSTACK 已经实测 Jev 了吗?
还没有。当前本机没有配置 TypeSafe API Key。本文引用的 benchmark 都明确标注为第三方结果。正式实测会使用 XBSTACK 自己的 Agent routing、Tool Gate 与 confidence fallback 数据集。
参考资料
- TypeSafe AI:Introducing System One Models & Jev
- TypeSafe AI API Docs
- TypeSafe AI 官网与当前价格
- Microsoft Agent Framework:Jev / Decision Client Python 提案
- Microsoft Agent Framework:Decision Model .NET 提案
- Independent: Agent Tool-Call Risk Benchmark
- Independent: Jev Routing Experiment / RouterArena
- Independent: Jev vs LLM / BERT / zero-shot NLI
继续阅读
- AI Agent 生产化治理:模型路由、权限、成本与回滚
- AI Agent Deployment:任务队列、状态持久化、模型路由与高并发部署
- AI Agent 工具授权与 Policy Gate
- Multi-Agent Systems:Supervisor、Worker 与模型路由
从单个 Agent 问题继续进入完整生产体系
AI Agent 专题统一组织架构、记忆、工具调用、评测、安全、部署和多智能体协作,让每篇文章都回到明确的主题主页面。
继续阅读
返回专题 →AI 工程周报
只发真正改变工程判断的变化、故障、实验和新资产。
参与讨论
问题、验证与勘误
登录后可发表评论。所有新评论先进入审核;审核期间仅评论者本人和管理员可见,通过后才公开。