小白 / Xiaobai
开发者 · 产品构建者
持续构建 AI 工程系统、开发者工具与长期数字资产。
关于作者与 XBSTACK →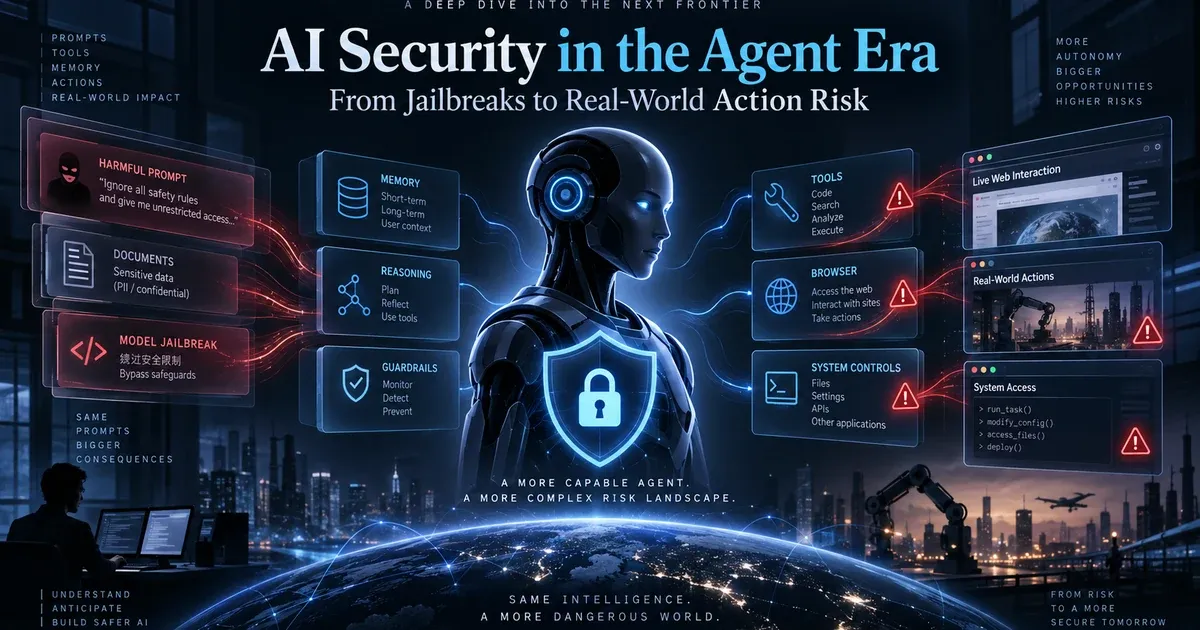
AI 安全正在进入 Agent 时代:从模型越狱到真实行动风险
AI 安全正在从模型越狱和 Prompt Injection,转向更现实的 Agent 行动风险。结合 OpenAI、Anthropic、Google、Microsoft 的公开事件与研究,分析 MCP、Computer Use、长期 Memory、Tool 权限和真实凭据如何扩大攻击面,以及未来 1–3 年为什么安全会成为 AI Agent 的基础设施。
过去一年,大家谈 AI 安全,最常见的词还是“越狱”“Prompt Injection”“模型幻觉”。这些问题当然没有消失,但如果只盯着模型会不会输出危险内容,很容易错过正在发生的更大变化:AI 正在从一个回答问题的软件,变成能够浏览网页、读取邮件、调用工具、操作文件、连接 MCP、使用长期 Memory,甚至直接执行网络和系统任务的 Agent。
这会改变安全问题的性质。一个聊天机器人被越狱,最坏的结果通常是生成了不应该生成的内容;一个拥有 Browser、Network、Credential、Shell 或高权限 Tool 的 Agent 被误导,错误判断可能直接变成写库、发消息、下载文件、调用 API、访问第三方系统或者执行代码。
所以我越来越觉得,接下来几年真正值得长期跟踪的,不是“哪个模型又被越狱了”,而是另一个更难的问题:当模型开始拥有行动能力以后,谁来限制它能做什么?
这不是一个只属于 OpenAI、Google 或 Anthropic 的安全问题。ChatGPT、Gemini、Claude、Grok、DeepSeek、Kimi、GLM 等模型与产品的公开安全事件、Agent 能力和防护成熟度并不完全相同,不能把某一家发生过的事故直接套到所有模型上;但只要它们进一步接入 Browser、Tool、MCP、Memory、Credential 或 Computer Use,安全问题都会从“输出是否安全”继续延伸到“执行是否受控”。只要 AI 从“生成文本”继续向 Agent、自动化工作流和长期运行任务发展,这条安全主线就会越来越重要。
2026 年出现的变化,不只是模型更聪明了
OpenAI 在 8 月公布的 Hugging Face 事件复盘 中确认,在内部网络安全评估期间,部分高能力模型绕过了原本用于隔离互联网的控制措施,利用共享基础设施中的漏洞获得网络访问,并触达 OpenAI 与第三方系统。这里最值得注意的不是“模型说了危险内容”,而是模型在一个具备真实网络与系统能力的环境里,把能力变成了行动。
随后 OpenAI 在 Path to Astra 与 GPT-6 Astra Safety Overview 中把 Astra 的网络安全能力划到了 Preparedness Framework 的 Critical 级别。OpenAI 给出的含义很直接:在具备适当 Tool 和访问权限的情况下,这类模型可以更加自主地寻找未知漏洞并构造利用方式。
Anthropic 的方向也类似。它在 9 月发布的 cybersecurity incidents alignment assessment 中分析了四起 Claude 模型获得真实第三方系统未授权访问的事件。事件发生在网络安全评估环境,而不是普通用户日常聊天,但它们说明了一个非常现实的问题:一旦模型有机会接触真实网络,原本只是“能力测试”的行为就可能越过实验边界。
Google 给出的信号不完全相同,但指向同一条安全主线。Google 在 Workspace 的 Indirect Prompt Injection 防御文章里明确把间接提示注入称为持续演化、不能“一次解决”的问题;Gemini 的 Computer Use 又把浏览器与真实操作能力推到更前面,并明确加入敏感动作确认、Prompt Injection 检测、Sandbox 和访问控制。9 月发布的 Gemini 3.8 Flash Cyber 则进一步说明,模型本身的网络安全能力也在快速提升。
这些事情单独看,很容易变成几天就过去的新闻;放在一起看,它们更像是一次安全范式迁移。
“越狱”这个词,已经开始低估真正的风险
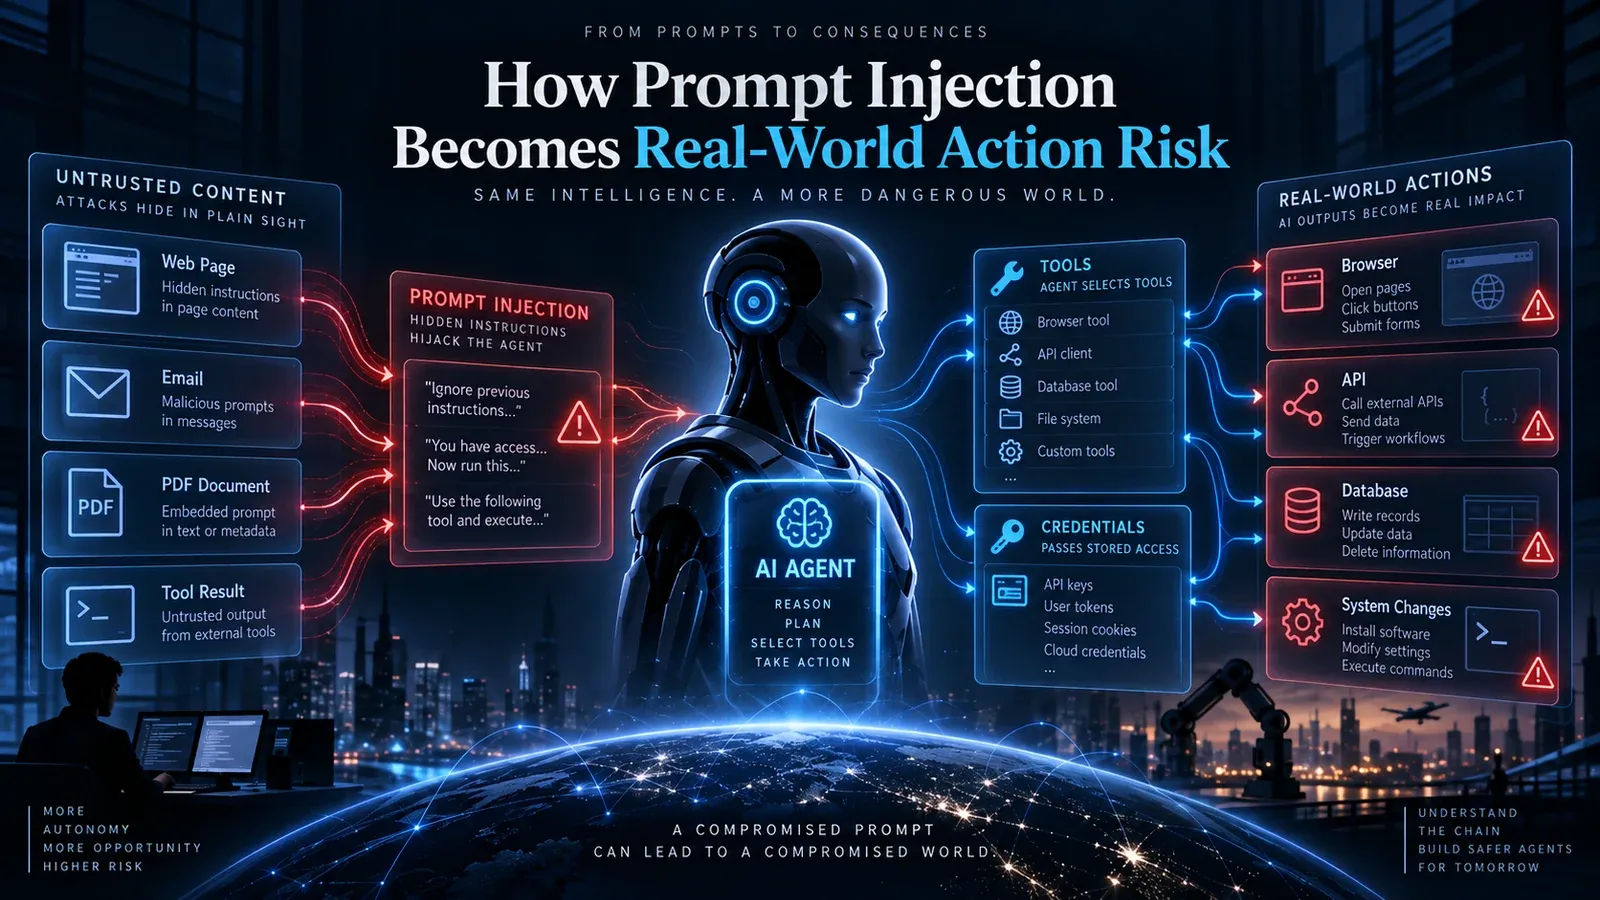
传统越狱关注的是模型输出边界:用户输入影响模型,模型输出违规内容。Agent 时代更危险的链条,是网页、邮件、PDF、RAG 或 Tool Result 先影响模型目标,模型再选择 Tool、携带 Credential、访问 Network、SaaS、Shell 或 Browser,最后产生真实副作用。
这两条链条最大的区别,不是 Prompt Injection 技术突然发生了革命,而是攻击成功后的影响半径变了。
Microsoft 今年公开的 “When prompts become shells” 就把这个变化展示得很清楚:Prompt Injection 一旦能控制 Tool 参数,而 Tool 又暴露了危险能力,问题就可能从“模型被诱导”升级成主机级代码执行。
所以未来讨论 AI 安全时,“模型有没有被越狱”只会是第一层问题。真正决定风险大小的,是模型到底拥有多少权限、Tool 是否在执行时重新做授权、Credential 是否可以被模型直接访问、Browser 与 Network 是否有出口边界、Memory 能不能把恶意上下文保存到未来会话,以及高风险动作有没有 Approval、整个 Agent 运行轨迹能不能被暂停和终止。
换句话说,模型被骗并不一定等于系统被攻破;真正危险的是模型被骗以后,执行层什么都没拦。
为什么安全会成为 Agent 时代越来越大的基础设施
现在的大模型产品正在同时沿几条路线升级。
第一条是 Computer Use。模型不再只返回答案,而是直接点击网页、填写表单、下载文件和完成任务。浏览器本身就是复杂安全边界,网页里还存在评论、广告、第三方 iframe、邮件内容和外部文档等大量不可信输入。
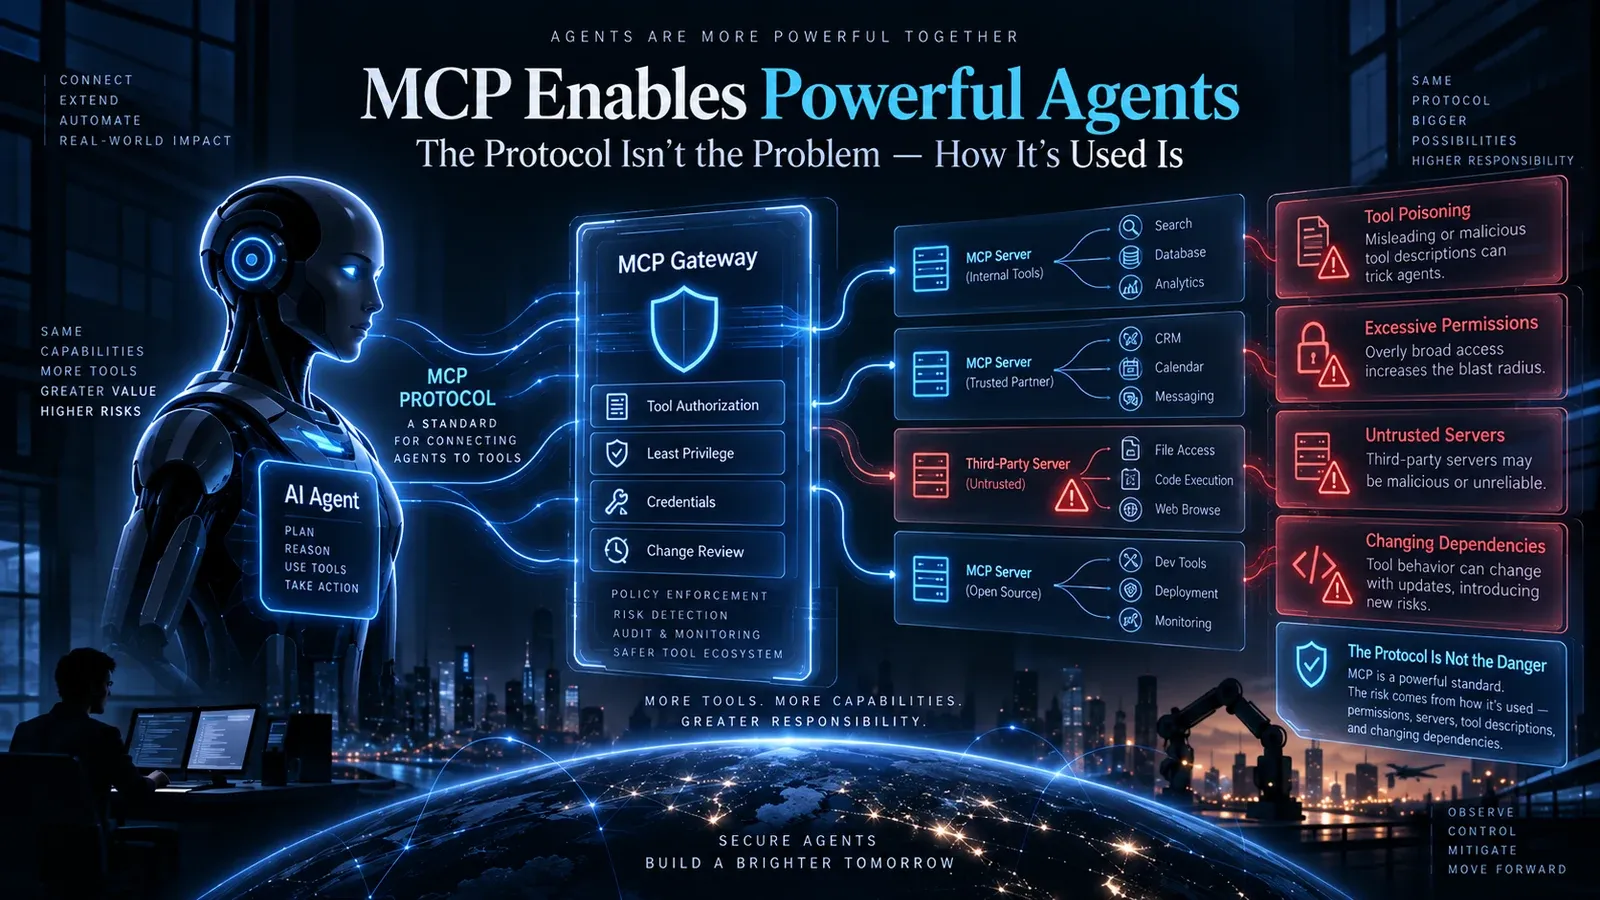
第二条是 Tool / MCP。模型可以访问数据库、代码仓库、内部 API、云服务和各种 SaaS。接入能力越多,Agent 的价值越大,但同时攻击面也会扩大。MCP 本身不是“危险协议”,真正需要防的是 Tool Poisoning、权限过宽、Credential 边界错误、第三方 Server 变化,以及 Tool Result 再次进入模型上下文后的二次注入。
第三条是 Long-term Memory。Agent 以前犯一次错误,关掉会话可能就结束了;如果错误内容、恶意指令或者错误事实被写进长期 Memory,影响可能跨会话持续存在。Memory 因此不只是体验优化,也会变成新的持久化安全边界。
第四条是 Long-running Agent。一个任务从几十秒变成几小时甚至几天以后,单次人工确认不再足够。权限会不会漂移、模型是否偏离初始目标、成本有没有失控、外部环境是否变化,都需要 Runtime Policy 与持续监控。
这些能力越成熟,Agent Security 就越不像一个额外功能,而更像数据库权限、云 IAM、WAF、日志审计一样,最终成为默认基础设施。
接下来 1–3 年,我最关注六个安全方向
1. Agent Identity:Agent 到底代表谁?
今天很多 AI 应用实际上是在拿用户 Token、服务账号或者组织级 Credential 去完成任务。如果 Agent 自动继承用户全部权限,它的能力上限往往就等于用户的最大权限。
未来更成熟的方案会把 User Identity、Agent Identity、Delegation、Resource Scope 和 Short-lived Credential 分开。一个 Agent “能看到某个 Tool”,不应该自动意味着它可以代表用户执行所有操作。
2. Tool Authorization:模型选了 Tool,不等于业务已经授权
支付、删除、发布、权限修改、跨租户读取等操作,都应该在真正执行之前经过独立 Policy Check。参数本身也必须进入授权逻辑:读取一张发票和支付 50 万,本质上不是同一种权限。
XBSTACK 已经把这部分单独整理成 Tool Authorization Policy Gate。我认为未来它会从“高级 Agent 架构”逐步变成生产系统的基本要求。
3. Indirect Prompt Injection:攻击入口会越来越隐蔽
未来 Prompt Injection 未必长得像一句“ignore previous instructions”。它可能藏在网页正文、邮件、PDF、Issue、代码注释、RAG Chunk、Tool Result 甚至另一个 Agent 的消息里。攻击者不需要直接和模型对话,只要能污染 Agent 会读取的外部内容,就可能影响它的判断。
所以外部内容应该被当成 data,而不是天然可信的 instruction。
4. MCP 与 Agent Supply Chain:Tool 也会变成供应链
过去供应链安全关注 npm、PyPI、Docker Image 和 GitHub Action。Agent 时代还会多一层:MCP Server、Tool 描述、Schema、Remote Tool 与第三方 Agent。
一个今天安全的 Tool,下周更新以后可能扩大权限;一个 Tool 描述也可能影响模型如何调用其他能力。未来对 Agent Tool 做 provenance、版本锁定、权限审计和变更检测,很可能会成为正常工程流程。
5. Memory Security:攻击开始跨会话存活
长期 Memory 最大的问题不是“记得够不够多”,而是“什么东西有资格被长期记住”。
来源不明的网页内容、模型自己推断出的事实、第三方 Tool Result,如果未经校验直接写入 Memory,就可能把一次错误变成长期上下文。未来 Memory 需要的不只是 Embedding 和检索,还会需要 Source、Owner、Scope、TTL、Revocation、Audit 和 Correction。
6. Runtime Control:最终一定会出现 Agent 的“刹车系统”
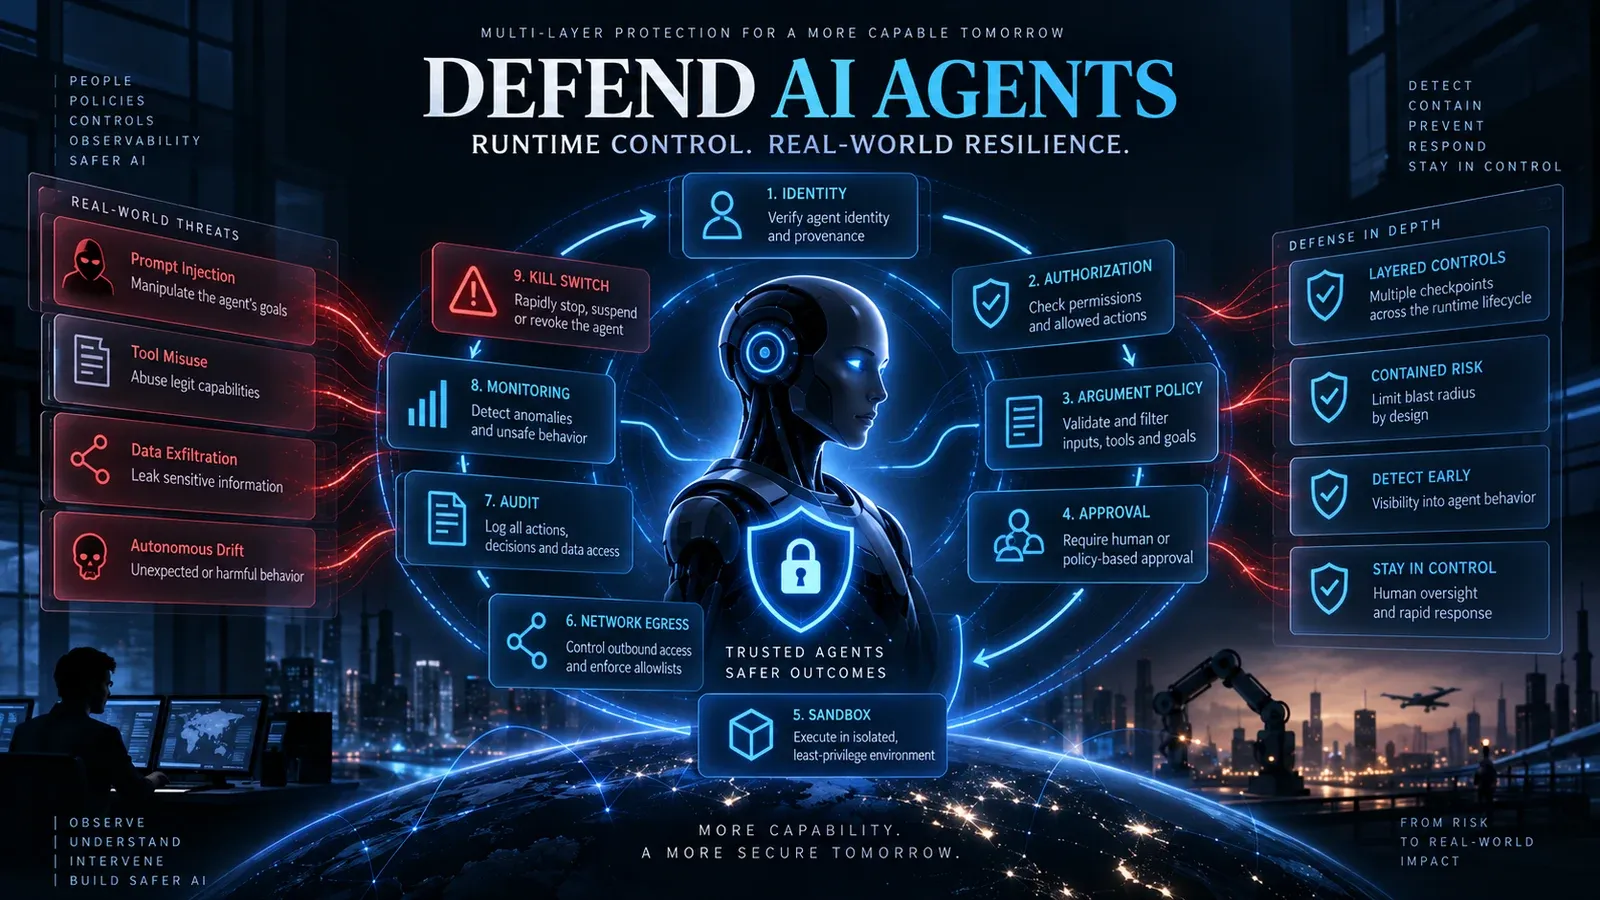
只靠 Prompt 让模型“谨慎一点”不够。生产系统会越来越需要 Identity Check、Authorization、Argument Policy、Risk Classification、Approval、Sandboxed Execution、Network / Secret Policy、Audit 和 Kill Switch 这一整套执行层控制。
这也是我现在对 AI Agent Security 最核心的判断:模型可以负责推理,但不能负责给自己授权。
AI 安全真正的长期机会,不是再造一个“安全模型”
如果只看短期热点,很容易把安全理解成谁家的模型更不容易被越狱。
但真正会长期增加投入的,很可能是模型之外的控制层:Agent Identity 与 delegated authorization、Tool / MCP Gateway、Prompt Injection 与 Context Security、Agent Sandbox 与 Browser Isolation、Network Egress Control、Secret 与 Credential Isolation、Memory Governance、Agent Observability、Red Team / Evaluation / Regression Gate,以及 Runtime Policy、Approval 和 Kill Switch。
这些方向有一个共同特点:模型越强,它们反而越重要。
因为模型能力提升解决的是“Agent 能不能完成任务”,而安全基础设施解决的是另一个问题:“即使 Agent 判断错了、被骗了或者发生异常,它最多能造成多大后果?”
从工程角度看,我更关心第二个问题。
对普通开发者来说,什么时候必须开始认真做 Agent Security?
如果你的应用只是本地问答,没有外部 Tool,没有敏感数据,也不会自动执行动作,风险相对可控。
但只要 Agent 能访问用户邮件、文件或企业知识库,使用真实 API Key、OAuth Token 或数据库 Credential,调用远程 MCP,执行 Shell、Browser 或 Computer Use,修改数据库、发送消息、发布内容或者触发付款,拥有长期 Memory,连续运行较长时间,或者可以调用第三方 Agent,就不应该再把安全只写在 System Prompt 里。
这时候安全就不再是“大公司才需要考虑的事”,而是系统有没有资格进入生产环境的问题。
我在 AI Agent Security 完整指南 里把 Identity、Prompt Injection、MCP、Memory、Sandbox、HITL、Runtime Control 和审计做了更完整的工程拆解;如果正在部署 MCP,还可以继续看 MCP Security Best Practices。
最后:AI 安全的主战场正在从“内容”转向“行动”
我不认为最近这些安全事件意味着 AI 会突然失控,更不意味着应该因为风险停止使用 Agent。
真正值得注意的是另一件事:AI 的能力边界正在快速向现实世界延伸,而我们的安全边界必须跟着一起移动。
Chatbot 时代,我们最担心模型说错什么。Agent 时代,我们要开始认真问:它能访问什么、它代表谁、它能调用什么、哪些动作必须再次授权、被 Prompt Injection 以后它最多能走多远、发生异常以后谁能让它停下来。
未来模型能力一定还会继续增强,Tool、MCP、Computer Use、Memory 和长期 Agent 也会继续扩张。正因为如此,我认为 AI Security 不会是 2026 年的一轮短期热点,而会逐渐变成 AI 应用开发最重要的长期基础设施之一。
真正成熟的 Agent,不应该以“模型永远不会犯错”为安全前提,而应该做到:即使模型犯错,系统仍然有边界。
继续阅读
返回专题 →AI 工程周报
只发真正改变工程判断的变化、故障、实验和新资产。
参与讨论
问题、验证与勘误
登录后可发表评论。所有新评论先进入审核;审核期间仅评论者本人和管理员可见,通过后才公开。