小白 / Xiaobai
开发者 · 产品构建者
持续构建 AI 工程系统、开发者工具与长期数字资产。
关于作者与 XBSTACK →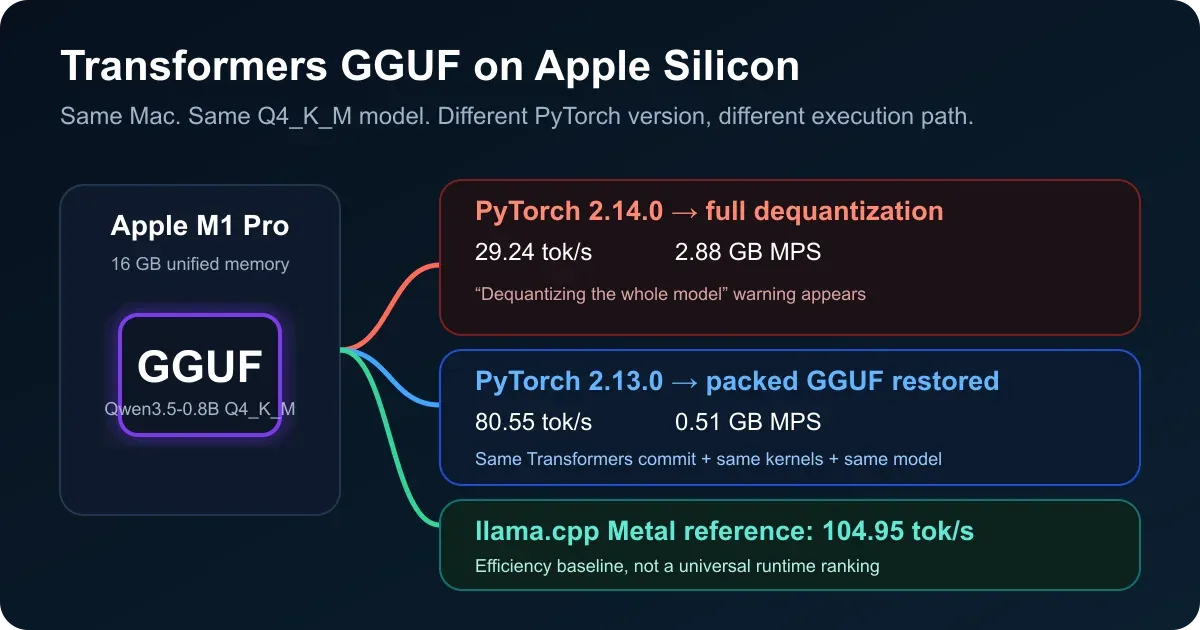
Transformers 跑 GGUF 出现 “Dequantizing the whole model” 怎么解决?PyTorch 版本实测
Transformers 直接加载 GGUF 时出现 Dequantizing the whole model / no GGUF matmul kernel 警告怎么办?本文在 M1 Pro 上用同一 Qwen3.5 Q4_K_M 对比 PyTorch 2.14、2.13 与 llama.cpp,给出验证方法、版本兼容根因和修复方案。
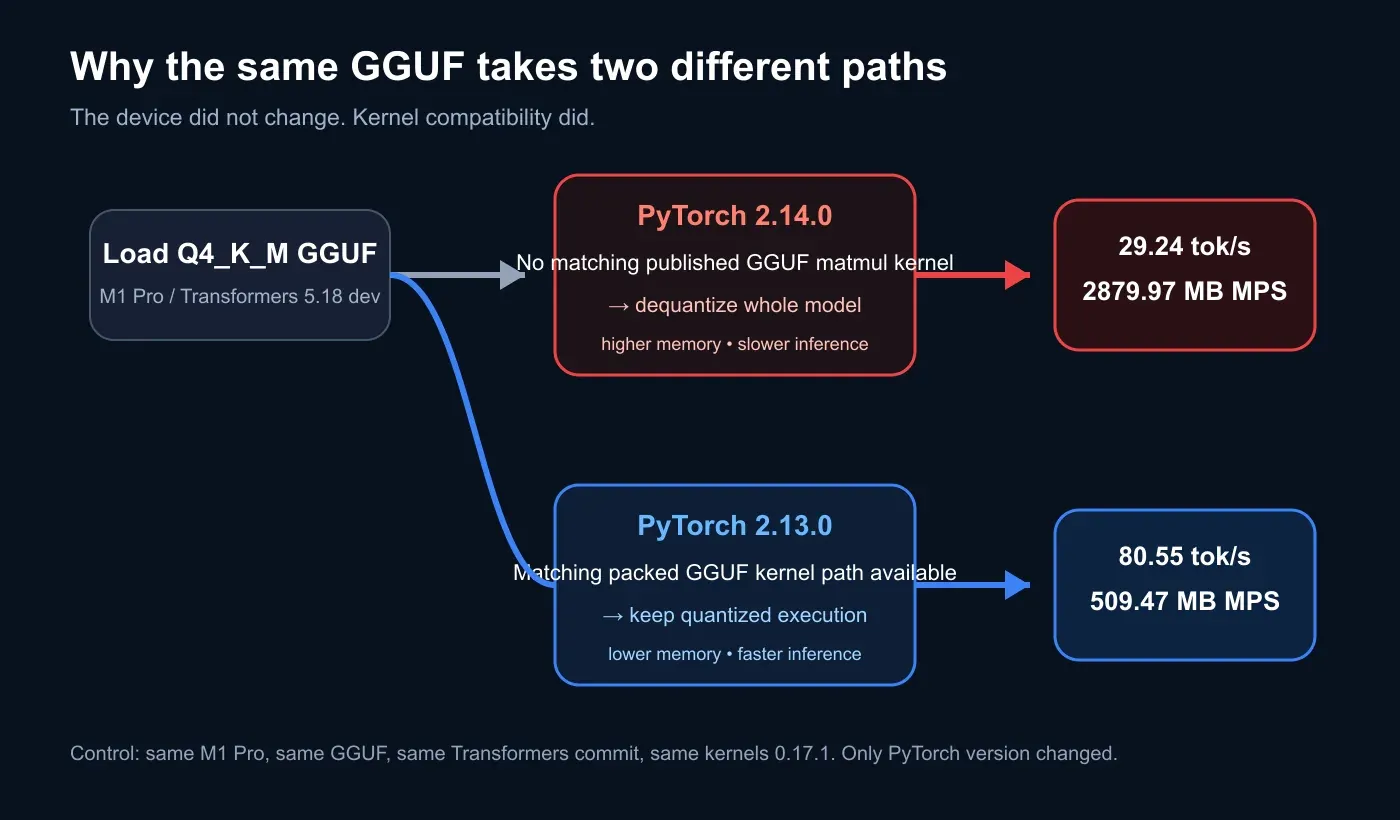
如果 Transformers 加载 GGUF 时出现 Dequantizing the whole model, because no GGUF matmul kernel is published for this device,先不要把它理解成“这台 Mac 不支持 GGUF”。 这个警告表示当前环境没有命中可用的 GGUF matmul kernel,Transformers 会退回到整模型反量化路径。最快验证办法是检查 PyTorch 与已发布 kernel 是否匹配:本站在同一台 M1 Pro 上,PyTorch 2.14.0 会触发这个警告,而改为 2.13.0 后警告消失。临时方案是切到已验证兼容的 PyTorch;正式方案是按 Hugging Face 当前 kernel 支持矩阵锁定版本并做回归测试。如果你只追求本地推理效率,llama.cpp 仍然更直接。
这不是从文档推出来的结论。2026 年 9 月 26 日,我在一台 Apple M1 Pro、16GB 统一内存、macOS 26.6.2 的机器上,用同一个 Qwen3.5-0.8B Q4_K_M GGUF 跑了三组对照:Transformers + PyTorch 2.14.0、Transformers + PyTorch 2.13.0,以及 llama.cpp 的 Python binding + Metal GPU offload。
先看结果:问题不在 M1 Pro,而在版本兼容
| 路径 | PyTorch | 是否保持 packed GGUF | 模型加载 | 128-token 生成中位速度 | 测得 MPS 当前分配 |
|---|---|---|---|---|---|
| Transformers | 2.14.0 | 否,整模型反量化 | 9.08s | 29.24 tok/s | 2879.97 MB |
| Transformers | 2.13.0 | 是 | 8.60s | 80.55 tok/s | 509.47 MB |
| llama.cpp binding | — | 原生 GGUF | 0.43s | 104.95 tok/s | — |
只把 PyTorch 从 2.14.0 换成 2.13.0,其他关键条件不变,Transformers 的中位生成速度从 29.24 提升到 80.55 tok/s,约 2.75 倍;测得的 MPS 当前分配从约 2.88 GB 降到 0.51 GB,下降约 82.3%。
更关键的是:2.13.0 组里,完整反量化警告不再出现。
因此这次实验能排除一个很容易下错的结论:至少在这组环境里,不能把这个 warning 直接解释成“M1 Pro 太老,所以不支持 Transformers GGUF”。 同一台机器只改 PyTorch 版本,就恢复了 packed GGUF 路径。
这个 warning 到底是什么意思?
Hugging Face 在 2026 年 9 月把 llama.cpp 的量化模型执行能力接进 Transformers,核心不是把 GGUF 先恢复成普通高精度权重再运行,而是让支持的量化矩阵乘法通过 kernels 与 ggml 后端直接执行。
这也是为什么下面这行 warning 很重要:
Dequantizing the whole model, because no GGUF matmul kernel is published for this device.
It will need several times the memory the file does, and load more slowly.
它不是普通提示。它明确说明当前没有命中预期的量化 matmul kernel,于是 Transformers 选择把整个模型反量化。
结果会直接体现在两个地方:
- 内存优势大幅缩水。 你下载的是 Q4 GGUF,不代表运行时仍保持 Q4 的权重形态。
- 速度明显下降。 量化 kernel 没跑起来之后,执行路径已经不是你以为的 packed GGUF。
Hugging Face 官方文档也强调,使用这条新路径需要匹配有已发布 kernel build 的 PyTorch/设备组合。所谓“支持 Apple Silicon”,并不等于“任意未来版 PyTorch 都会立刻有对应 kernel”。
最快怎么确认是不是版本问题?
先记录环境,不要直接重装一堆包:
python -c "import torch, transformers, kernels; print(torch.__version__); print(transformers.__version__); print(kernels.__version__)"
然后重新加载一次 GGUF,看日志里有没有完整反量化 warning。
如果有,下一步应该查 当前 Hugging Face ggml quantization kernel 实际支持哪些 PyTorch 版本,而不是先换模型、换 Mac、换 GGUF 文件。
本站这次用的控制组是:
Apple M1 Pro / 16 GB
macOS 26.6.2
Python 3.10.2
Transformers 5.18.0.dev0
kernels 0.17.1

失败组:PyTorch 2.14.0
成功组:PyTorch 2.13.0
GGUF:Qwen3.5-0.8B Q4_K_M
在这个时间点,2.13.0 能命中 packed GGUF,而 2.14.0 会回退到整模型反量化。
修复:不要永久死锁 2.13,要锁“被 kernel 支持的版本”
如果你现在遇到完全相同的错误,在复现本站环境时可以先用隔离环境验证:
python -m venv .venv
.venv/bin/python -m pip install "torch==2.13.0"
.venv/bin/python -m pip install accelerate kernels "git+https://github.com/huggingface/transformers.git"
然后用原来的 gguf_file 再加载一次。
但这里要特别强调:torch==2.13.0 是 2026-09-26 这次实验的已验证版本,不是一个应该永远复制的神奇版本号。
真正长期有效的修法是:
- 查看当前 Hugging Face GGUF/ggml kernel 支持的 PyTorch build;
- 在项目里锁定一个实际有 kernel 的版本;
- 跑一次最小加载测试;
- 确认完整反量化 warning 消失;
- 再跑你自己的延迟、内存和输出正确性回归;
- 等 kernel 支持新 PyTorch 后再升级,而不是“框架最新版优先”。
这比简单写一句“pip install torch==2.13”更重要,因为半年后兼容窗口完全可能已经移动。
warning 消失了,为什么日志里还会有其他 fallback?
PyTorch 2.13.0 组里,整模型反量化 warning 已经消失,但 Qwen3.5 仍出现过其他提示,例如部分 causal_conv1d、chunk_gated_delta_rule、fused_recurrent_gated_delta_rule 没有命中优化实现,退回 reference PyTorch。
这两个层级不要混为一谈。
整模型反量化意味着最核心的 GGUF 权重执行路径没有命中;而个别算子 fallback意味着 packed GGUF 已经恢复,但模型里的某些算子仍没有专用优化 kernel。
我们的数字也印证了这个区别:即使还有部分算子 fallback,2.13.0 组已经从约 29 tok/s 恢复到约 81 tok/s。
修好以后,Transformers 和 llama.cpp 还差多少?
同一台机器、同一个 GGUF,我们还用 llama-cpp-python 0.3.35 跑了一组 Metal GPU offload。
中位生成速度:
- Transformers + PyTorch 2.13:80.55 tok/s
- llama.cpp binding:104.95 tok/s
在这组 0.8B、每次固定生成 128 token 的测试里,llama.cpp 约快 1.30 倍。
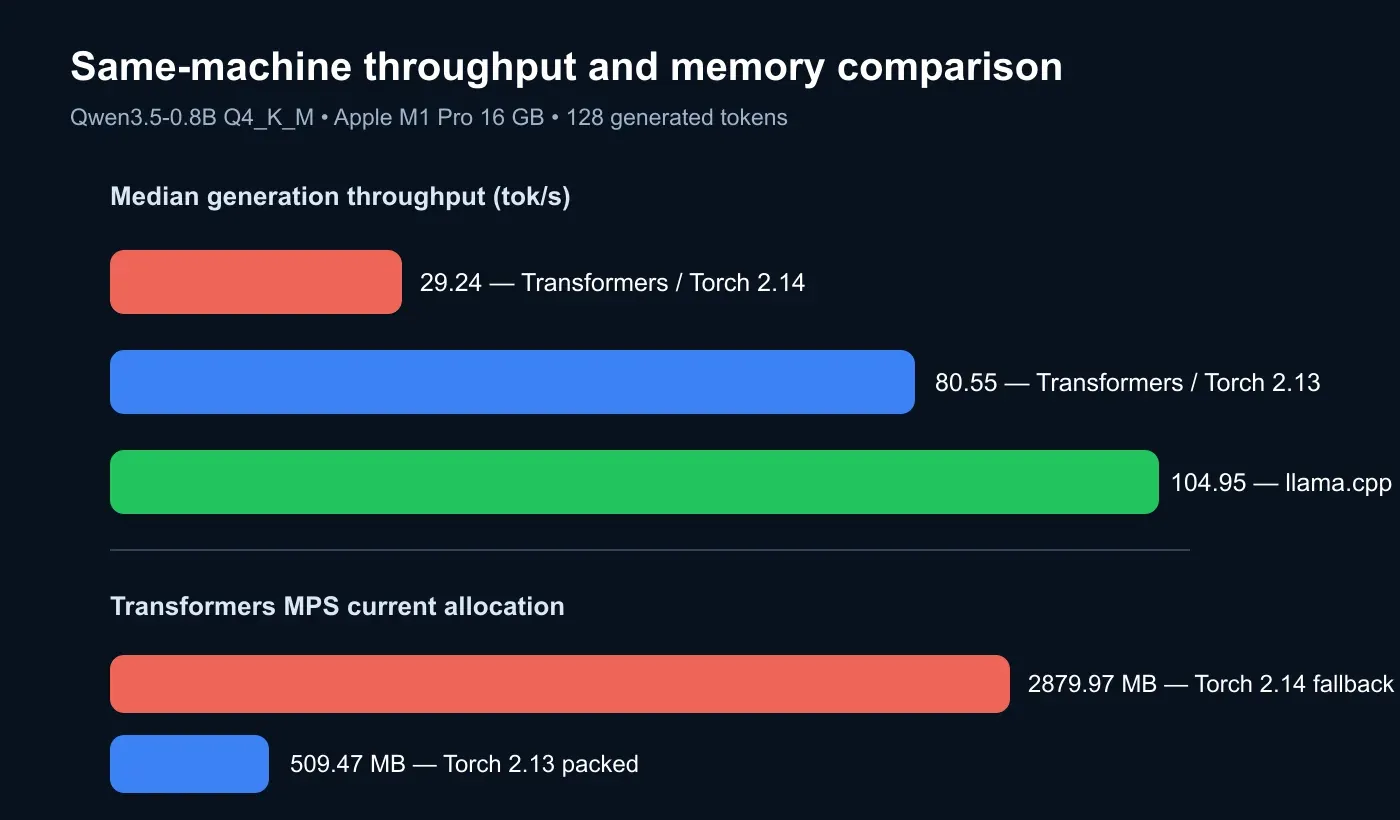
这个数字不能外推成“llama.cpp 永远快 30%”。模型大小、量化类型、上下文长度、batch、设备代际、kernel 覆盖都会改变结果。而且 Hugging Face 官方文章里的 llama.cpp 数字来自 llama-bench,与本站“包含 prompt processing 的端到端 Python 调用”不是同一种统计口径,所以我没有把两组表直接拼在一起比较。
真正有用的结论是:
- 如果你已经在 Transformers 生态里,需要
generate()、processor、现有 Python pipeline 或继续微调,新的 GGUF 路径很有价值; - 如果目标是纯本地推理效率、低加载开销和成熟 GGUF 支持,llama.cpp 仍然更自然;
- 如果 Transformers 突然比预期慢很多,第一件事不是换模型,而是确认它有没有悄悄进入整模型反量化。
我是怎么测的?
为了避免把官方 benchmark 冒充本站数据,这组结果使用独立本地实验。
固定条件:
- 同一台 M1 Pro 16GB;
- 同一个 Qwen3.5-0.8B Q4_K_M 文件;
- Transformers 两组保持同一 commit、同一
kernels 0.17.1; - 只切换 PyTorch 2.14.0 与 2.13.0;
- llama.cpp 使用同一 GGUF;
- 每个后端先 warm-up;
- 之后用 3 个不同短 prompt;
- 每次固定生成 128 token;
- 取 3 次生成速度中位数;
- Transformers 额外记录 MPS current allocated memory。
这不是模型质量 benchmark,也不是跨设备性能排行榜。它只回答一个很具体的问题:
这个完整反量化 warning 到底是不是实际性能问题,以及同一台 Mac 上换到匹配 kernel 的 PyTorch 后会发生什么?
答案是:会,而且差异足够大,不应该忽略。
什么时候不适用这个修法?
不要在下面几种情况里机械降级 PyTorch:
- 日志根本没有完整反量化 warning;
- 你跑的量化类型本身不在当前 Transformers packed kernel 支持范围;
- 你的设备不是 Apple Silicon;
- 你的业务依赖 PyTorch 2.14 新特性,不能为了一个推理路径整体降级;
- 你真正需要的是服务端高吞吐,此时应该比较 vLLM/SGLang/llama.cpp 等其他运行时;
- Hugging Face 后续已经发布了支持新 PyTorch 的 kernel。
版本 pin 是验证方法,不是架构信仰。
FAQ
为什么明明是 Q4_K_M,内存还是突然变高?
因为 GGUF 文件的量化格式和运行时实际执行路径不是一回事。没有命中对应 matmul kernel 时,Transformers 可能反量化整个模型,运行时内存就会显著高于 GGUF 文件大小给你的直觉。
M1/M2/M3 都应该固定 PyTorch 2.13 吗?
不应该。本站只证明 M1 Pro 上这组 2026-09-26 环境中 2.13 可用、2.14 会回退。长期应该跟随 Hugging Face 已发布 kernel 的支持范围。
怎么判断修复已经生效?
最直接的是完整反量化 warning 消失。再用同一 prompt 做一次速度和 MPS 内存对照,避免“日志没报错但实际上换了别的问题”。
Transformers 修好以后可以完全替代 llama.cpp 吗?
取决于目的。本站这次修复后 Transformers 已经从约 29 tok/s 提升到约 81 tok/s,但 llama.cpp binding 同机仍约 105 tok/s。Transformers 的优势更多在生态和统一 API,llama.cpp 的优势仍在成熟高效的本地 GGUF 推理。
相关实测
如果你关心的不只是这一条 GGUF warning,而是“本地/运行时兼容问题应该怎么做控制实验”,可以继续看:
- AI Tools Lab:XBSTACK 的真实项目实验与故障复现
- n8n distroless 在 ARM64 / Apple Silicon 上的 glibc 兼容故障复现
- Codex response.failed + SSE idle timeout:同机同 fixture 的运行时边界测试
参考与证据
- Hugging Face:Transformers now runs llama.cpp quants
- Transformers:GGUF quantization documentation
- 独立复现:note.com — Transformers GGUF / PyTorch compatibility
- 独立复现:Takuya GenAI — Transformers GGUF guide
本站原始实验保存在 experiments/transformers-gguf-dequantization-repro/,公开版本矩阵、原始 JSON 与复现步骤已发布到 xbstack/transformers-gguf-dequantization-repro。
继续阅读
返回专题 →AI 工程周报
只发真正改变工程判断的变化、故障、实验和新资产。
参与讨论
问题、验证与勘误
登录后可发表评论。所有新评论先进入审核;审核期间仅评论者本人和管理员可见,通过后才公开。