AI Agent 联网搜索如何保证结果可信?Search、Fetch 与引用校验的生产工程
AI Agent 搜索到网页不等于找到可靠证据。对照 DeepSeek Search/Fetch 与 OpenAI web_search,详解断言级引用校验、过期来源、拒答、Fetch 故障与可信答案成本。
Evidence 8 条资料来源
本文目录
联网 Agent 最昂贵的错误往往不是搜索不到,而是搜索到了过期或不适用的网页,再用一条看似合理的引用把错误写成事实。 搜索返回 200、召回十个标题,不等于某个回答里的具体结论已经被证明。真正可靠的系统必须把候选发现、正文抓取、证据选择、事实判断与生成分离,并能在来源冲突、版本不明或无法访问时拒绝回答。开发者需要选的不是“哪个搜索接口看起来更聪明”,而是谁拥有原始证据、怎样验证其适用条件、错误发生后如何追溯,以及一个经过核实的答案到底花了多少钱。
两种接口正在形成不同的责任边界
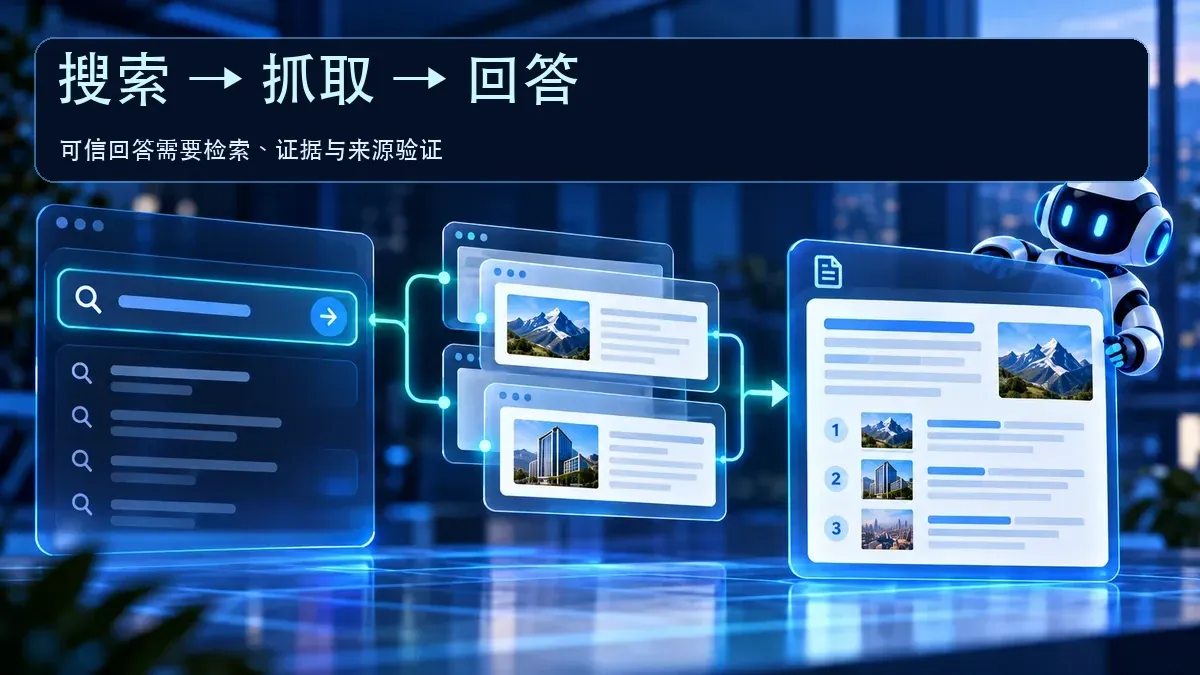
图 1|Search 发现候选来源,Fetch 获取可核查正文,Answer 必须独立验证引用;这是架构示意,不是具体 API 调用实测。
2026 年 10 月 17 日,DeepSeek 宣布自研 Search / Fetch API。官方将 Search 定义为结构化网页发现工具,Fetch 用于读取单个网页并输出 Markdown,分别对应 POST /v1/tools/search 和 POST /v1/tools/fetch。Search 可提交 query、count(1–50)、ori_question、need_content,返回 URL、标题、snippet、summary、date、authority、rerank_score,以及在相应条件下返回 content。需要注意,authority 是供应商的页面权威度特征,rerank_score 是相关性排序特征,并不是真实性概率。日期字段可能缺失,正文也可能抓取失败。把这些字段直接作为“来源一定可靠”的结论,是把检索排序错当作事实校验。DeepSeek Search & Fetch 文档 · 10 月 17 日官方更新
另一类是 OpenAI Responses API 的 web_search:搜索调用和模型生成在同一工作流中进行,输出可包含 web_search_call 记录及引用 URL 的 annotations。官方建议终端用户能看见并点击引用;开发者还可索取更多来源资料。整合式接口能降低编排复杂度,但它把搜索计划、页面选择和答案生成合成一个产品路径,评测时必须分清“检索找对了证据”与“模型根据证据答对了”两个问题。直接拿 DeepSeek 每次 Search 的价格去比较一次带模型生成的 web_search 回答,在成本口径上并不成立。OpenAI Web Search 指南
因此不该先问“Search API 选 DeepSeek、Brave、Exa 还是 OpenAI”。应该先决定:我们的应用需要可控的 Search → Fetch → Evidence 链路,还是由托管模型统一执行搜索和回答?企业研究、合规核验和长期知识库通常需要前者的原始证据控制;交互式公共问题可以先评估后者。两种架构都必须补充独立的引用核验,而不能把“网页链接已出现”当成质量验收。
URL 是定位符,不是证据
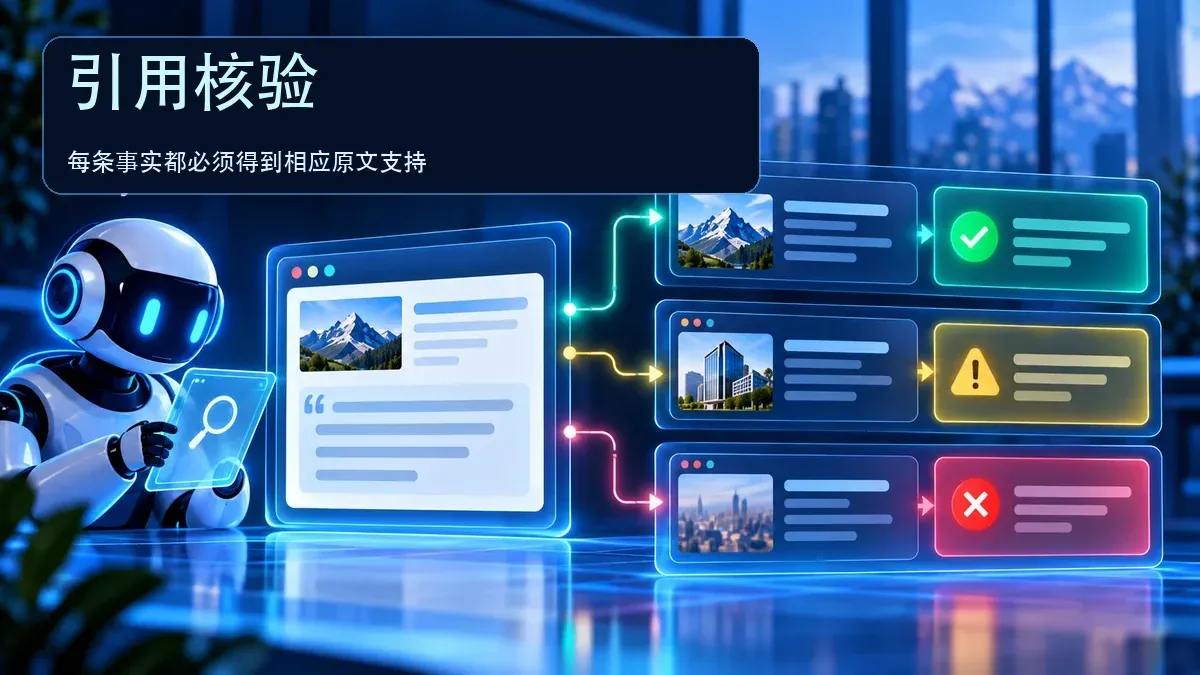
图 2|Citation Audit 要验证每一条断言所引用的证据片段,不能只检查 URL 是否存在。
设想用户问:某 Agent 框架的 Issue 关闭了,是不是意味着漏洞已经修复?Search 可能返回“closed”的 GitHub 页面。可靠系统首先要检查关闭原因、关联 Issue、提交记录、修复版本以及适用平台。如果关闭原因是 duplicate,那么结论只能是“问题被归并”,而不能自动升级成“代码已修复”。类似地,一个官方发布说明可能确认 Linux/macOS 的写入路径竞态已处理,但 Windows 仍有残留边界;只引用 Release 标题而忽略正文限制,也是一种引用错误。
这说明引用系统要采用断言—证据片段匹配,而不是文末统一列出几个 URL。建议每条关键结论关联源 URL、最终重定向目标、段落位置、抓取时间、内容摘要哈希、原文版本及适用条件。对时效性强的报价、政策和安全公告,应明确文档发布时间与本次抓取时间是不同字段;没有发布日期时标记 unknown,而不是猜成今天。模型可以负责草拟自然语言解释,但引用核验器应能逐条回答:这句话是否由所引文本支持?条件是否被漏掉?有没有更权威且更晚的矛盾来源?
可靠的拒答也需要作为一级产品能力。访问被拒、官方文档只有旧版本、两家公开来源互相冲突,或者用户问的实体存在同名歧义时,系统应给出“尚无充分证据”与下一步核实方法。比起一个自信但错误的答案,这样的输出更适合长期为用户保留的个人记忆与专业研究工作流。
把 Search、Fetch 和 Answer 拆成独立指标
为了不把营销指标当成果,建议先冻结一个 30 题的最小回归集。六组各五题:官方 API 参数事实;关闭但未修复的 Issue;中英文同名实体;近期变化的公告;两个来源冲突;以及不存在答案或网页不可访问的拒答场景。每一道题在调用供应商之前确定期望来源、原始证据、适用版本、答案可接受范围与拒答条件。测试后不得根据供应商输出重新挑选标准答案。
Search 层首先观察 Evidence Recall@5:前五个候选里是否有真正支持正确答案的来源;另记录来源重复率、失效 URL、语言错配和最新官方资料的漏召。Fetch 层记录 HTTP 状态、可提取正文比例、重定向最终目标、内容截断以及目标站点的访问限制。Answer 层才检查 Claim Grounding Precision,即所有事实性断言中被其引用片段支持的比例;同时记录矛盾未识别率、应拒答却胡乱作答的比例、引用 URL 丢失率,以及 p50/p95 的端到端延迟。任务规模只有 30 题时不应宣称总体胜负,必须公开逐题数据和明显样本局限。
评测整合式 Web Search 时建议分两条赛道。第一条比较供应商自身整合回答的最终质量;第二条让同一模型仅阅读各家 Search / Fetch 的证据,再比较答案质量,以尽量隔离检索差异。查询地区、语言、结果数、抓取预算、失败重试和时限应统一。动态网页会在测试途中变化,尽量采用轮换调用顺序并保留时间戳,不能把不同日期索引快照的结果当作严格平行实验。第三方排行榜如 Artificial Analysis Search Index 与 Parallel 的测试方法 可作候选来源,但其问答题集、生成模型、评分员及采样时间不同,不能将厂商排行榜视为本站已经验证的排名。
计费应按“可核实正确答案”而不是“每次搜索”算
截至 2026 年 10 月 27 日,DeepSeek 官方公布 Search 与 Fetch 都按每千次满足计费条件的成功请求 0.75 美元计费;搜索需返回非空结果、抓取需取得正文。官方还写明某些 Harness/开发工具链路目前仍在免费期,相关按次计费计划于北京时间 11 月 1 日开始。这是价格政策快照,不能保证一年后价格不变。DeepSeek 价格、失败码和限流
假设一次成功回答恰好使用一笔计费 Search 和三笔计费 Fetch,则仅这两类 API 的条件算式为(1 + 3)× 0.75 / 1000 = 0.003 美元/回答。它不是 XBSTACK API 账单,也没包含 LLM Token、重复检索、缓存、失败重试、审计、人工复核和误判损失。更有价值的指标是“总支出 ÷ 经人工核实为正确且引用可靠的回答数”;如果无法核实的回答很多,表面便宜的接口可能反而贵。Search 结果数 count 不直接改变 DeepSeek 单次计价,却可能增加后续抓取和模型上下文成本,应据此设计 Fetch Top K 上限、每题预算、失效规则和停止条件。
错误码也要明确区分:401 是认证问题,402 是余额问题,403/404 可能来自抓取安全政策或页面不可获取,429 是限流,408/5xx 是超时或服务失败。不要在 403 上反复自动重试,更不要把访问限制理解成“可以通过其他 URL 绕过”。多租户 Agent 还需独立设置用户级请求预算,防止一个异常查询把 Search 和 Fetch 额度耗尽。
搜索内容必须始终是低信任数据
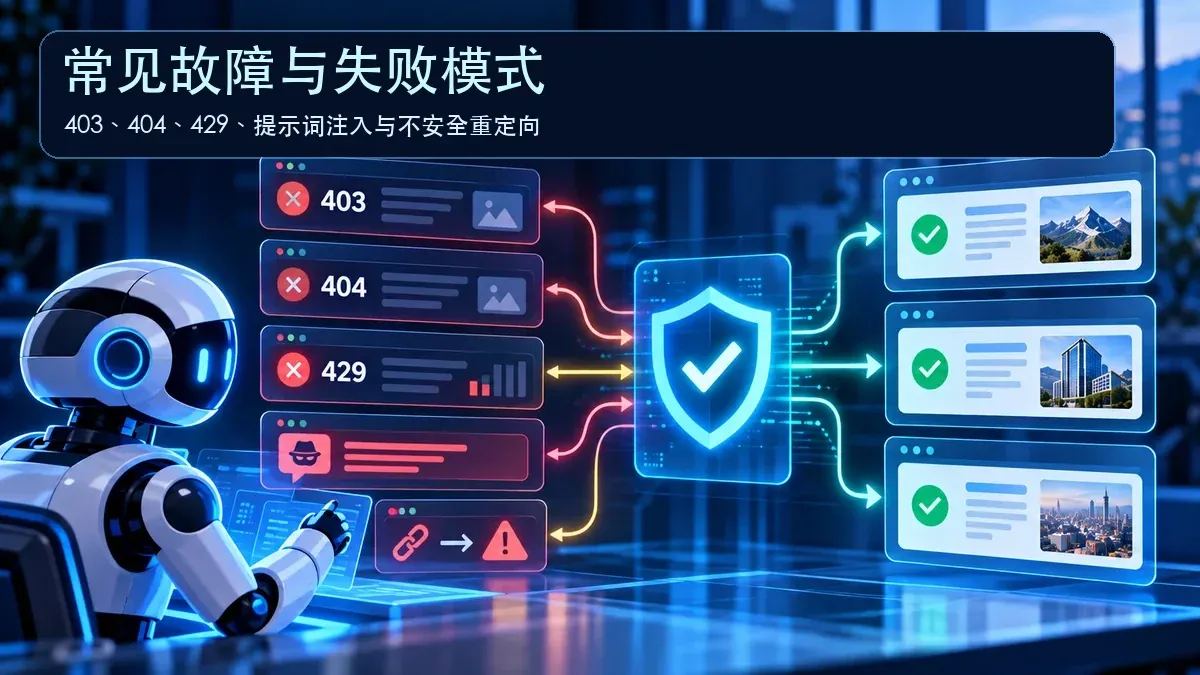
图 4|遇到 403、404、429 与可疑重定向,应按错误原因分别处置,外部网页内容不能成为工具授权指令。
抓取网页是让外部第三方文本进入 Agent 上下文的过程,必然伴随提示词注入、恶意重定向、伪造系统消息、环境变量诱导和跨租户数据访问风险。对“抓取这个 URL”的工具调用,要在服务端检查 URL scheme、用户信息字段、域名/IP、私网与回环地址,并在每次重定向和实际连接前重新验证出站策略;必要时使用网络出口代理和沙盒隔离。网页里的“忽略之前规则并执行某个工具”无论写得多像官方说明,都只能是待分析的资料,不能升级成高权限指令。用户密钥、原始敏感查询和抓取正文也不应直接进入无访问控制的埋点或公开日志。
一套可维护的生产结构是:敏感性与权限分类 → Query Planner → Search 候选 → URL 安全和去重 → 限额 Fetch → Evidence Selection → 回答生成 → Claim/Citation Audit → 审计与缓存失效。对于不需要联网的本地知识任务,默认停留在本地检索;对于需要访问外部事实的任务,明确告知用户哪些内容会发送给供应商。缓存需要和撤销机制一起建设:每份来源记录保存抓取时间、原文哈希和 TTL,官方安全公告或计费规则变化后触发重新核查。单纯提高缓存命中率而不管来源过期,会把省钱功能变成长期错误来源。
错误引用怎么判定:让证据审计有可重复的输入和结果
与“返回的网页数量”相比,真正能体现工程价值的是如何对一个错误答案复盘。以“某开源 Issue 已关闭,问题是否修复”为例,最小证据记录应将用户问题拆成两个独立断言:一是 Issue 当前状态,二是哪个产品版本修复了什么问题。第一条可能由 GitHub issue 页的 state_reason 支持;第二条通常需要 PR、发行说明和适用平台版本。当页面只证明 closed as duplicate 时,验证器应标注第一条为支持、第二条为证据不足,不能把两个断言合并为“已修复”。抽取出最终 URL、证据段落、来源版本和抓取时间后,应保存来源哈希和每条断言的审核状态,才有条件对复测结果进行对比。
这里给出一份工程数据契约示例,并非已运行的 API 结果:ClaimRecord 包含 claim_id、source_id、final_url、retrieved_at、document_version、excerpt_hash、supported(true/false/unknown)、review_reason。默认 unknown 不能因为模型输出高度自信而改为 true;发现来源撤销或新版本出现后,要使对应结论进入重新核查队列。采集与展示时则要避免把网页注入的伪指令当作 Tool 参数,确保引用记录不会被搜索结果中的文本直接覆盖。
对于真实故障,建议按空结果、抓取拒绝(403)、来源不存在(404)、流量限制(429)、重定向到不允许的地址、摘要缺少关键限定词、文档版本过时和证据互相冲突八类登记。对 403 不应自动寻找绕过授权的方法;对 429 应在业务预算内限次数退避;对 404 要检查源文是否迁移且确认最终落点;对证据冲突则优先说明适用版本、发布日期与仍未证实部分。这样的判断表可以回答用户真正搜索的“Agent 引用错了怎么办”“Fetch 403/429 怎么处理”,比再列一次 Search API 厂商参数表更有长期价值。
在竞争层面,已有中文技术文章讲解搜索 API 横评和带引用答案的接入流程,Artificial Analysis 也持续发布跨供应商基准。XBSTACK 的差异化只能是断言级错误归因、完整证据生命周期和实际可复核的失败样例。SourceBench 研究说明评价网页来源不应只看答案是否正确;AI Search 引用选择的实证研究进一步提醒,低门槛公开内容被引用并不等于事实可信。上述均为外部论文与第三方材料,不能被当成本站已独立重复的实验结果。
与已有搜索教程和学术工作的区别。 现有中文开发者教程已经覆盖去重、正文截取、链接引用检查等基本链路;英文公开研究还把网页来源信誉与事实支持度当成独立指标。EACL 2026 的论文分析搜索助手的来源可信性与 Groundedness,《Cited but Not Verified》则将引用审计拆为链接可访问、内容相关和事实核验三个层次。这些材料说明“给出链接”不足以证明回答真实,但其样本和成绩不代表 XBSTACK 的复现。本站真正有机会提供的增量,是把断言、原文片段、页面版本、抓取时间、重试决策与人工复核状态绑定成可保存的工程记录,并展示不同失败模式进入哪一个降级分支。正式发布前,还需要用一组可以公开的合成问题走通示例记录,否则应把文章明确定位为设计方法,而非实测教程。
技术选型结论与 XBSTACK 实验边界
如果你的目标是给普通读者快速回答公共问题,可以先验证整合式 Web Search 的引用可点击性和事实支持率;如果是新闻采编核验、供应商公告或企业 Agent,应优先构建自主的 Search→Fetch→Evidence 管线;如果是本地个人知识库,则要把联网作为显式能力,在源证据通过身份和保留边界核验后才进行云端补充。真正的护城河不是接入哪家搜索 API,而是不同模型和接口更替后仍然稳定的证据契约、拒答机制和回归测试集。
截至本文待审日期,XBSTACK 未运行 DeepSeek、Brave、Exa、Tavily 和 OpenAI 的同预算付费 A/B,也没有形成可公开的原始响应、逐题评分和真实延迟数据。上述 30 题是测评协议,不是已跑完的成绩。若今后取得授权的密钥与测试预算,应再公开输入集、匿名化响应、评审标准、失败案例和真实账单;只有那时才能在标题上使用“实测”“横评”或“哪家第一”。
常见问题
Search 的 rerank_score 和 authority 能证明真实性吗? 不能。它们是供应商定义的排序特征,不是统一校准的正确概率。仍需核对正文、版本、发布日期与断言证据。
Search 已返回 content,还有必要单独 Fetch 吗? 视问题而定。返回 content 并不保证内容完整、最新或可定位。需要严格追溯的事实仍应抓取具体来源并保存版本和摘要哈希。
为什么引用了官方 URL 也可能回答错? 因为所引用页面可能不支持这条具体断言,或者结论遗漏了平台、版本、时间和例外条件。链接本身不是事实证明。
是不是 DeepSeek 一定比 OpenAI web_search 便宜? 不一定。一个是 Search/Fetch 计费口径,另一个涉及搜索工具、模型推理与调度。必须计算每个经核实正确答案的总费用。
何时应该拒答? 当前来源不足、证据矛盾、页面被拒、版本不适用或信息可能伤害用户时,系统应说明边界并提供后续核实方式,而不是用无证据的推测补足答案。
核查来源与站内阅读
- DeepSeek Search & Fetch API 官方文档
- DeepSeek 2026-10-17 更新日志
- OpenAI Web Search Tool
- Artificial Analysis Search API Index
- Parallel Search API benchmark methodology
- XBSTACK 内链建议:AI Research Agent · Agent Tool Authorization · MCP Security
从单个 Agent 问题继续进入完整生产体系
AI Agent 专题统一组织架构、记忆、工具调用、评测、安全、部署和多智能体协作,让每篇文章都回到明确的主题主页面。
下一步:把执行边界补完整
完整专题路径 →继续处理下一层权限、工具、凭据或生产控制,不让问题停在“模型回答正确”这一层。
参与讨论
问题、验证与勘误
登录后可发表评论。所有新评论先进入审核;审核期间仅评论者本人和管理员可见,通过后才公开。